Mac跑本地AI慢?真正瓶颈不是芯片而是缓存

Mac本地AI慢的元凶是缓存失效而非芯片,应先查日志再升级硬件。
文章通过一位开发者用顶配M5 Max跑Agent八小时仅完成15处修改的案例,指出Mac本地AI慢的根源被长期误判为内存带宽不足。实际上,本地推理分为Pre-Fill读取和Decode写入两个阶段,Agent工作流主要由Pre-Fill主导,而常见计数器只显示Decode速度。前缀缓存失效可导致首Token延迟飙升数十倍,远超芯片升级带来的收益。缓存失效的常见原因包括Cloud Code归属头Bug、Ollama上下文窗口默认值过低、模型内部混合层检查点机制、前端工具缓存策略差异以及思考Token处理不当。芯片的真正价值在于降低单次冷启动读取的成本,而缓存决定需要支付多少次冷启动。文章最后给出五条不花钱的排查清单,强调先查日志再考虑硬件升级。
很多人以为Mac上跑本地AI慢是芯片性能不够,内存带宽不足。但Reddit上一位开发者的经历推翻了这个认知:他用顶配M5 Max芯片、128GB统一内存的MacBook Pro运行一个编程Agent,花了8个小时只对一个HTML文件做了大约15处修改,平均每处修改耗时半小时。奇怪的是,模型输出的文字质量很好,屏幕上的生成速度看起来也正常,直到他打开日志才发现有一行字在反复刷屏——「由于缺少缓存数据,强制重新处理完整提示词」。
这个案例指向一个被长期忽视的事实:我们一直盯着错误的地方看。
内存带宽只解释了生成阶段
在YouTube上搜索「为什么Mac上本地AI慢」,几乎每个视频都会提到内存带宽。这个逻辑本身没错:模型每生成一个新Token,都需要从内存中读取整个模型权重。以Quinn 3.8 27B模型为例,4bit量化下大约需要17GB空间;Mac mini M6的内存带宽是每秒170GB,大概能跑出每秒10个Token;M5 Max达到每秒614GB,速度约为前者的3.5倍。
M5这一代还在每个GPU核心里塞进了矩阵加速单元。据Lamado的CPPP基准测试,从M4 Max到M5 Max,读取提示词的速度大约快了3倍半。这些提升是实打实的。
但那位每天工作8小时的开发者两者都有——每秒614GB带宽、每个核心都有加速单元——却花了一整个工作日才完成15次编辑。显然,问题不在带宽。
Pre-Fill和Decode:两个被混为一谈的阶段
本地AI推理其实分两个完全不同的阶段:Pre-Fill(读取)和Decode(写入)。你在LM Studio或Ollama里盯着的那个每秒Token数,只测量了Decode,也就是模型写新词的速度。但在第一个字出现之前,模型必须把你发过去的所有内容完整读一遍——系统提示词、附带的文件、整个对话历史。这个读取阶段有它自己的速度瓶颈,而且可能比写入阶段慢得多。
在普通聊天窗口里,我们打几百个字,读取只花零点几秒,没人会注意。Agent工作流则完全是另一回事。
一位开发者在3月用MEMAX做的测量很能说明问题:LM Studio显示每秒57个Token,但当加载了8500个Token的对话上下文、从按下回车到出现第一个字,实际速度只有每秒3个Token。读取过程吃掉了94%的等待时间,实际体验比计数器显示的慢了19倍。
YouTube上几乎所有基准测试都在测Decode,但我们实际运行的Agent工作流,主导阶段是Pre-Fill。这彻底重构了每个购买决策和每一步故障排查。
Prefix Caching(前缀缓存) 是大模型推理服务中的一项关键优化技术。其原理是:当新请求的提示词开头与之前某个请求的提示词完全一致时,服务器可以直接复用之前计算好的键值缓存(KV Cache),跳过对这些相同部分的重复计算,只处理新增的尾部内容。在本地推理场景(如LM Studio、Ollama、llama.cpp)中,前缀缓存通常以“对话轮次”为单位生效——只要新一轮请求的文本前缀与上一轮完全一致,就能命中缓存。然而,一旦提示词开头出现任何变化(哪怕只是一个空格或时间戳),后续所有内容的缓存都会失效,服务器必须从零开始重新计算整个提示词。对于动辄数万Token的Agent上下文,这种“缓存未命中”会导致首Token延迟从几秒飙升到几分钟,是本地AI体验断崖式下降的隐形元凶。
缓存失效:让慢变成灾难的隐形杀手
Prefix Caching(前缀缓存)是服务器记住已读内容的能力。下一个请求如果以上次相同的文本开头,它就不重读那些,直接跳到末尾的新内容。在Mac上,这决定了能用还是彻底坏掉。
一位开发者9月贴出的日志极具冲击力:M5 Pro配64GB运行Q1 3.8 27B模型,某一时刻上下文达158000 tokens,其中157600在缓存中,仅400个新token,首次6.1秒出现。几轮之后上下文增长到188000 tokens,但缓存只匹配了147000个,迫使服务器重读大约41000 tokens,第一个字花了268秒。同一台Mac、同一个模型、同一次会话,唯一的区别是提示词开头是否还和服务器已缓存的内容匹配,速度差了44倍。
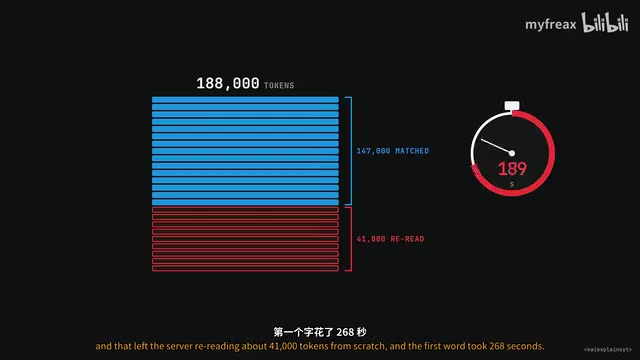
从M5 Pro升级到M5 Max,内存带宽翻倍以上,这是实打实的提升。但一旦缓存失效,代价是44倍——没有任何芯片升级能弥补这个差距。
缓存是怎么悄悄失效的
答案出奇地平淡:不是硬件限制,而是软件决策、工具选择和配置问题。
归属头Bug。Cloud Code曾在系统提示词顶部放了一小段每次请求都会变化的文本。Anthropic自己的服务器知道在缓存前剥离它,但Cloud Code指向本地服务器时不知道,于是每一轮整个缓存都失效。社区发现将环境变量设为0可解决,该帖子获46000浏览、传至4种语言,设置指南至今警告这是本地推理慢90%的头号原因。Cloud Code 6月2.1版已修复,但9月仍有人报告Agent运行需30分钟。
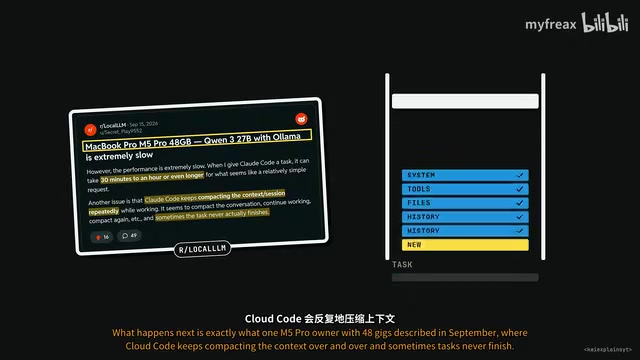
Ollama上下文窗口默认值。Ollama根据GPU可见的内存量决定上下文空间:24GB以下为4000 Token,24到48GB之间为32000,超过48GB为256000。Mac上GPU看不到全部内存,macOS只允许使用约36GB,落在32000 Token这一档。而Cloud Code第一个请求在你输入前就要消耗约33000 Token,绝大部分是工具描述——Agent还没被要求做事,上下文窗口就满了。接下来就是反复压缩上下文,而全新的压缩提示词意味着每次都是完全的冷启动读取。Ollama官方Cloud Code文档建议将上下文设为64000或更高,默认值只有它的一半。
模型内部的混合层。一些长上下文模型(如QWIN 235B A22B)约四分之三的层使用类似滚动摘要的技术,无法回退到任意点,服务器只能保存每隔数千Token一次的检查点。如果新提示词与缓存分叉处附近没有检查点,就必须从零重启。那个8小时的日志里,逐轮报告的内容正是这种情况。
前端工具的选择。5月份有人测试OpenClaw广告和Hermes两个Agent前端,指向相同服务器、运行相同模型,Hermes缓存正常,OpenClaw的缓存Token数为0——不是少几个,是0,因为该工具构建请求的方式保证了缓存永不命中。同一台Mac、同一个服务器、同一个模型,仅仅因为前端不同,实际性能天差地别。
思考Token的处理。一些工具会在下一轮之前剥离模型的思考Token以保持上下文干净,这听起来合理,但会改变对话历史并导致缓存失效。Queen默认保留27B模型的思考内容,官方文档指出这有助于缓存,但很多工具并不遵守。
KV Cache(键值缓存) 是Transformer模型推理时的核心内存结构。在自回归生成过程中,模型每生成一个Token,都需要关注之前所有Token的键(Key)和值(Value)向量。为了避免重复计算,推理框架会将这些向量缓存起来,后续生成时直接复用。KV Cache的大小与上下文长度、模型层数、注意力头数密切相关,在长上下文Agent场景中可能占用数GB显存/内存。前缀缓存本质上就是跨请求复用KV Cache。但KV Cache对“前缀一致性”极其敏感:一旦提示词在某个位置发生分叉,分叉点之后的所有缓存都无法使用。此外,某些模型架构(如混合层模型)的KV Cache还涉及滚动摘要或检查点机制,进一步限制了缓存的回退粒度,使得缓存失效的代价更加高昂。
芯片什么时候真正重要
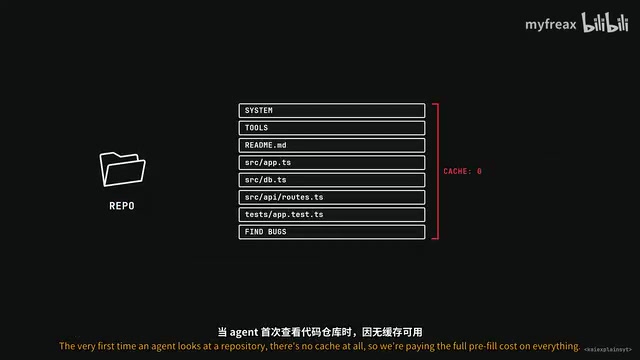
芯片的重要性体现在那些无法跳过的读取上。当Agent首次查看代码仓库时,无缓存可用,需要为所有内容支付完整的pre-fill成本。去年10月一位内容创作者将Cloud Code部署在M5 Pro上查找bug,等了三分多钟Agent才说出第一个词,按该配置的典型读取速度,意味着有5.5万到7万个token正在从零处理。他称在Mac上运行本地AI是浪费钱,6.2万人观看了视频——但他测量的只是第一轮,而关于第一轮的判断没错,这正是M5物有所值的地方。
以27B模型三万两千token的冷启动读取为例:M1 Max上需要5到11分钟,M5 Max上大约只需40秒。这是对实际工作有意义的提升。
更客观的表述是:缓存决定我们要支付多少次冷启动读取,芯片决定每次冷启动读取的成本。如果配置导致每一轮都破坏缓存,那我们每次都在支付冷启动的价格,没有任何芯片能弥补这种差距。
冷启动读取(Cold Pre-Fill) 指的是没有任何可复用缓存时,模型必须从头处理整个提示词的过程。在Agent工作流中,首次请求、缓存失效后的请求、以及上下文被压缩后的请求,都属于冷启动读取。冷启动的耗时与提示词长度成正比,且受内存带宽和GPU矩阵计算能力的双重制约。以27B模型、32000 Token的提示词为例,M1 Max需要5到11分钟,而M5 Max凭借更高的内存带宽和矩阵加速单元可将时间压缩到约40秒。因此,芯片升级的真正价值体现在减少单次冷启动的绝对耗时上,而非提升Decode阶段的Token生成速度。理解这一点,才能正确评估硬件投资的回报率。
动手排查清单
在考虑硬件之前,这些检查不花一分钱,有些只需两分钟:
- 更新Cloud Code。任何早于2.1.181的版本仍存在归属头Bug。无法更新的话,将环境变量Cloud Code Attribution Header设为0。
- 检查Ollama上下文窗口。终端运行
ollama ps,看Context那一列。48GB的Mac上如果读数只有32000,问题就在这里。官方文档建议设为64000或更高。 - 调高服务器日志级别。在Llama.CPP或LM Studio里把日志详细程度调高,跑一个Agent会话,在日志里搜「Full Prompt Reprocessing」。如果每一轮都出现,就知道时间被什么吃掉了。
- 挑剔你的工具。不同前端处理缓存的方式不同,测试配置并查看服务器报告的缓存Token计数器。会话深入阶段缓存Token还是0,就是值得排查的信号。
- Qwen模型可降低Effort Level。最高Effort会产生大量思考Token,让上下文膨胀更快、缓存更难维持。
先查日志,再看规格表。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。