MAGS框架:多智能体自动形式化为AI代码提供安全保证
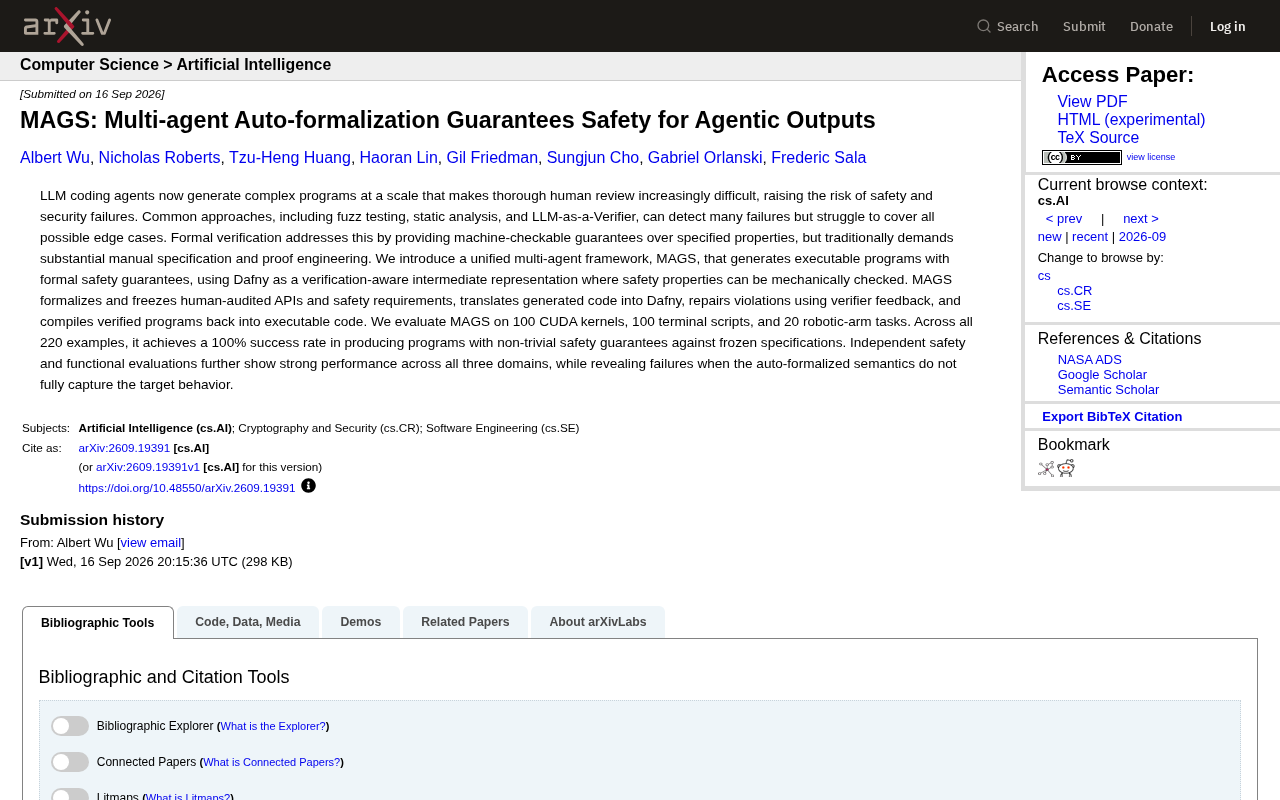
MAGS框架用多智能体自动形式化方法,为LLM生成的代码提供机器可检验的安全保证。
MAGS(Multi-agent Auto-formalization Guarantees Safety)是一个将形式化验证的严谨性与LLM智能体自动化能力结合的多智能体框架,旨在解决AI生成代码速度远超人类审查能力的安全隐患。其核心设计是以Dafny语言作为验证感知的中间表示,通过"冻结人工审计规范—翻译为Dafny—基于验证器反馈自动修复—编译回可执行代码"的闭环,将人类安全意图固化为机器可检验的约束。在100个CUDA内核、100个终端脚本和20个机械臂任务共220个样本上,MAGS达到100%的非平凡安全保证成功率。研究同时诚实揭示了关键局限:当自动形式化语义未能完整捕捉目标行为时(即规范正确性问题),保证的对象本身就出现了偏差,这是形式化验证领域的根本性挑战。
当AI写代码的速度远超人类审查能力
大语言模型(LLM)编程智能体已经能够以惊人的规模生成复杂程序,这带来了一个越来越棘手的问题:人类审查的速度根本跟不上代码生成的速度。当AI生成的程序数量庞大到难以逐一细审时,安全与安全性(safety and security)漏洞的风险随之上升。
目前业界常用的应对手段——模糊测试(fuzz testing)、静态分析(static analysis)以及"LLM作为验证者"(LLM-as-a-Verifier)——虽然能捕捉到大量缺陷,但它们有一个共同的短板:难以覆盖所有可能的边缘情况(edge cases)。这意味着总有一些潜在的失效场景会从这些方法的缝隙中溜走。
形式化验证的老难题与MAGS的新思路
形式化验证(formal verification)本可以解决这个覆盖率问题——它能针对指定属性提供机器可检验的保证(machine-checkable guarantees)。然而传统形式化验证有一道高门槛:需要大量的人工规范编写和证明工程,这让它在实践中难以大规模应用。
arXiv上的这篇论文提出的MAGS(Multi-agent Auto-formalization Guarantees Safety)框架,试图把形式化验证的严谨性与LLM智能体的自动化能力结合起来。它是一个统一的多智能体框架,目标是生成同时具备形式化安全保证的可执行程序。
Dafny作为验证感知的中间表示
MAGS的核心设计是采用Dafny作为"验证感知的中间表示"(verification-aware intermediate representation)。Dafny是一种内建形式化验证能力的编程语言,安全属性可以在其中被机械地检查。这一选择让整个流程有了可靠的验证支点。
整个工作流可以拆解为几个关键环节:
- 冻结人工审计的规范:MAGS将经过人工审计的API和安全需求进行形式化并"冻结",作为不可变的验证基准。
- 翻译为Dafny:把LLM生成的代码翻译成Dafny表示。
- 基于反馈修复:利用验证器的反馈信息,自动修复违反安全属性的部分。
- 编译回可执行代码:将验证通过的程序再编译回可执行代码。
这种"冻结规范—翻译—修复—编译"的闭环,本质上是把人类的安全意图固化下来,再让智能体在这个约束框架内自动完成验证与修复。
形式化验证(Formal Verification)的核心思想是用数学方法证明程序满足某一规范,而不仅仅是"测试若干输入后没发现问题"。典型技术路线包括模型检测(Model Checking)、定理证明(Theorem Proving)和程序逻辑(如Hoare Logic)。与测试不同,形式化验证能提供覆盖所有可能执行路径的全量保证,因此被广泛用于航空、芯片、密码协议等安全攸关领域。然而其实践门槛极高:工程师需要用形式化语言(如TLA+、Coq、Isabelle)手工撰写规范,并在证明过程中处理大量辅助引理,整个过程往往比编写被验证的程序本身还要耗时数倍。这正是 MAGS 试图用多智能体自动化来打破的瓶颈——将繁琐的规范编写和证明修复工作交由 LLM 智能体承担,而把需要人工判断的安全意图浓缩在一次性的"冻结规范"审核环节中。
Dafny 由微软研究院开发,是少数将程序逻辑规范与代码语法深度融合的实用语言之一。开发者可以在函数签名旁直接书写前置条件(requires)、后置条件(ensures)和循环不变式(invariant),Dafny 的内置 SMT 求解器(基于 Z3)会在编译阶段自动尝试证明这些断言。一旦证明成功,就意味着代码在数学上满足指定规范,而非仅在测试用例上通过。选择 Dafny 作为中间表示的优势在于:它既有足够的表达能力描述复杂安全属性,又具备自动化的机器检验能力,不需要人工构造完整的证明脚本。对于 MAGS 这样需要频繁迭代"生成—验证—修复"的流程来说,Dafny 的即时反馈机制(验证失败时会给出具体违反的断言位置)也为 LLM 的自动修复提供了可操作的定位信息。
跨三大领域的实验验证
研究团队在三类差异明显的任务上评估了MAGS:100个CUDA内核(GPU并行计算)、100个终端脚本(terminal scripts)以及20个机械臂任务(robotic-arm tasks),总计220个样本。
结果相当亮眼:在全部220个样本中,MAGS达到了100%的成功率,即针对冻结规范生成了具有非平凡(non-trivial)安全保证的程序。这里"非平凡"是关键词——意味着这些安全保证并非空洞的形式,而是有实际约束意义的。
独立的安全性与功能性评估进一步显示,MAGS在三个领域都表现出色。这种跨领域的一致性说明该框架的方法论具备一定的通用性,而非针对单一场景的特调。
诚实呈现的局限性
值得肯定的是,这项工作并未回避自身的边界。评估同时揭示了一类失败模式:当自动形式化后的语义(auto-formalized semantics)未能完整捕捉目标行为时,就会出现失效。
换句话说,MAGS能保证"程序满足被形式化的规范",但如果形式化过程本身没有准确表达出人类真正想要的行为,那么保证的对象就出现了偏差。这其实是形式化验证领域一个根本性的哲学问题——规范正确性(specification correctness):验证只能保证你验证的东西,而无法保证你验证的就是你真正想要的。
对于试图落地AI生成代码安全方案的团队来说,这个提醒尤为重要:自动形式化降低了人工负担,但也把"规范是否准确"这一关键责任隐藏得更深了。
规范正确性问题在形式化验证社区有一个经典表述,常被称为"验证什么"(what to verify)难题,与"如何验证"(how to verify)同等重要。历史上不乏教训:英特尔奔腾芯片的浮点除法漏洞曾通过了当时的形式化验证,原因正是规范本身遗漏了某些边界条件。在 MAGS 的场景中,自动形式化将自然语言或半结构化需求转换为 Dafny 断言,这一转换过程本身就可能引入语义偏差——LLM 对需求的理解与人类真实意图之间的鸿沟并不总是显而易见。因此,尽管 MAGS 在 220 个样本上实现了 100% 的规范满足率,衡量系统真实安全性还需要额外审查自动形式化后的规范本身是否准确。这提示未来的工作方向之一是为自动形式化的规范提供可读性更好的反向解释,让人类审查者能以更低成本复核"被验证的究竟是什么"。
对AI Agent安全生态的意义
MAGS代表了一条颇具前景的技术路线:在LLM编程智能体日益普及的背景下,用形式化方法为其输出加上一道可机械检验的安全护栏。相比模糊测试和LLM验证者这类"尽力而为"的方案,形式化保证提供的是确定性层面的承诺。
随着AI Agent被用于生成越来越关键的系统代码——从GPU内核到机器人控制——这种将人类审计规范固化、再由多智能体自动完成验证闭环的架构,可能会成为未来AI辅助开发工具链中不可或缺的一环。当然,其规模化应用还需要在更复杂、更真实的工程场景中接受进一步检验。
相关推荐
AAAI-27第一阶段评审结果临近:投稿者需关注什么
AAAI-27第一阶段(Phase 1)评审结果预计9月24日公布,本文解读AAAI分阶段评审机制、投稿者应对策略以及学术社区在结果等待期的协作价值。
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。