MATE:让具身智能体记忆复用不再误导任务执行

MATE在检索与执行之间插入确定性后处理层,通过动作归一化让历史成功轨迹真正可用
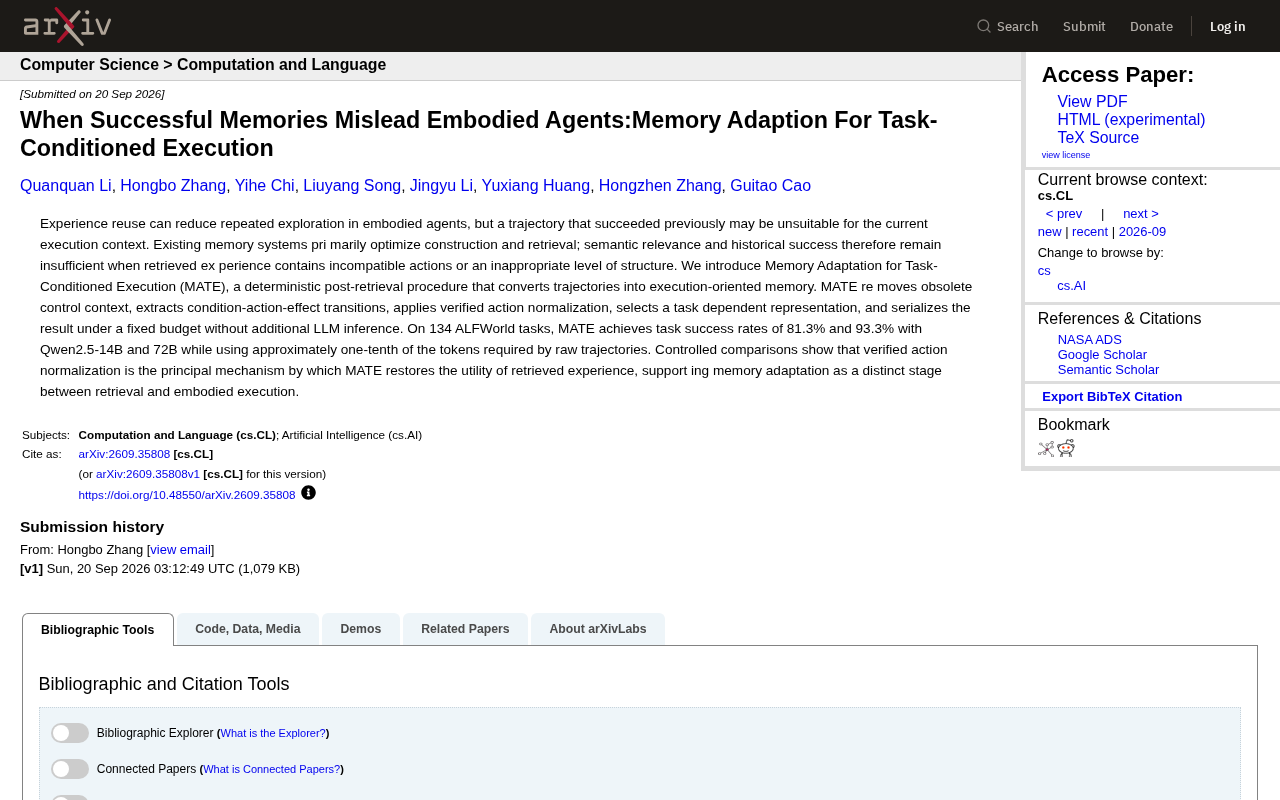
具身智能体复用历史成功轨迹时面临一个隐蔽陷阱:语义相关的经验不代表动作在当前环境中可执行。论文《When Successful Memories Mislead Embodied Agents》提出MATE框架,在检索与执行之间增加一个独立的"记忆适配"阶段,通过移除过时控制上下文、抽取条件-动作-效果转移单元、应用经验证的动作归一化等确定性步骤,将原始轨迹转化为当前任务可用的记忆表示,且全程无需额外LLM推理。在134个ALFWorld任务上,MATE搭配Qwen2.5-14B和72B分别实现81.3%和93.3%的成功率,同时将token消耗压缩至原始轨迹的约十分之一。消融实验确认,动作归一化是恢复检索经验可用性的核心机制。
当"成功记忆"反而成为累赘
具身智能体(Embodied Agent)在执行任务时,往往会尝试复用过去的经验,以减少重复探索的成本。这种思路听起来很合理——既然某条轨迹曾经成功过,为什么不直接拿来用?但一篇新发布的 arXiv 论文《When Successful Memories Mislead Embodied Agents》指出了一个被长期忽视的问题:一条过去成功的轨迹,未必适用于当前的执行环境。
问题的根源在于,现有的记忆系统大多把精力放在"如何构建记忆"和"如何检索记忆"这两个环节上。它们依赖语义相关性和历史成功率来判断一段经验是否值得复用。然而,当检索到的经验中包含了与当前场景不兼容的动作,或者其结构层次与当前任务不匹配时,仅靠语义相关和历史成功就远远不够了。换句话说,检索得再"准",如果内容本身不适配,照样会把智能体带偏。
具身智能体(Embodied Agent)是指能够在物理或模拟环境中感知状态、执行动作并与环境产生交互的AI系统,与纯文本或对话型智能体的核心区别在于它必须处理空间关系、物体状态和连续动作序列。在具身智能体的记忆系统研究中,主流方案通常将历史轨迹(trajectory)以嵌入向量的形式存储,并在新任务到来时通过语义相似度检索最相关的历史经验直接复用。这套"存储-检索-复用"的范式在静态或高度受控的环境中效果尚可,但当环境布局、物体位置或可用动作集合发生变化时,语义上相近的轨迹在执行层面却可能完全失效,形成"语义相关但动作不可用"的错位问题。
MATE:在检索与执行之间补上关键一环
针对这一痛点,研究者提出了 MATE(Memory Adaptation for Task-Conditioned Execution),中文可理解为"面向任务条件执行的记忆适配"。它的核心定位很明确:这是一个确定性的(deterministic)后检索处理流程,负责把原始轨迹转化为面向执行的记忆表示。
值得关注的是,MATE 主张记忆适配(Memory Adaptation)应当作为检索(Retrieval)与具身执行(Embodied Execution)之间一个独立的阶段存在。这在概念上是一种重新划分——过去大家把系统简化为"检索然后执行",而 MATE 认为中间必须有一道把经验"翻译"成可用形式的工序。
MATE 的处理步骤
MATE 对一条检索到的轨迹依次做了以下几件事:
- 移除过时的控制上下文:清理掉那些与当前执行无关的历史控制信息;
- 抽取条件-动作-效果转移(condition-action-effect transitions):把轨迹拆解成结构化的因果单元;
- 应用经过验证的动作归一化(verified action normalization):这是全流程中最关键的机制;
- 选择任务相关的表示形式:根据当前任务动态挑选合适的记忆表示;
- 在固定预算下序列化输出:把结果压缩到限定的 token 预算内。
特别要强调的一点是,整个流程不需要额外的 LLM 推理。这意味着 MATE 是一套确定性的、可预测的处理逻辑,而非又叠加一层昂贵的大模型调用。对于追求成本可控的部署场景,这是相当务实的设计取舍。
条件-动作-效果转移(condition-action-effect transition)是一种源自规划与强化学习领域的结构化表示方法,将一个动作步骤分解为三个要素:执行该动作所需满足的前置条件(condition)、具体执行的操作(action)以及动作产生的环境变化(effect)。这种拆解方式的优势在于,它将原本线性的动作序列转化为具有因果语义的结构单元,使智能体能够判断某个动作步骤在当前环境中是否仍然适用,而不是盲目地逐步照搬历史轨迹。MATE 通过抽取这类转移单元,为后续的动作归一化提供了操作的基本粒度。
实验数据:更高成功率,更低 token 消耗
研究团队在 134 个 ALFWorld 任务上验证了 MATE 的效果。ALFWorld 是具身智能体研究中的常用基准,任务涉及在模拟家居环境中完成一系列操作。
结果颇具说服力:
- 搭配 Qwen2.5-14B 模型,任务成功率达到 81.3%;
- 搭配更大的 Qwen2.5-72B 模型,成功率提升至 93.3%;
- 更重要的是,MATE 所消耗的 token 数量仅约为原始轨迹的十分之一。
成功率提升的同时把 token 开销压到十分之一,这种"既要又要"的效果在实际工程中意义重大。原始轨迹往往冗长且包含大量噪声信息,直接喂给模型不仅浪费上下文窗口,还可能因为无关信息干扰模型判断。MATE 通过精炼记忆,同时解决了成本与质量两个问题。
ALFWorld 是一个将文本游戏(TextWorld)与视觉模拟环境(AI2-THOR)对齐的具身智能体基准测试平台,任务类型涵盖拾取、放置、加热、冷却、清洁等家居操作,要求智能体在房间内导航并操作多个物体以完成多步骤指令。由于任务需要长程规划且动作空间较大,ALFWorld 是评估记忆复用与规划能力的常用场景。需要注意的是,ALFWorld 属于相对受控的模拟环境,物体种类和房间布局有限,这也是论文结尾提示泛化能力仍待验证的原因——真实世界中的动作空间和环境变化远比该基准复杂。
核心洞察:动作归一化是关键
论文最有价值的发现,来自其"受控对比实验"(Controlled comparisons)。研究者通过消融分析确认:经过验证的动作归一化(verified action normalization)是 MATE 恢复检索经验可用性的主要机制。
这个结论解释了前面提出的核心问题——为什么过去成功的记忆会误导智能体。答案在于,检索到的动作序列可能包含与当前环境语境不兼容的具体动作。如果不加处理直接照搬,这些"不兼容的动作"就会成为失败的诱因。而动作归一化正是把这些动作转化为当前环境下可执行、可验证的形式,从而重新激活了历史经验的价值。
这一发现也支撑了 MATE 的整体主张:记忆适配确实值得作为一个独立的研究阶段来对待,而不是被检索或执行环节顺带处理掉的边角料。
对具身智能体研究的意义
MATE 的思路给具身智能体和智能体记忆系统的研究带来了几点启示。其一,经验复用的瓶颈可能不在"检索得准不准",而在"检索到的东西能不能直接用"。这提醒研究者把注意力从检索优化转向后处理适配。其二,确定性流程在成本敏感场景下仍有强大竞争力——不是所有问题都需要再叠一层 LLM 来解决。其三,动作归一化作为核心机制的实证结论,为后续设计更强的记忆适配方法指明了方向。
当然,作为一篇新公布的预印本论文,MATE 目前的验证主要集中在 ALFWorld 这一基准上,其在更复杂、更开放的真实环境中的泛化能力仍有待进一步检验。但它提出的"记忆适配作为独立阶段"这一视角,对于正在快速发展的智能体记忆架构研究而言,无疑是一个有价值的补充。
相关推荐

Rysh Forge 实测:一份 OpenAPI 规范自动生成 Claude 可调用的 Agent 工具
Rysh Forge 用一条命令把 OpenAPI 规范自动转换成 Claude 可调用的 Agent 工具,同时生成 MCP server、Python SDK 和文档,并对写操作强制人工确认,实现全链路可观测。本文解析其工作流与价值。

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。