Matt Pocock 三个新 Skill 补齐 AI 编码闭环

Matt Pocock 新增三个 AI 编码 skill,补齐从工单到 PR 再到复盘的闭环。
文章梳理 Matt Pocock 更新后的 AI 编码 skill 体系:原有 grooming、two-step、two-ticket 与 implement/code review 四段流程解决了从想法到代码的问题,但代码到可合入 PR、再到团队从 AI 错误中学习之间存在断点。新增的三个技能分别补位:implement spec 打包 TDD、code review 与多工作树并行,在 tickets 无依赖的前提下多 agent 同时推进;PR skill 把描述重构为证据、风险与合并危险度三段,将审查判断依据前置;retro skill 从上下文工程与护栏两方面让 agent 不再重复犯错,但强调必须周期性运行并由人审核。三者与旧流程串成完整开发闭环。
AI 写代码已经不是新鲜事,但写完之后呢?PR 堆成山没人审、AI 在长任务里反复犯同一个错、上下文窗口越用越乱——这些才是真正的瓶颈。Matt Pocock 最近更新了他的 skill 集合,新增三个技能,恰好补上了从「工单拆解」到「代码合入」再到「事后复盘」之间的三段空白。
先回顾:原有的四段式流程
在介绍新 skill 之前,需要先理解 Matt Pocock 原有体系的基本逻辑。据 B 站 UP 主在视频中的梳理,旧版流程包含四个环节:
- grooming skill:动手之前先尽可能多地收集上下文,上下文越充分,AI 输出的准确率越高
- two-step skill:把 grooming 阶段达成的共识整理成一份正式计划
- two-ticket skill:将计划拆成 tickets,关键约束是「按功能拆分而非按层次拆分」,让每个 ticket 能由单个 agent 独立完成,从而保护上下文窗口
- implement / code review skill:前者用 TDD 做实现,后者在全新的上下文窗口中按 Martin Fowler 的 12 条重构原则做审查
这套流程解决的是「从想法到代码」的问题,但从代码到可合入的 PR、再到团队从 AI 的错误中学习,链条是断的。
TDD(测试驱动开发) 的经典循环是「红—绿—重构」:先写一个会失败的测试(红),再写最小实现让它通过(绿),最后在不改变行为的前提下重构代码。让 AI 按 TDD 工作有额外收益——测试成为可执行的验收标准,agent 每步都有明确信号判断是否完成,避免「看起来写完了」的假完成。它同时也约束了 agent 的改动范围:没有测试覆盖的行为不应被随意修改。与之配套的 Martin Fowler 的 12 条重构原则(如消除重复、提炼函数、移动特性、以多态取代条件式等)为 code review 提供了可检查的清单,使审查从主观品味转向可逐条对照的规则,也让在全新上下文中运行的审查 agent 有稳定的判断依据。
新 Skill 一:implement spec,并行处理工单
第一个新技能是 implement spec。UP 主在视频中给出的定位是:它把 TDD skill、code review skill 以及多工作树并行能力打包在一起。
具体做法是先整理所有 tickets,找出没有依赖关系的那些,同时启动多个 AI agent 分头推进。相比串行处理,这种方式能显著缩短整体耗时。各分支完成后合并到统一分支,再走 code review,最后修复问题、生成可用的 pull request。
这里的设计思路值得注意:并行不是简单的「多开几个 agent」,而是建立在 ticket 之间无依赖这一前提上。two-ticket skill 当初「按功能拆分」的决策,正是为了让这一步成为可能——如果按层次拆(先写所有 model、再写所有 service),tickets 之间天然存在依赖,并行就无从谈起。
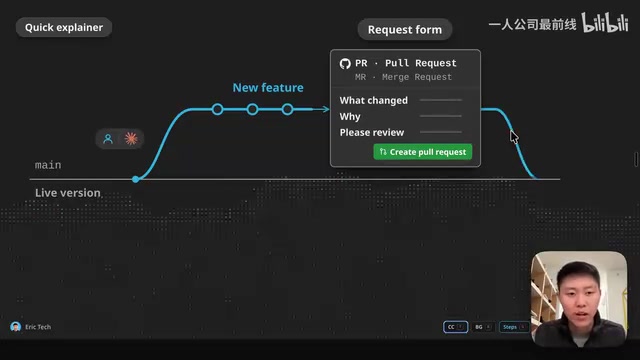
多工作树(git worktree) 是 Git 提供的一种机制,允许在同一个仓库上同时检出多个独立的工作目录,每个目录对应不同的分支,共享同一份 .git 对象库。与克隆多份仓库相比,worktree 不重复存储历史对象,切换和清理成本更低。在 AI 编码场景中,每个 agent 占一个 worktree、在一个分支上独立提交,互不干扰,完成后统一合并。这正是 implement spec 能「并行推进」的底层支撑:agent 之间没有文件争夺,也不需要反复 stash 或切分支。需要注意的是,worktree 只隔离工作区,不解决合并冲突——冲突仍需在汇总阶段由人或 agent 逐个消化。
新 Skill 二:PR skill,让审查者三十秒看懂风险
第二个技能针对的是 PR 审查瓶颈。UP 主在视频里讲得很直白:过去瓶颈是写代码,因为人写得慢;AI 把写代码的速度拉起来之后,瓶颈转移到了「人审 PR」这一环。AI 每天产出的 PR 数量巨大,而传统 PR 描述里的「快速总结」和「测试计划」并不能证明功能真的可用——测试计划是否有效,仍然要靠人去跑一遍才知道。
Matt 的 PR skill 把描述结构改成了三段:
- 证据(evidence):功能确实可用的证明,而不是「应该没问题」
- 风险(risk):这次改动在生产环境可能造成什么后果
- 合并危险度(merge danger):如果 PR 出问题,影响范围(blast radius)有多大、能否回滚
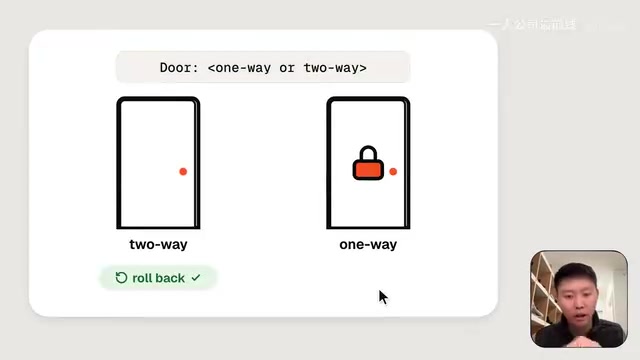
这套结构的价值在于把判断依据前置。一个小改动、回滚容易,可以快速放行;一个大改动、回滚困难,就该停下来让人仔细看。UP 主也提到,这个 skill 并非固定模板——没有技术背景的人可以把它改写成不含过多技术术语的版本,关键是让它对自己可读、可判断。
影响范围(blast radius) 借自故障管理与安全领域,指一次变更出问题时波及的范围:多少用户、多少服务、是否触及数据写入或资金路径。它不仅取决于改动行数,更取决于改动所处的系统位置——修改一个内部工具函数与修改鉴权中间件,风险量级完全不同。与影响范围配套的是可回滚性:能否通过 feature flag 快速关闭、是否涉及不可逆的数据迁移、回滚是否需要停机。把两者与风险一起写进 PR 描述,审查者就不必自行重建上下文,而能直接按「影响大且难回滚则重点看、影响小且易回滚则快速放行」的规则分配注意力,这正是把判断依据前置的实际收益。
新 Skill 三:retro skill,让 agent 从错误中学习
第三个技能解决的是长任务中的「重复犯错」问题。当任务拉长到几十、上百甚至上千个 ticket 时,agent 可能在同一类问题上反复跌倒,既消耗 token 也不产出进展。retro skill 的作用是回看 agent 的完整对话记录,从两个方向改进:
上下文工程:检查 agent 找文件是否低效,据此生成 agent MD 文件,列出关键文件位置与查找路径;同时清理系统提示中冗长、冗余的部分。
护栏(guard rails):把「不该调用的 API」「不该放错位置的导入」这类反复出现的错误固化成 lint 规则或编码约定,从机制上阻止再犯。
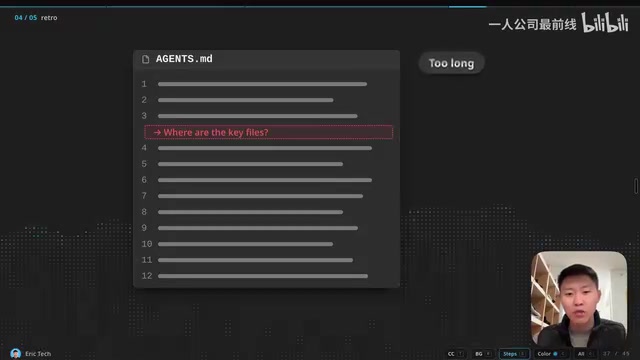
Matt Pocock 特别强调的一点是:retro skill 不能开成 autopilot 模式。如果持续运行,Claude 会把所有观察都当成值得挑剔的问题,项目重心就会从「做功能」漂移到「改项目本身」。正确用法是周期性运行,并且由人审核它提出的修改建议。
三个新 skill 拼出的完整闭环
把新旧技能串起来看,整个软件开发生命周期的覆盖变得连续:two-ticket 之后接 implement spec 做并行实现,code review 之后接 PR skill 让合入更易审,最后用 retro skill 把这一轮的经验反馈回下一轮的上下文与护栏。UP 主在视频结尾把这称为「full circle」——下一轮 agent 做功能或修 bug 时,起点比这一轮更高。
需要说明的是,上述内容主要来自单一视频来源的讲解,Matt Pocock 原始 skill 的具体实现细节(如各 skill 的提示词写法、并行工作树的具体配置)视频中并未展开,感兴趣的读者应查阅其原始仓库与文档。另外,UP 主提到的配套 canvas 页面汇总了每个 skill 的适用场景与工作原理,可作为进一步参考。
对日常使用 AI 编码的开发者来说,这三个 skill 提供的思路比具体实现更值得借鉴:用无依赖拆分换取并行、用风险分级换取审查效率、用周期性复盘换取长期收敛。即便不用 Matt 的原版,这套结构也可以迁移到自己的 agent 工作流中。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。