美国封杀DeepSeek背后:20%调用量与国产硬件突围

DeepSeek全球API调用份额破20%引发美国封杀,大模型竞争转向单位推理成本。
美国国土安全部发布紧急指令,要求联邦民用机构清除中国开源大模型DeepSeek。文章指出,开源模型可fork、可本地部署,行政封杀的技术效果有限,更多是信号层面的动作。封杀的背景藏在两组数据里:一是DeepSeek全球大模型API调用量份额突破20%,超过谷歌和OpenAI,开源加低成本正在动摇闭源按token计费的商业根基;二是长新存储研发4F2架构,单元面积缩减约30%,提升国产HBM容量上限,构成制程受限下的物理突围路径(单一来源,待验证)。两条线叠加,指向同一个判断:大模型竞争的重心已从参数军备竞赛转向单位推理成本,成本效率而非参数规模才是真正的护城河。
美国国土安全部近日发布紧急指令,要求所有联邦民用机构全面清除中国开源大模型DeepSeek。封杀一个开源模型,这个动作本身就不寻常——开源代码可以fork、可以本地部署,行政命令能清除的只是联邦设备上的副本,却挡不住模型在技术社区的流动。那美国为什么还是这么急?答案藏在两组数据里。
20%全球调用量:开源模型第一次站到牌桌中央
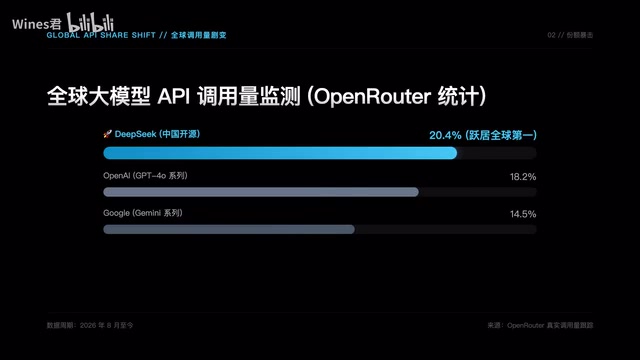
据第三方监测数据,DeepSeek广告在全球大模型API调用量中的份额已经突破20%,超过谷歌和OpenAI。这个数字的份量需要放在语境里理解:API调用量反映的是真实的生产级使用,不是榜单跑分,也不是下载量这类虚荣指标。一个中国团队的开源模型拿到全球五分之一的调用份额,意味着大量开发者和企业在用脚投票。
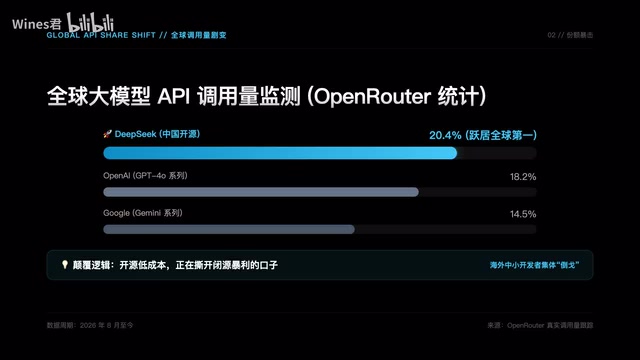
开源加低成本的组合,正在撕开闭源商业模式的口子。过去两年大模型竞赛的主叙事是参数规模,但真正决定商业胜负的是单位推理成本——同样一个任务,谁能让token更便宜、部署更可控,谁就能吃到长尾市场。DeepSeek的冲击不在于它比闭源模型强多少,而在于它把“够用”的能力以极低价格铺开,这直接动摇了按token计费的商业根基。
行政封杀在技术层面的效果有限,但在信号层面很明确:当一个开源模型的调用份额足以影响市场格局时,它就不再只是技术产品,而被视为需要处理的变量。
API调用量指的是开发者或企业通过应用程序接口向模型发起请求的次数,通常按token(词元)计费。它区别于模型跑分(benchmark)或下载量:跑分反映实验室条件下的能力上限,下载量反映关注度,而调用量反映的是真实的生产级使用——有多少业务真正把模型嵌进了产品和工作流。因此调用量份额是衡量商业化落地程度最直接的指标之一,也是云厂商和模型公司收入结构的先行信号。
开源大模型指模型权重公开可下载、允许本地部署和二次开发的模型,如DeepSeek、Llama系列。与闭源API服务不同,开源模型的推理可以由使用者自己在自有硬件上完成,成本取决于硬件效率和部署规模,而非厂商定价。这意味着一旦开源模型能力“够用”,使用者就可以完全绕开厂商的按token计费,这也是开源模型对闭源商业模式构成结构性威胁的根本原因。
算力封锁的另一面:国产存储的物理突围
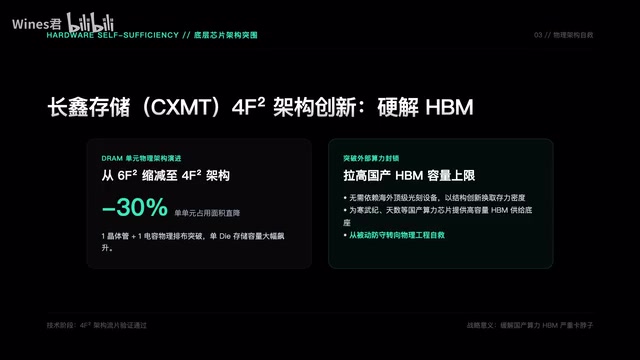
封杀的另一条线索在硬件。据B站视频披露,长新存储成功研发出4F2存储架构,单单元面积缩减约30%,提升了国产HBM的容量上限。
HBM是AI算力的关键瓶颈之一,高带宽内存的供给直接决定训练和推理集群的规模上限。外部越是收紧先进算力出口,底层硬件的物理层面突围就越有动力——制程受限的情况下,靠存储单元结构创新提升密度,是一条绕开部分限制的现实路径。需要说明的是,这条硬件信息目前来自单一视频来源,具体量产进度和性能指标尚待更多信源交叉验证,读者宜保持审慎。
把软件层的调用量份额和硬件层的存储突破放在一起看,逻辑就清楚了:一边是模型以低成本抢占全球开发者心智,一边是算力基础设施在物理层面寻找替代路径。两条线叠加,构成了美国急于出手的背景——封杀令针对的不是某一个模型文件,而是这套“开源模型+国产硬件”的组合正在形成的惯性。
**HBM(高带宽内存)**是一种通过将多层DRAM芯片垂直堆叠、并用硅通孔(TSV)互连的高性能内存,通常与GPU封装在一起,为AI训练和推理提供远超普通内存的带宽。大模型推理的瓶颈往往不在算力峰值,而在显存带宽——权重加载和数据搬运的速度决定了每秒能处理多少token。因此HBM的供给量直接约束了AI集群的规模上限,也是先进算力出口管制中的关键品类之一。
4F2存储架构是DRAM单元布局的一种设计,其中“F”指最小特征尺寸,4F2表示每个存储单元占用约4个特征尺寸平方的面积,相比传统的6F2结构可将单元面积缩减约三分之一。单元面积变小意味着同样晶圆面积能容纳更多存储容量,从而在制程受限的情况下提升内存密度。这正是“物理层面突围”的含义:不依赖更先进的制程节点,而是通过单元结构创新来提高单位面积的存储能力。
商业终局是单位推理成本,不是参数内卷
这场博弈给出的最重要判断是:大模型竞争的重心已经从参数军备竞赛转向单位推理成本。参数再大,如果每次调用的成本降不下来,商业上就无法规模化;反过来,能力“够用”且价格极低的模型,能迅速渗透到对成本敏感的中小企业和个人开发者市场。
开源在这个逻辑里是放大器。闭源模型降价有底线,因为要养活商业组织;开源模型的成本结构由社区和硬件效率决定,降价空间完全不同。DeepSeek被打压,某种程度上恰恰证明了这条路径的有效性——如果开源低成本不构成威胁,就不需要动用行政手段。
对国内AI从业者而言,这件事的启示不在于情绪层面的对抗,而在于看清竞争维度:模型能力的差距在缩小,成本效率的差距才是护城河。谁能把推理成本压到更低,谁就能在下一阶段的调用量争夺中占据位置。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。