MeReader:离线隐私AI阅读助手,防剧透
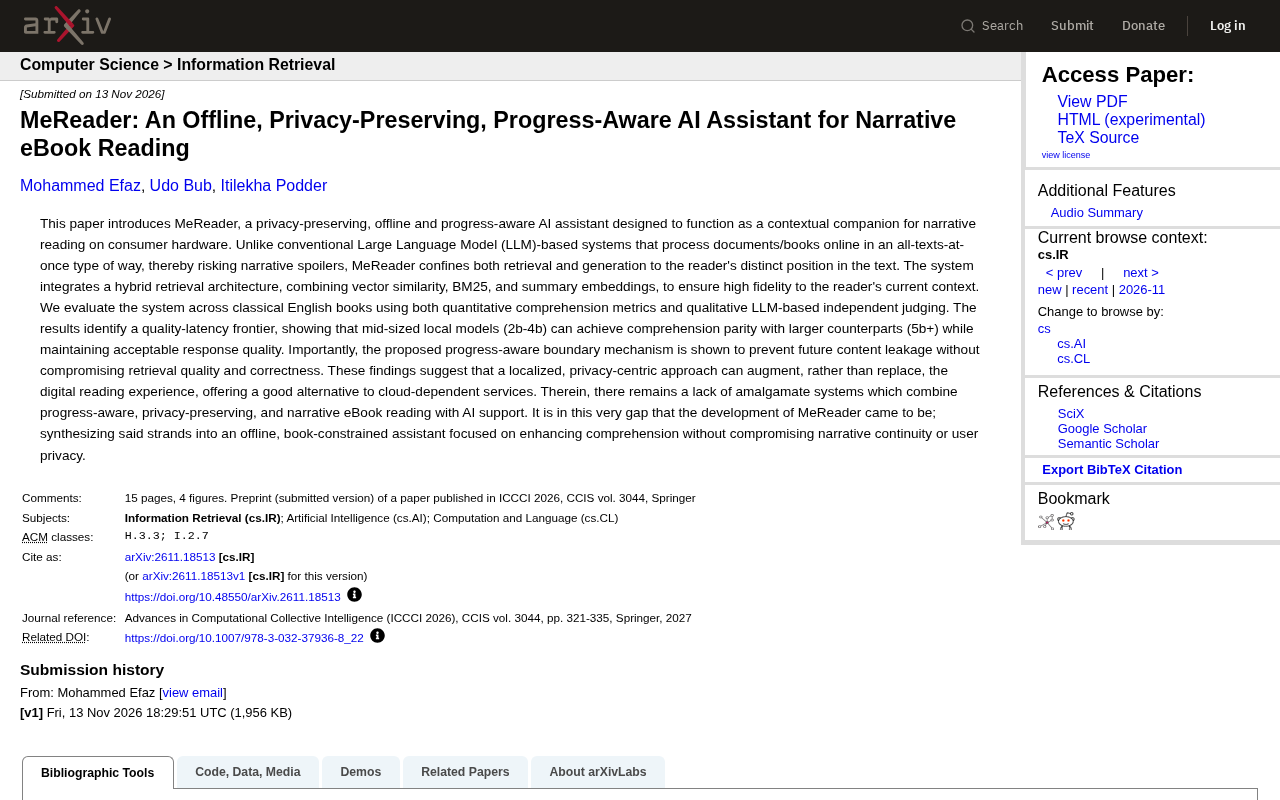
MeReader用离线混合检索与进度边界机制,在消费级硬件上实现防剧透的AI阅读助手。
针对云端AI阅读工具存在的隐私泄露与剧透风险,论文提出完全离线的MeReader系统。其核心是将检索与生成严格限制在读者当前阅读位置,通过向量相似度、BM25与摘要嵌入构成的混合检索架构保证回答贴合已读内容,并从检索源头切断未来文本流入。评测显示,2b–4b参数的本地中型模型理解表现可与5b以上模型持平,且进度感知边界机制不损害检索质量。作者将MeReader定位为云端服务的隐私友好补充方案,展示了以系统设计而非模型规模取胜的本地化阅读辅助路径。
读小说时,我们常希望有个助手能解释晦涩的典故、梳理复杂的人物关系,但主流AI阅读工具大多依赖云端,并且一次性处理整本书。这带来两个问题:隐私风险,以及更恼人的——剧透。一篇新论文提出的MeReader,试图用完全离线的方式解决这些矛盾。
云端AI阅读器的两难困境
当前基于大语言模型(LLM)的阅读辅助系统,通常将整本电子书上传至云端,并采用“全文本一次性处理”的模式。这意味着模型在生成回答时,可能已经“读过”了读者尚未读到的章节。当读者询问“这个人为什么这么做”时,模型一不小心就会引用后文的情节,破坏阅读体验。
话说回来,将整本书交给第三方服务,对注重隐私的读者而言是另一重顾虑。论文指出,现有方案缺乏将“进度感知”“隐私保护”与“叙事类电子书阅读”三者结合的系统。MeReader正是瞄准这一空白。
把AI助手“关”在已读页面内
MeReader的核心设计,是将检索和生成都严格限制在读者当前所处的文本位置。系统运行在消费级硬件上,完全离线,不依赖任何云服务。
为实现这一点,研究团队构建了一套混合检索架构:向量相似度负责语义匹配,BM25负责关键词匹配,再加上摘要嵌入(summary embeddings)来捕捉章节级上下文。三者结合,确保AI的回答高度贴合读者当前读到的内容,而非全书任意角落。
这种“进度感知边界机制”是MeReader的关键创新。它从检索源头就切断了未来内容的流入,而非在生成阶段再做过滤,从而在不牺牲检索质量的前提下防止剧透。
BM25 是一种经典的稀疏检索算法,属于概率检索模型家族。它基于词频(TF)与逆文档频率(IDF)对文档相关性打分,并通过文档长度归一化参数抑制长文档的天然优势。与向量检索擅长捕捉语义相似不同,BM25 对精确关键词匹配极为敏感——例如读者询问某个具体人名或术语时,BM25 能稳定召回包含该词的原文章节,而语义向量可能因泛化而偏离。MeReader 将两者并联,本质是让“语义召回”与“字面召回”互为补充,降低单一检索范式在叙事文本上的漏检风险。
摘要嵌入(summary embeddings) 指对每个章节先由模型生成一段浓缩摘要,再对摘要做向量化表示并建立索引。检索时,查询先与章节级摘要向量匹配,定位到相关章节后再进入细粒度检索。这种两级结构相当于为长文本建立了一张“章节目录语义地图”,使系统在读者提问涉及跨段落情节时仍能锁定正确的章节范围,而非在全书向量库中盲目搜索,兼顾了检索效率与章节级上下文感知。
中等规模本地模型已够用
论文使用经典英文书籍进行了评测,结合定量理解指标与基于LLM的独立定性评判。结果揭示出一条清晰的质量-延迟前沿曲线。
说个细节,参数量在2b到4b之间的中型本地模型,其理解表现已能与5b以上的更大模型持平,同时保持可接受的响应质量。对于消费级硬件而言,这意味着本地运行AI阅读助手在体验上已具备可行性,不必为追求更大模型而牺牲响应速度。
另一项关键结论是:进度感知边界机制被证明不会损害检索的正确性与质量。换句话说,防剧透并非以牺牲实用性为代价。
质量-延迟前沿曲线(quality-latency frontier) 是评估本地部署方案时的核心分析框架:横轴为端到端响应延迟,纵轴为回答质量(如理解准确率或人工评分),不同参数量、量化精度与硬件配置的模型在图上形成一系列散点,连成一条权衡边界。曲线上的点代表在给定延迟预算下可达到的最优质量,曲线内移则意味着系统设计(如检索增强、提示优化)带来了帕累托改进。MeReader 的评测正是借助这一框架说明:2b–4b 模型在消费级硬件上已位于可接受的前沿区间,继续增大模型带来的质量增益开始递减,而延迟成本显著上升。
本地化方案是补充而非替代
论文作者对MeReader的定位颇为克制:一个本地化、以隐私为中心的方法,可以增强而非替代数字阅读体验,为依赖云端的服务提供一个不错的替代选项。
这一定位切中现实。云端大模型在知识广度和推理能力上仍有优势,但阅读辅助场景对上下文边界和隐私的要求极为特殊。将AI“约束”在当前阅读进度内,反而可能减少模型幻觉式的过度联想,让回答更聚焦于读者真正需要理解的内容。
MeReader展示了这样一条路径:不追求更大的模型,而是通过系统设计——混合检索与进度边界——在有限算力下实现更贴合场景的阅读辅助。对于希望保留阅读纯粹性、又不愿放弃AI助力的读者,这或许是一个值得关注的起点。
相关推荐
不写代码、卸载编辑器:AI时代产品开发新范式
三位前端程序员深度讨论AI时代的产品开发流程:卸载IDE、不看代码、设计驱动开发,用Figma加MCP出方案,Opus 5.5当主力模型,Claude Code与Grok Bot分阶段接力,以及99美元开发者账号如何变成个人Pro版操作系统。
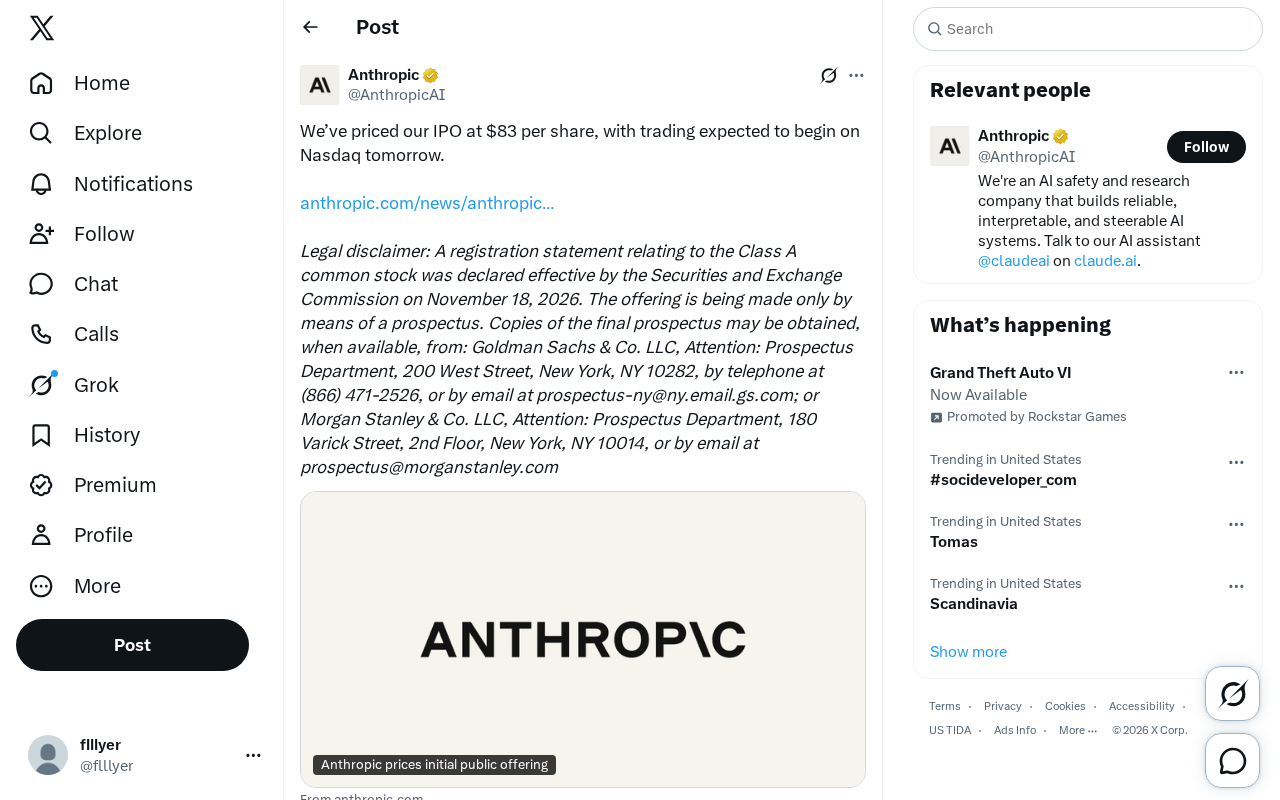
IPO定价每股83美元,这家公司明日登陆纳斯达克
一家公司宣布其IPO定价为每股83美元,Class A普通股预计明日开始在纳斯达克交易,注册声明已于2026年11月18日获SEC生效,高盛与摩根士丹利担任承销商。

B站硬核AI编程课:Vibe Coding全链路实战,一人做出商业级产品
B站UP主分镜影院推出硬核AI编程课,覆盖Vibe Coding、Claude Code、Stitch做UI、MCP、前后端、小程序与部署,带你用AI全链路闭环做出商业级产品,掌握一人公司实战能力。