Meta Muse AI数字人上线视频通话,美国用户可定制形象

Meta 向美国用户开放 Muse AI 虚拟形象视频通话,并透露 Tamagotchi 式可穿戴设备。
Meta 宣布美国用户可通过视频通话与 AI 虚拟形象 Muse 互动,且形象支持自定义。视频通话要求语音、口型与表情实时同步,技术门槛显著高于文本或语音交互,功能开放说明其实时生成管线已达可用状态。Meta 同时透露一款类似 Tamagotchi 的可穿戴设备,计划把 Muse 从屏幕带入随身场景。两条产品线共享同一形象资产:视频通话是软件侧验证,硬件是后续延伸。文章认为,定制化形象意在建立归属感,是 Meta 在 AI 助手同质化竞争中的差异点,但算力成本、隐私说明以及可穿戴设备的生命周期仍是待解问题。
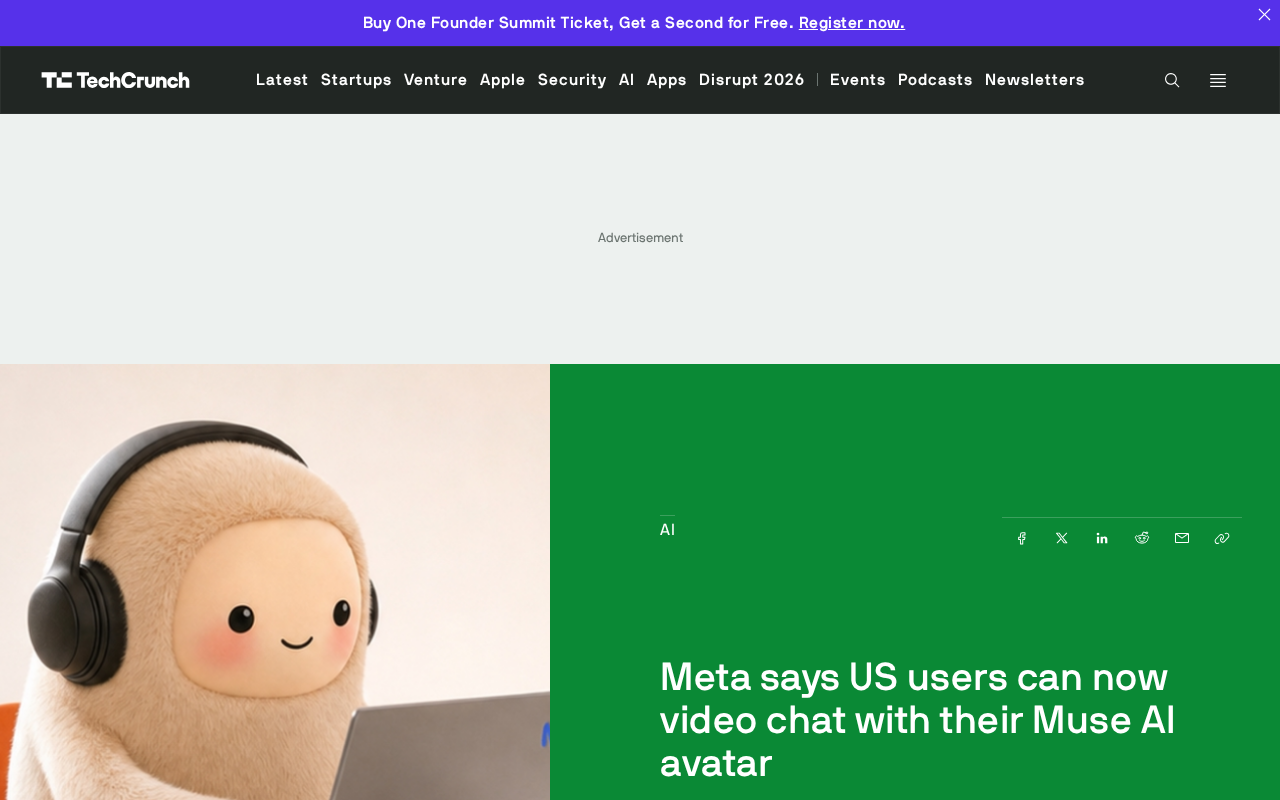
Meta 正在把 AI 助手从文本框里拉出来,变成一个会说话、会做表情的数字人。据 RSS 来源报道,Meta 宣布美国用户现在可以通过视频通话与名为 Muse 的 AI 虚拟形象互动,并且这个形象支持自定义。
这项功能的上线时间点耐人寻味:Meta 同时透露了一款类似 Tamagotchi 的可穿戴设备,目标是把 Muse 从屏幕里「带出来」。两条产品线一前一后,指向同一个方向——AI 助手的形态正在从工具转向陪伴。
Muse 是什么:从聊天机器人到动画形象
Muse 并非一个全新的模型名称,而是 Meta AI 助手的一个可交互形象层。用户可以在视频通话中看到一个动画化的虚拟形象,由 AI 驱动进行对话。与纯文本或语音交互相比,视频通话意味着系统需要同时处理语音识别、语义理解、语音合成以及面部动画的实时生成。
Meta 将其描述为「可定制的动画形象」。具体定制维度官方没有展开,但从产品逻辑推断,形象外观是最基础的一层,后续可能延伸到声音、表情风格甚至性格设定。这一方向与 Meta 在虚拟化身(Avatar)领域多年的积累直接相关——Quest 平台和社交产品中的 Avatar 系统为 Muse 提供了现成的技术底座。
虚拟化身(Avatar)系统是 Meta 多年积累的技术资产。在 Quest 平台和社交产品中,Avatar 包含骨骼绑定、面部表情驱动、口型同步等模块,通常基于 ARKit 兼容的面部混合形状(blendshape)标准实现。当 AI 需要生成实时动画时,系统会把语音合成输出的音素序列映射到口型动作,再叠加表情层,最终渲染成可见形象。Muse 直接复用这套管线,意味着 Meta 不必从零构建动画系统,只需把 AI 驱动的对话逻辑接入现有 Avatar 渲染链路。这也是 Meta 能在视频通话形态上快速推进的底层原因。
视频通话意味着什么
把 AI 助手放进视频通话,门槛比想象中高。文本对话可以容忍秒级延迟,语音通话可以容忍百毫秒级抖动,但视频通话要求口型、表情与语音同步,任何错位都会立刻被用户感知为「假」。
Meta 选择在这个时间点开放功能,说明其实时生成管线已经达到可用状态。对用户而言,变化在于交互的「在场感」:面对一个会转头、会眨眼、会跟着语气变化的形象,对话的心理距离明显缩短。这也是 Meta 在 AI 助手同质化竞争中试图建立的差异点——当各家模型能力差距收窄,交互形态成为新的战场。
实时音视频生成的技术难点集中在「同步」二字。语音合成通常以流式方式输出音频块,面部动画需要根据音频的时间戳逐帧对齐口型,而视频编码又要保证端到端延迟控制在可接受范围内。行业里常用的做法是引入一个低延迟的音频驱动面部动画模型,把语音特征直接映射为表情参数,再通过轻量渲染管线输出画面。任何环节的缓冲都会造成音画不同步,用户会立刻感知为「假」。Meta 开放该功能,说明其流式管线已经把延迟压到了可用区间。
Tamagotchi 式可穿戴设备的分量
报道中提到的那款「类似 Tamagotchi 的可穿戴设备」,是理解 Muse 战略意图的关键线索。Tamagotchi(电子宠物)的核心体验不是功能,而是陪伴关系:用户照料它、它回应用户,形成情感连接。
如果 Meta 把 Muse 装进一个随身设备,AI 助手就不再是「打开 App 才存在」的服务,而是持续在场的实体。这与当前 AI 硬件的探索方向一致,但 Meta 的差异化在于已有 Muse 这个可交互形象作为内容层,硬件只是载体。换句话说,视频通话是软件侧的验证,可穿戴设备是硬件侧的延伸,两者共享同一个形象资产。
需要说明的是,可穿戴设备目前仅有方向性描述,Meta 尚未公布形态细节和上市节奏。从「ahead of the launch」的表述看,视频通话功能是先行动作,硬件在后方待命。
Tamagotchi 是 1996 年万代推出的便携电子宠物,核心机制是「照料—反馈」循环:用户喂食、清洁、陪玩,设备以动画和状态变化回应,从而建立情感连接。它的产品逻辑不依赖功能复杂度,而依赖持续在场和低门槛互动。Meta 借用这一概念,意味着可穿戴设备的目标不是替代手机,而是让 AI 形象拥有一个随时可触达的物理载体。这类产品的难点在于如何避免新鲜感消退后的闲置,通常需要持续的内容更新和对话能力迭代来维持粘性。
竞争格局中的位置
视频通话形态的 AI 形象并非 Meta 独创。行业内已有多个玩家在尝试让 AI 助手具备视觉化的人格呈现,但多数停留在演示或小范围测试阶段。Meta 的优势在于分发规模——美国用户直接可用,意味着功能已经过内部验证并具备服务承载能力。
另一个值得关注的点是定制化。当用户能决定 AI 形象的外观,产品就从「一个助手」变成「我的助手」,归属感带来的留存效应在社交产品中已被反复验证。Meta 显然想把同样的逻辑搬到 AI 助手上。
AI 助手的视觉化人格呈现正在成为行业探索方向。部分玩家采用 3D 虚拟形象加语音对话的组合,部分则停留在 2D 动画或预渲染视频阶段。差异主要体现在实时性和可定制性上:预渲染方案成本低但交互感弱,实时生成方案体验好但算力消耗大。Meta 的优势在于分发规模——美国用户直接可用,说明功能已通过内部验证并具备服务承载能力。当各家底层模型能力差距收窄时,交互形态和分发渠道会成为新的竞争变量。
待解的问题
功能上线只是起点。视频通话对算力和带宽的消耗远高于文本交互,大规模开放后服务成本如何控制,是 Meta 需要回答的问题。隐私层面同样存在讨论空间:视频通话涉及摄像头权限和实时音视频数据,Meta 需要给出清晰的数据处理说明。
可穿戴设备的悬念则更大。Tamagotchi 式产品的生命周期往往依赖新鲜感,Muse 能否通过持续更新的对话能力和形象内容维持用户粘性,将决定这条产品线的天花板。
从文本到语音,从语音到视频形象,再到随身硬件,Meta 给 Muse 规划的路径清晰:让 AI 助手具备「存在感」。视频通话是这条路上的中间站,接下来要看那款小设备能否把 Muse 真正带进日常生活。
相关推荐

Anthropic Fable 5.2实测:一句话生成3A游戏与Excel克隆
Anthropic Fable 5.2实测:三行提示词生成可玩《战争机器》克隆、完整Excel和DaVinci Resolve克隆,解析基准测试、Ultra Code模式、token成本与定价策略,评估它是否值得替代Opus 5.5。

赛博寻书:BT社区如何「劫走」塞林格遗作
塞林格未发表的《The Ocean Full of Bowling Balls》仅存于大学图书馆且禁止复制。一个私密BT tracker悬赏六TB上传积分,社区从背诵接力到eBay买书扫描,最终成功让文本流出,却因传播过快被管理员删种。本文复盘这场赛博寻书行动及其讽刺结局。

弹劾防长赫格塞斯?五角大楼战争与中期选举风暴
五角大楼气氛紧张,伊朗战事持续八个月仍无退出方案。评论分析赫格塞斯弹劾动议的真实动机:不是罢免,而是留下政治记录,并剖析战争如何通过油价与生活成本影响中期选举选情。