Meta发布Muse Ember:效率前沿上的最小模型
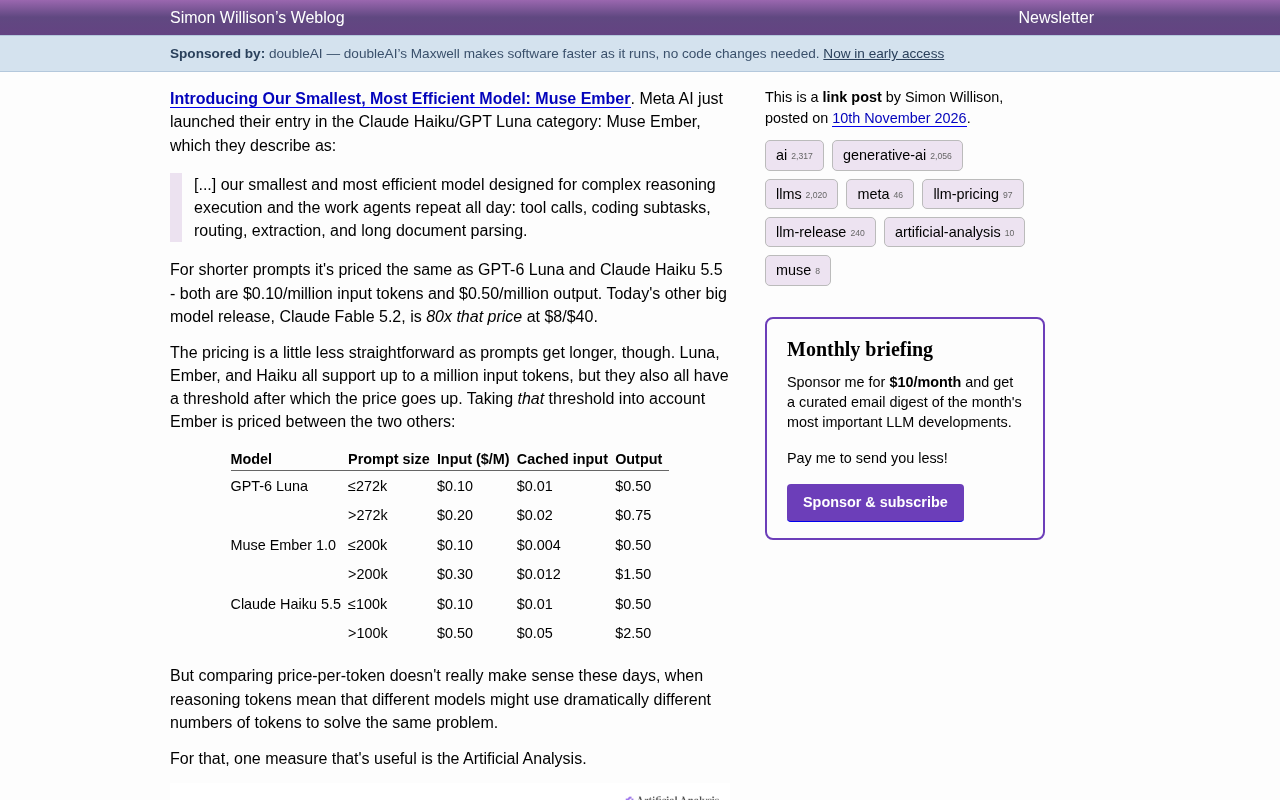
Meta推出Muse Ember小模型,以效率前沿定位角逐高频智能体任务。
Meta AI 发布 Muse Ember,定位高频重复性智能体任务的最小高效模型,对标 Claude Haiku 5.5 与 GPT-6 Luna。短提示定价三者对齐,输入 0.10、输出 0.50 美元每百万 token,约为 Claude Fable 5.2 的八十分之一。长上下文阈值分别为 Ember 200k、Luna 272k、Haiku 100k,超限后 Ember 定价居中。文章指出逐 token 比价已失效,改以 Artificial Analysis 的单任务成本衡量,Ember 高推理档位落在帕累托前沿。六档推理测试显示档位与输出质量无正相关,high 档甚至未返回完整 SVG,而 max 档产物质量接近价格高 40 倍的 Muse Wonder。结论是 Ember 适合作为执行层专用件,提示长度分布应成为选型硬指标。
Meta AI 正式推出其面向高频、重复性智能体任务的最小高效模型 Muse Ember,直接对标 Claude Haiku 与 GPT Luna 系列。这款模型的核心定位并非追求全能,而是用极低的推理成本支撑起智能体日常运转所需的工具调用、代码子任务、路由、信息抽取与长文档解析。
小模型赛道的定价博弈
Muse Ember 在短提示场景下的定价与 GPT-6 Luna、Claude Haiku 5.5 完全对齐:输入每百万 token 0.10 美元,输出每百万 token 0.50 美元。作为对比,同期发布的 Claude Fable 5.2 价格是这一档位的 80 倍,达到输入 8 美元、输出 40 美元每百万 token。
不过长提示会把差距拉开。三款模型都支持最高百万级输入 token,但各自设有价格跳涨阈值。Muse Ember 的阈值在 200k,超出后输入涨至 0.30 美元、输出涨至 1.50 美元;GPT-6 Luna 的阈值在 272k,超限后输入 0.20 美元、输出 0.75 美元;Claude Haiku 5.5 的阈值最低,仅 100k,超限后输入 0.50 美元、输出 2.50 美元。按阈值折算,Ember 的长上下文定价恰好落在另外两者之间。
每token价格已经说明不了问题
当推理 token 成为主流,逐 token 比价的意义正在快速衰减——同一道题,不同模型消耗的 token 数量可能相差悬殊。真正有参考价值的是 Artificial Analysis 按任务成本折算的对比。
在 Intelligence Index 与单任务成本的散点图上,Muse Ember 的两个高推理档位稳稳落在帕累托前沿上。Meta 在发布公告中明确表示,该模型位于完整榜单的效率前沿:没有模型能以更低的单任务成本获得更高的得分。这一结论为 Meta 在小模型赛道的定位提供了第三方数据支撑。
图表中还藏着一个容易被忽略的信号:帕累托前沿上出现了一个 GPT-6.1 Terra 的低推理档位灰点。它在绿色最优象限内,意味着 Terra 家族在性价比维度上同样值得持续关注,而非只有旗舰型号才有讨论价值。
Artificial Analysis 与 Intelligence Index
Artificial Analysis 是一家独立第三方评测机构,它维护的 Intelligence Index 是把多项标准化基准(如推理、编码、知识问答等)加权合成为单一分数的综合指标,用于横向比较不同模型的“能力水位”。与厂商自报的基准成绩不同,该指数的价值在于统一口径、可复现。更关键的是,该机构同时测算每个模型完成同一批任务所消耗的实际成本,从而把“能力”与“价格”放进同一坐标系。正因如此,文章提到的散点图横轴是单任务成本、纵轴是智能得分,模型的位置直接反映性价比,而不只是纸面上的 token 单价。
六档推理解析:档位高不等于画得好
Muse Ember 提供 minimal、low、medium、high、xhigh、max 六档推理强度。用同一提示词生成“骑自行车的鹈鹕”SVG 的测试中,high 档甚至没能返回完整的 SVG,而其余档位的输出在视觉质量上并未与推理档位形成清晰的正相关。
这一点值得开发者留意:推理档位调节的是模型在回答前投入的思考量,但不必然线性映射到最终产物的精细程度。对结构化输出类任务,盲目拉高档位可能只是增加成本,而非改善结果。
以 max 档的鹈鹕为例,自行车车架结构完整,车筐里放着鱼,鹈鹕头上还戴着一顶奇怪的蓝色帽子——整体水准与价格高出 40 倍的 Muse Wonder 输出相当。对于 SVG 生成这类任务,Ember 用极低的单价交出了可用的结果。
推理强度档位(Reasoning Effort)
推理档位是近年推理模型普遍引入的控制参数,本质是调节模型在给出最终答案前允许生成的“思维链”或内部思考 token 上限,以及是否启用更长的搜索/自检过程。档位越高,模型被允许反复推敲、验证和回溯,理论上对数学、多步逻辑等任务更有利。但这种投入并不保证产出更好:对于格式约束强、结构简单或模型本身已掌握的任务(如生成一段 SVG),额外的思考 token 可能只是在重复确认,甚至因过度“解释”而挤占了真正输出所需的结构化内容。这也是 high 档反而失败、而其他档位正常的原因所在。
效率前沿意味着什么
落在帕累托前沿上,本质上是说任何一维的改进都必须以牺牲另一维为代价。对智能体开发者而言,这意味着 Muse Ember 不是一个“样样都还行”的通用模型,而是一个在成本约束下把能力压到极限的专用件。
它的适用场景非常明确:需要被反复调用成千上万次的路由决策、字段抽取、文档切片解析,以及作为更大智能体系统中的执行层。这些任务单次价值不高,但总量巨大,单价与延迟的微小差异会被调用频次放大成可观的成本差。
长上下文阈值的差异也会影响架构选择。若智能体需要频繁处理超过 200k 的输入,Ember 的价格跳涨会比 Luna 更早触发;反过来,在 100k 到 200k 这一区间,Haiku 5.5 已经进入高价档,Ember 仍停留在低价档。提示长度分布,应该成为选型时的硬性考量。
Meta 此番入场,把 Haiku 级小模型的竞争推向了效率前沿的比拼。对开发者来说,多了一个在帕累托曲线上做取舍的选项;对行业来说,小模型的价值衡量标准正在从参数和基准分数,转向单位任务成本下的实际产出。
帕累托前沿(Pareto Frontier)
帕累托前沿源自经济学中的帕累托最优概念:在一组多目标权衡方案中,若不存在另一个方案能在不使任一目标变差的前提下改善至少一个目标,该方案即处于前沿上。放在模型选型语境里,横轴是成本、纵轴是能力,前沿上的点意味着“要更强就得更贵,要更便宜就得更弱”,二者不可兼得。因此“落在前沿”不是单纯的褒奖,而是对模型定位的精确描述——它把某一成本档位下的能力用到了极限,但也意味着在能力维度上不可能越级。开发者据此判断:前沿点适合作为成本敏感场景的基线,而追求更高能力的任务则应转向前沿之外、价格更高的模型。
长上下文价格阈值与阶梯定价
主流 API 采用按 token 计费的阶梯定价:在某个输入长度以内执行标准价,超过阈值后整段请求(或超出部分)按更高单价计费。阈值的设计源于注意力机制的计算与显存开销随序列长度超线性增长,服务商借此把长上下文的真实成本转嫁给使用者。对智能体而言,这意味着提示长度分布是选型的硬约束:若典型请求集中在 150k,那么 100k 阈值即跳价的模型会显著更贵,而 200k 阈值的模型仍处低位。架构上可通过分块、摘要压缩、检索裁剪等方式把输入压到阈值以下,从而在同等能力下获得数倍的成本差异。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。