Meta开源Muse Spark:美国最强开源权重模型上线Together AI
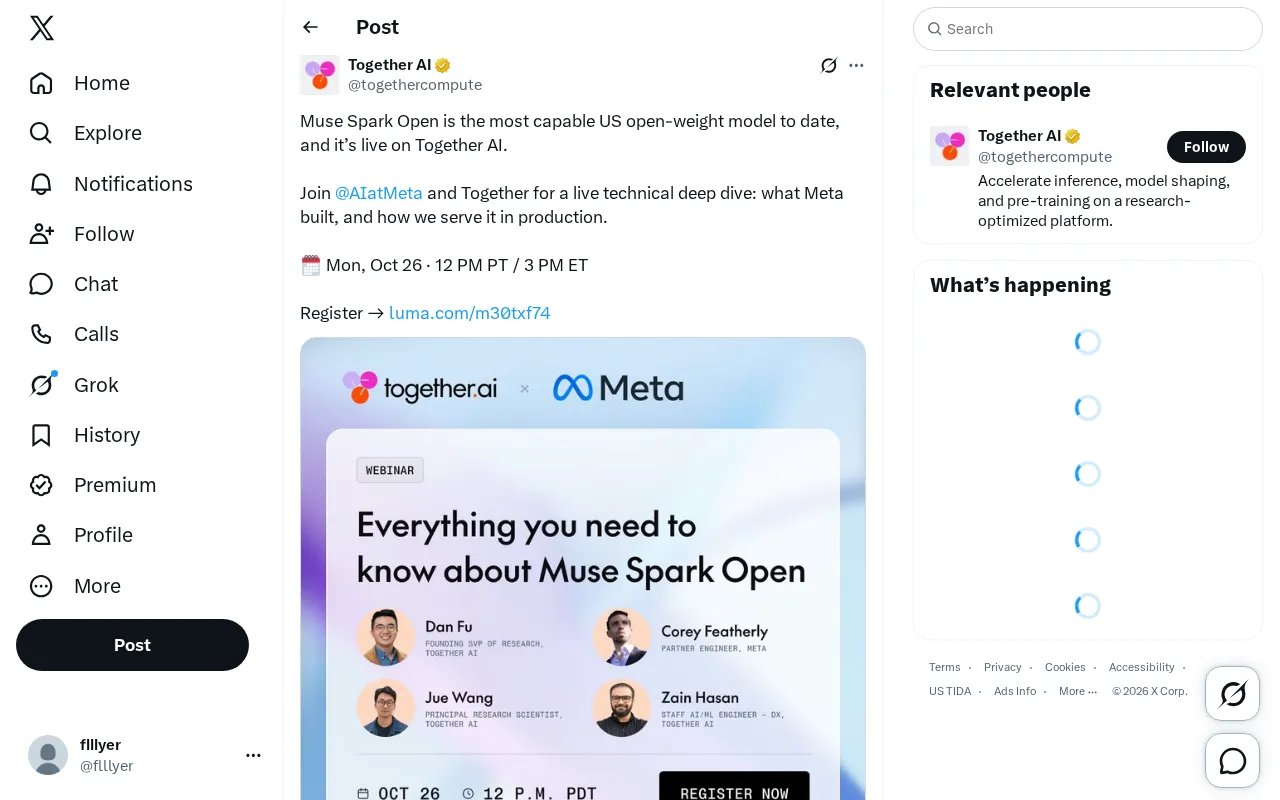
Meta发布自称美国最强开源权重模型Muse Spark Open,并上线Together AI,10月26日联合直播详解。
Meta推出名为Muse Spark Open的新模型,官方称其为"美国迄今最强大的开源权重模型",并已通过Together AI平台正式上线。双方将于太平洋时间10月26日中午12点联合举办线上技术深度解析会,Meta讲解模型的设计与训练思路,Together AI分享生产环境的推理服务实践。公告刻意未披露参数规模、基准测试成绩和许可证细节,这些关键信息可能留待直播揭晓。文章指出,"美国最强"的表述限定了地域范围且仅为Meta单方面宣称,缺乏第三方评测佐证;对开发者而言,参数规模、上下文长度和推理成本才是选型硬指标。Together AI的角色则是把开源权重转化为即开即用的推理服务,降低开发者的基础设施门槛。
Meta在开源AI领域再落一子。名为Muse Spark Open的新模型被官方称为"美国迄今最强大的开源权重模型",并已通过Together AI平台正式上线。据Twitter上的公告,双方将于太平洋时间10月26日中午12点(东部时间下午3点)联合举办线上技术深度解析会,主题围绕"Meta构建了什么"以及"我们如何在生产环境中服务它"。
一场值得关注的技术直播
据公告信息,这场直播由Meta AI官方账号(@AIatMeta)与Together AI联合主办,定于周一(10月26日)举行,时长与具体议程未披露。报名链接指向Together AI官网。从措辞看,直播内容分为两部分:Meta方面讲解模型的设计与训练思路,Together AI方面则分享推理服务的工程实践——后者恰恰是开源模型落地时最容易被忽视的环节。
有意思的是,公告没有给出模型的参数规模、基准测试成绩或许可证细节,这些关键信息可能留待直播中揭晓。
"美国最强开源权重模型"意味着什么
"开源权重"(open-weight)指模型权重可公开下载,但训练数据与代码未必开放。这一定位让Muse Spark Open直接进入与Llama系列、Mistral等模型的竞争区间。Meta称其为"美国迄今最强大的开源权重模型",这一表述刻意限定了地域范围——言下之意,全球范围内仍有更强对手,但美国本土的开源阵营里,Muse Spark Open暂时领先。
这一说法目前仅是Meta的单方面宣称,缺乏第三方评测佐证。对开发者而言,参数规模、上下文长度、推理成本才是选型的硬指标,这些都有待官方进一步公布。
开源权重与开源模型的区别:业界常说的"开源模型"其实包含多个层次。按开放程度由低到高,大致可分为:仅公开推理API(闭源)、公开模型权重(open-weight)、公开训练代码与配置、公开训练数据与完整流程(真正意义上的开源)。Open Weight 模型允许任何人下载权重并在本地部署、微调或二次分发,但训练数据构成、数据清洗流程、分布式训练代码往往不公开,因此无法完全复现。OSI(开源促进会)2024年发布的 Open Source AI Definition 明确要求"可获取训练数据详细信息"才可称为开源AI,这与Meta、Mistral等厂商使用的 open-weight 表述存在显著差异。理解这一区别,有助于评估模型在合规、审计、可复现性方面的真实可用边界。
Together AI的角色:从模型到生产
模型开源不等于可用。Together AI作为推理服务商,负责把Muse Spark Open部署到生产环境,让开发者无需自建GPU集群即可调用。公告中"how we serve it in production"的表述暗示,双方在推理优化上做了针对性工作——可能是量化、批处理调度或显存管理层面的改进。
对希望快速验证模型能力、又不愿承担基础设施成本的团队来说,Together AI的上线意味着多了一个即开即用的选项。
推理服务与推理优化:大模型从权重文件到可供调用的API,需要跨越推理工程这一层。核心环节包括:量化(如INT8/FP8/FP4,将权重与激活压缩以降低显存占用和延迟)、KV Cache 管理(如 PagedAttention 分页管理注意力缓存,减少显存碎片)、连续批处理(continuous batching,动态拼批以提高GPU利用率)、投机解码(speculative decoding,用小模型草稿加速生成)以及张量并行/专家并行等分布式策略。Together AI 这类推理服务商的价值,正是在这些环节上做工程调优,使同一份开源权重在吞吐、延迟和单位token成本上达到可用水平——这也是公告中"how we serve it in production"的实际所指。
开源权重赛道的竞争逻辑
Meta持续加码开源权重模型,背后是生态卡位:当开发者习惯使用某一系列模型,配套工具链、微调方案和社区资源会形成粘性。Together AI这类平台则充当分发渠道,把模型能力转化为可计费的服务。
Muse Spark Open能否兑现"最强"之名,取决于后续的独立评测和真实场景表现。10月26日的直播或许会给出更多答案。
生态卡位与许可证因素:开源权重模型的商业逻辑并不在于出售模型本身,而在于形成开发者生态的正反馈:用户越多,围绕该模型的微调脚本、部署工具、评测基准与社区问答越丰富,迁移成本随之上升,厂商则通过云服务、企业版或配套产品变现。与此同时,许可证条款是选型时容易被忽略却影响深远的变量——Llama 系列采用自定义社区许可证,对月活用户规模设有门槛;Mistral 部分模型采用 Apache 2.0;而 Qwen、DeepSeek广告 等则多采用宽松许可。许可证是否允许商用、是否要求署名、是否限制再分发,直接决定企业能否合规地将模型嵌入产品,因此 Muse Spark Open 的许可证细节值得关注。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。