Meta用500万病历+AI编程助手,两周产出十篇论文

Meta用500万份电子健康记录和AI编程脚手架,让医学专家两周产出十篇研究手稿。
Meta健康工作流团队披露了一项实验:授权获得500万份电子健康记录,搭建名为Muse Wonder的编程脚手架,让医学专家用自然语言提出研究问题并由AI执行数据分析。两周内,专家团队产出十篇研究手稿,其中一人独立完成三篇。协作模式上,专家互相审阅手稿并编写技能文件,使AI脚手架在使用中持续改进。项目强调人类研究者的不可替代性——识别关键变量、解读嘈杂数据的“品味”仍是核心贡献。该实验被置于AI for Science框架下:AI加速的是从原始数据到理解的过程,未来科研重心可能转向通过物理实验收集数据,健康研究者生产力或提升10到100倍。
Meta健康工作流团队最近披露了一个颇具启发性的实验:把一群医学专家、一个强大的编程模型和500万份电子健康记录放在一起,会发生什么?答案是——两周内产出十篇研究手稿,其中一位研究者独立完成了三篇。
实验设计:500万患者数据 + AI编程脚手架
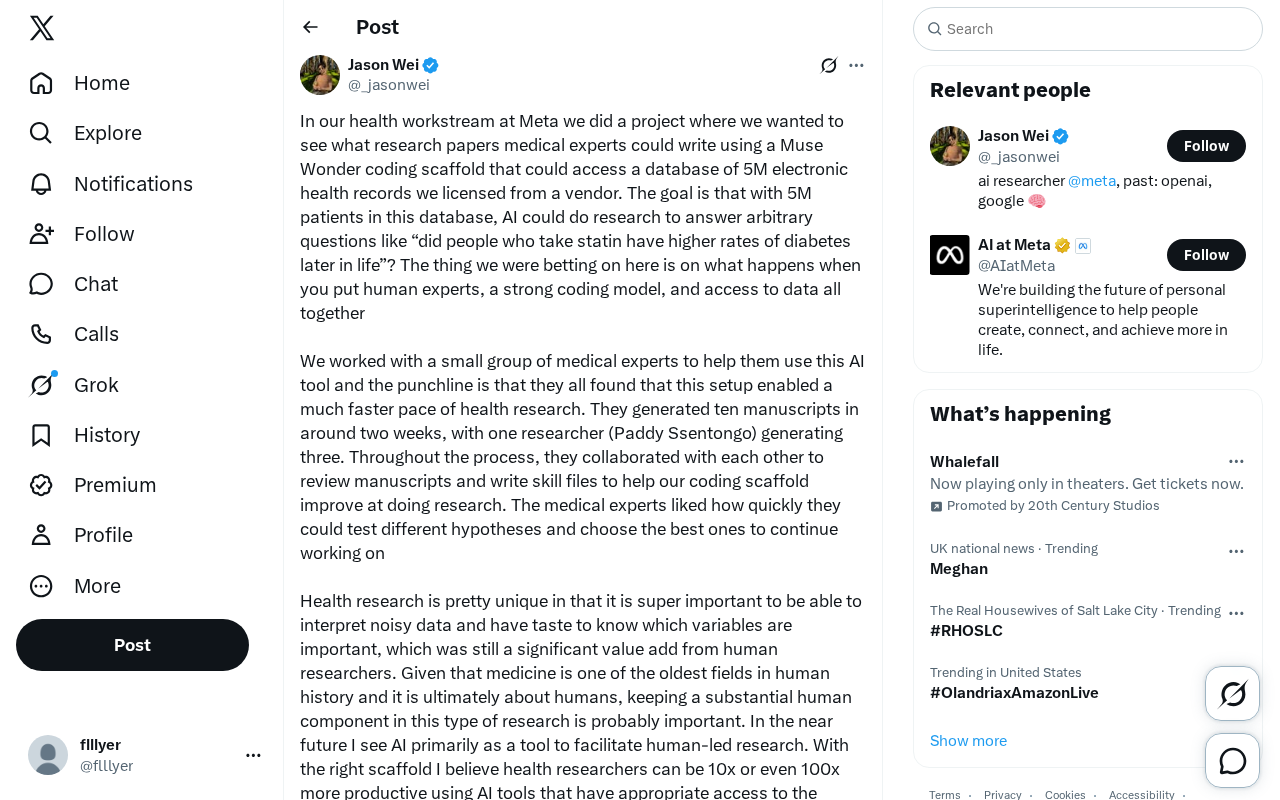
据Meta团队成员在社交媒体上的分享,该项目为其健康工作流的一部分。团队从供应商处授权获得了500万份电子健康记录,并搭建了一个名为Muse Wonder的编程脚手架,让医学专家能够用自然语言提出研究问题,由AI辅助完成数据分析。
举个例子,研究者可以直接提问:“服用他汀类药物的人,后来患糖尿病的比例是否更高?”AI会在庞大数据库中执行分析,快速给出统计结果。
这个项目的核心赌注不是AI能否替代医生,而是当人类专家、强编程模型和数据访问权三者结合时,科研效率能被推到什么程度。
电子健康记录(EHR) 是医疗机构在诊疗过程中生成的数字化患者档案,通常包含诊断编码、用药记录、检验结果、生命体征、手术史等结构化字段,也常混有临床笔记等非结构化文本。EHR的规模优势使其成为观察性研究的重要数据源,例如药物流行病学中的不良反应信号挖掘。但EHR并非为研究而设计:数据缺失、编码不一致、随访中断等问题普遍存在,因此研究者往往需要大量清洗与因果推断方法来控制混杂偏倚。Meta此次获得500万份EHR的授权访问,意味着其AI脚手架面对的是一个真实世界证据(RWE)级别的数据环境,而非理想化的临床试验数据集,这也解释了为何“人类判断力”在流程中仍被反复强调。
两周十篇手稿:速度背后的协作模式
参与实验的医学专家普遍反馈,这种配置让健康研究的节奏明显加快。他们在大约两周内生成了十篇研究手稿,其中研究者Paddy Ssentongo一人就贡献了三篇。
更重要的是协作方式的变化。专家们互相审阅手稿,并编写“技能文件”(skill files)来帮助编程脚手架在研究任务上持续改进。换句话说,AI工具本身也在被使用过程中不断优化。
医学专家们特别提到的一点是:他们可以快速测试不同假设,然后挑选最有价值的方向深入下去。这种“快速试错、择优推进”的节奏,在传统研究流程中往往需要数月才能完成一轮。
技能文件(skill files) 在此语境下可理解为一种面向AI编程脚手架的“可复用指令集”或“微调提示包”:研究者把反复出现的研究操作——如特定变量的标准化提取、缺失值处理规则、统计模型选择偏好——写成结构化文档,供脚手架在后续任务中调用。这与传统“提示词工程”的区别在于,技能文件更接近团队内部的方法论沉淀,可以在不同研究者之间共享、版本化并逐步迭代。当专家编写技能文件时,他们实际上是在把隐性研究经验外化为AI可执行的规则,从而让脚手架在特定领域内越用越“顺手”。这种机制也部分解释了为何两周内能产出十篇手稿:重复性分析步骤被前置封装,研究者只需聚焦假设设计与结果解读。
人类研究者仍然不可替代
尽管AI表现亮眼,该项目也明确指出人类专家的核心价值。健康研究的独特之处在于,面对嘈杂的数据,研究者需要有判断力去识别哪些变量真正重要——这种“品味”目前仍然是人类研究者的重要贡献。
Meta团队对此保持了审慎态度:医学是人类最古老的领域之一,研究的最终对象是人,因此在这类研究中保留相当比例的人类参与,可能是必要的。
在可预见的未来,AI更多是促进人类主导研究的工具。但如果配备合适的脚手架,并让AI获得适当的数据访问权限,健康研究者的生产力可能提升10倍甚至100倍。
AI for Science:从数据到理解的加速
这个项目可以放在“AI for Science”的更大框架下理解。科学活动可以拆成两部分:一是收集关于世界的原始数据,二是将原始数据综合为理解。
这个项目的前提是数据已经存在,目标是用AI加速第二部分。Meta团队设想了一个远景:当AI工具足够强大,将原始数据转化为理解的时间趋近于零。在那样的世界里,科学进展会大幅加速,大部分工作将集中在通过物理实验收集正确的原始数据上。
这次实验在很短时间内完成,本身就是刻意的——它想验证的就是速度。而结论是:科学研究的未来,可能会比现在更快、也更令人兴奋。
AI for Science 是近年来兴起的研究范式,核心主张是将机器学习、大模型与自动化实验平台嵌入科学发现的全流程,而非仅作为事后数据分析工具。其典型代表包括AlphaFold在蛋白质结构预测上的突破、GNoME在材料发现中的应用,以及各类实验室自动化闭环。这一范式的关键区分在于:AI既可以加速“从数据到假设”的归纳环节,也可以优化“从假设到验证”的实验设计环节。Meta健康工作流项目明确将自己定位在前者——它默认原始数据已经存在,专注于压缩从数据到理解的时间。这一路线的局限同样明显:如果原始数据本身存在测量偏差或覆盖不足,AI加速的只是对既有数据的解释,而非对世界的新观测。因此,AI for Science的长期价值取决于数据采集与AI推理两条腿能否同步进化。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。