Meta追上Anthropic了?Muse Wonder实测解析

Meta新模型Muse Wonder Full跑分跃居第三,实战编排强但短板明显。
Meta发布的Muse Wonder分基础版与Full版:Full版在Artificial Analysis榜单上击败所有OpenAI模型位列第三,却仅通过订阅提供、无公开定价;基础版开放API但性能落后Full版逾30%。实测显示,Muse Wonder在子代理编排和输出可读性上表现突出,日常编码任务中能清晰分派任务、简洁给出根因,但在3D建模与前端UI上表现糟糕。创作者认为Full版已达「frontier-ish」水准,可作为日常主力模型,标志着前沿模型竞赛出现了OpenAI、Anthropic之外的第三个实质玩家。
Meta追上Anthropic了?Muse Wonder实测解析
什么让Muse Wonder值得关注
长久以来,前沿大模型的第一梯队几乎被OpenAI和Anthropic牢牢占据。Meta虽然一直在迭代Spark系列,但始终未能真正跻身「同一档」的讨论。而这一次,情况似乎发生了变化。
一位长期追踪模型表现的YouTube创作者在连续数日实测Meta新发布的Muse Wonder后给出了相当高的评价。他在Artificial Analysis上看到的结果是:Muse Wonder Full Max跑分不仅远超此前的Spark 1.3,还击败了所有OpenAI模型,位列整体第三。这个成绩放在过去几乎不可想象。
但他也强调自己并未拿Meta一分钱,只是提前拿到了测试权限。真正打动他的并非跑分,而是在日常编码工作中那些「没法被基准测试量化」的体验。
Artificial Analysis 是一个被业界广泛引用的第三方大模型评测平台,它通过聚合多项公开基准(如 MMLU、GPQA、编码能力、数学推理等)并计算综合得分,对各家模型进行横向排名。与厂商自报的跑分不同,它的价值在于评测口径统一、可跨模型对比,因此常被用来判断一款模型是否真正跻身第一梯队。不过需要注意,这类综合榜单高度依赖所选基准的权重与覆盖范围,对长任务稳定性、指令遵循质量、输出可读性等难以量化的维度反映有限。这也正是文中创作者强调「真正打动他的并非跑分」的原因——榜单能告诉你模型大致处在什么位置,却无法替代真实工作流中的实测体验。
命名与定价:Meta的老毛病
Meta这次在产品命名和定价透明度上再次暴露了不成熟。
Muse Wonder实际上分为两个版本:Muse Wonder和Muse Wonder Full。后者速度约为50 tps,而基础版约为120 tps。问题在于,只有基础版Muse Wonder开放了API并公布了价格——每百万输入4美元、输出20美元。Full版本仅通过Muse Code订阅提供,完全没有公开定价。
这直接导致一个严重后果:你无法对Full版本做任何价格与性能的对比分析。而恰恰是Full版本在各种基准测试中展现了最强的成绩。创作者用「cringe」形容这种做法,认为Meta还没有习惯拥有一款足够好的模型。
真实编码场景中的表现
编排能力出人意料
在日常测试中,创作者发现Muse Wonder在作为「指挥官」调度其他模型时表现优异。它能清晰地向子代理描述任务范围、要求和约束条件——「不要引用你没有打开过的文件」「不要编辑任何文件,仅做分析」——这种提示质量在其他非Anthropic/OpenAI实验室的模型中很少见到。
他搭建了一个名为TS Rust的编译器项目,在其中同时运行Muse和Opus进行对比。经过115个以上代理的协作,Muse承担了大部分常规修复工作,而Opus负责高风险的设计决策。最终Opus给Muse打了B+,给自己打了A-。
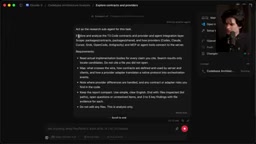
子代理(sub-agent)编排 是当前代理式编程中的一种流行架构:一个「主控模型」负责理解高层目标、拆解任务、分派给多个专职子代理并行执行,自身则充当调度者和审查者。这种做法能突破单个模型上下文长度和单线程推理的限制,把复杂工程拆成大量可并行的子任务。其成败关键往往不在子代理本身,而在主控模型能否写出高质量的委派指令——比如明确划定任务边界、禁止越权操作、要求引用真实文件等。指令写得含糊,子代理就会跑偏甚至产生幻觉式的修改;写得清晰,整体效率可以成倍提升。因此「编排能力」正逐渐被视为衡量前沿模型工程实用性的核心指标之一。
可读性与实用性
在一项具体调试任务中,创作者让Muse、Sol和Opus分别处理同一个远程更新失效的bug。结果对比鲜明:Sol完全误判了问题所在,Opus花了大量篇幅但输出冗长,而Muse用极简的格式给出了清晰的根因分析和修复建议——甚至还找到了另一个开发者已经提交的、更简洁的修复PR。
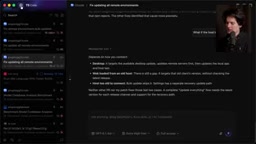
这种「可读性」在创作者看来是Muse Wonder最被低估的优势,也是任何基准测试都无法衡量的能力。
跑分与实测数据
在创作者自制的代码审计基准中,Full版本与Astra和Fable表现接近,而基础版Muse Wonder的得分几乎只有Full版本的一半——超过30%的差距。这意味着如果通过API调用基础版来做复杂任务,体验会大打折扣。
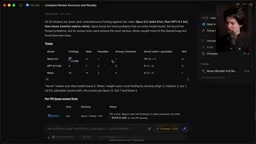
一项PR审查对比显示,Opus发现23个有效问题(含8个nits),Sol仅发现9个,而Muse以16个发现处于中间位置——在噪音控制与覆盖面之间找到了不错的平衡。
tps(tokens per second,每秒生成令牌数) 是衡量模型推理速度的核心指标,直接决定交互体验。一般而言,低于 30 tps 的模型会让人明显感到等待,60–100 tps 可满足大多数对话与编码需求,达到 100 tps 以上则相当流畅。文中基础版 Muse Wonder 约 120 tps、Full 版约 50 tps 的差异值得关注:Full 版本在基准测试中更强,却因速度较慢、且仅通过订阅提供而缺乏价格透明度。这提示我们,模型选型不能只看单次回答的智能水平,还要把吞吐速度、成本与稳定性一起纳入考量——对于需要大量代理协作的长任务,速度劣势会被显著放大。
短板同样明显
3D与前端的灾难
Muse Wonder在3D建模和前端UI方面表现糟糕。创作者测试其生成3D游戏和Blender模型时直言「垃圾」。Meta自己在模型限制说明中也承认,视觉和空间推理——特别是3D任务——是已知的薄弱环节。
他借此提出一个更广泛的观察:近期模型在3D能力上的跃升并非源于模型「变聪明了」,而是某些实验室专门在后期训练中加入了3D环境。这是一种针对性训练的结果,而非智能涌现。
后期训练(post-training)中的针对性环境注入 是理解近期部分模型能力跃升的关键。所谓后期训练,指在预训练之后通过监督微调、强化学习等手段塑造模型行为。如果厂商在强化学习阶段大量引入特定环境(例如 3D 场景、Blender 脚本、游戏引擎接口)作为可交互的反馈信号,模型就会在这些具体任务上被「练」得很熟。这种提升属于定向优化,而非通用智能的自然涌现。它解释了为何某些模型在 3D 生成上突飞猛进,却在其他领域毫无进步,也提醒我们:评估一款模型时,要区分哪些能力来自专门训练、哪些来自可迁移的通用推理——前者往往边界清晰、迁移性差。
基础版不值得选
综合来看,创作者认为基础版Muse Wonder在当前定价下毫无竞争力。网上很多人用API接入基础版后得到的糟糕体验,很可能正在误导公众对Meta这次发布的整体评价。
为什么这仍然重要
抛开产品层面的粗糙,Muse Wonder Full带来的真正意义在于:前沿模型竞赛中出现了第三个玩家。创作者用「frontier-ish」来形容它——不那么完美,但在长篇任务、多代理编排和稳定性方面已经够格。
他甚至愿意让它做日常主力模型,只在关键任务时叫Opus来复核。这种格局上的变化,对于整个AI行业的竞争与成本优化而言,远比一两个跑分更有价值。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。