免代理网页转Markdown API:RAG管道实战选型
小规模RAG管道选网页转Markdown API,应重稳定、失败语义与输出一致性而非极致质量。
文章围绕单人维护的 RAG 管道(每周约 500 页)如何选择网页转 Markdown API 展开。作者指出,自建无头浏览器与代理基础设施的隐性运维成本远高于托管 API 订阅费,因此「无聊的稳定」——URL 进、干净 Markdown 出、JS 渲染可用、失败时明确报错——才是核心诉求。社区争议集中在不同提供商的 Markdown 质量差距是否真实,文章认为差距确实存在,主要体现在 boilerplate 剥离、代码块保真度、表格结构和标题层级还原上,但二十页样本不足以支撑结论。作者建议用 30-50 个真实页面建立小型评测集,并从 JS 渲染覆盖率、失败语义、速率限制、输出一致性和价格模型五个维度选型,最终找到行为可预测的务实方案。
为什么你需要一个「无聊」的网页转Markdown API
如果你正在搭建 RAG 管道,一定遇到过这个场景:每周需要处理几百个网页,希望 URL 输入后直接得到干净、结构化的 Markdown,JS 渲染的页面也能正常工作,失败时明确报错而不是返回一个 200 状态码的空壳。你不想自己维护浏览器实例,不想管理代理池,更不想在凌晨三点被 Chrome 版本更新导致的容器 OOM 告警叫醒。
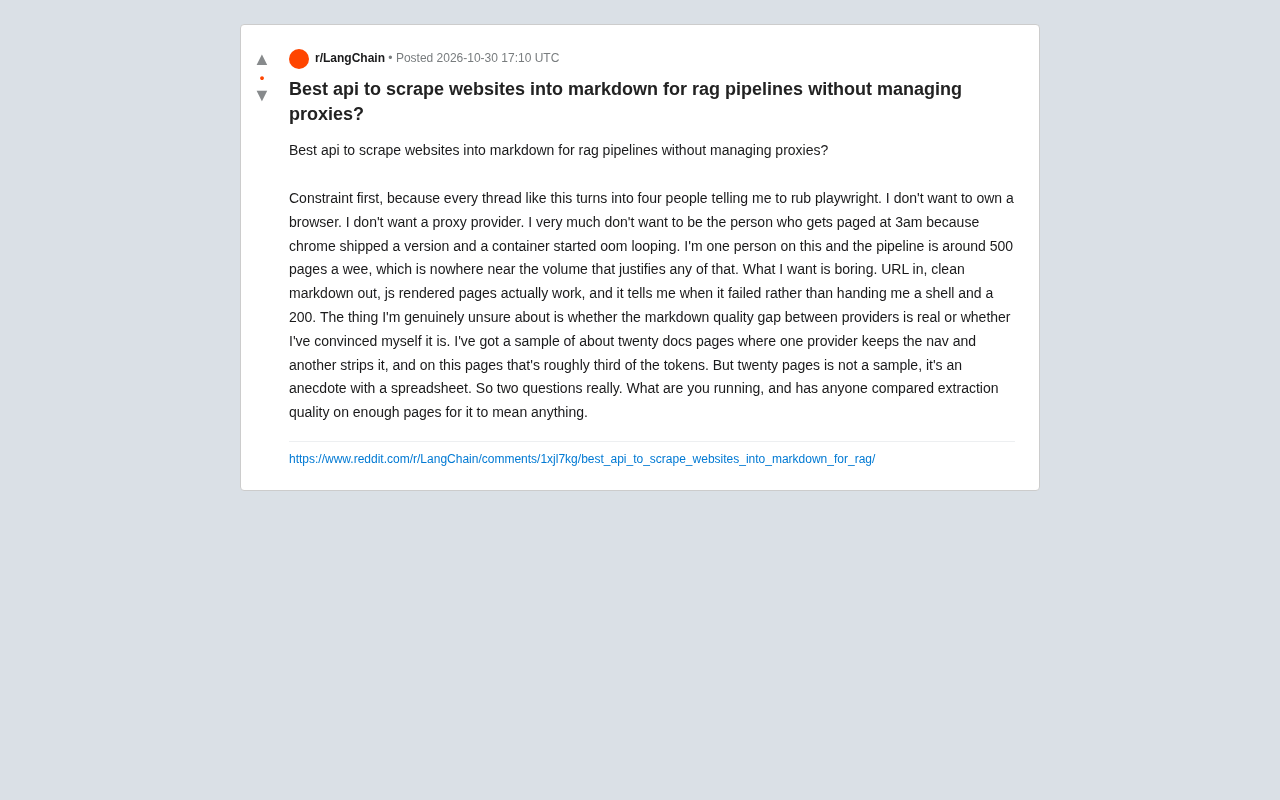
Reddit 上一位开发者的提问精准地概括了这种需求:「每周大约 500 页,完全没必要为此搭建一套复杂的抓取基础设施。我想要的是一种无聊的稳定——URL 进,干净的 Markdown 出,JS 渲染的页面真的能工作,失败时告诉我,而不是给我一个 shell 和一个 200。」 这段描述来自一个单人维护的 RAG 管道,规模不大,但对可靠性和输出质量有明确要求。
社区讨论中反复出现的一个核心争议是:不同提供商之间的 Markdown 提取质量差距,到底是真实存在的,还是心理作用?这位开发者用大约二十个文档页面做了对比,发现一个提供商保留了导航栏,另一个将其剥离,而在这些页面上,导航部分大约占了三分之一的 token。但他自己也承认:「二十个页面不是样本,只是一个带表格的轶事。」
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种将信息检索与大型语言模型结合的技术架构:系统先从外部知识库中检索出与用户问题相关的文档片段,再将这些片段作为上下文交给 LLM 生成回答。RAG 管道的典型流程包括文档采集、清洗切分、向量化嵌入、存储索引和检索生成几个阶段。本文讨论的网页转 Markdown 属于采集与清洗环节——原始 HTML 包含大量导航、广告、脚本等噪声,直接嵌入会污染向量空间、降低检索命中率。将网页转换为结构化的 Markdown,正是为了让后续的切分和嵌入获得语义清晰、噪声可控的输入,因此这一环节的输出质量会沿管道向下传导,直接影响最终回答的准确性。
自建 vs 托管 API:成本与复杂度的权衡
在讨论具体方案之前,先算一笔账。每周 500 页的抓取量,平均每天不到 100 页。如果自建,你需要一台能跑无头浏览器的服务器,处理 Chrome 更新、内存泄漏、代理轮换、反爬策略变化。这些工作的隐性成本远高于托管 API 的订阅费用。
托管 API 的核心价值在于把「浏览器运维」和「代理管理」这两件事从你的待办清单上彻底移除。你只需要关注输入和输出:URL 进去,Markdown 出来。对于单人项目或小团队来说,这种抽象层次的提升直接决定了管道能否长期稳定运行。
社区中有人提到,一些提供商在 JS 渲染上表现不稳定,尤其是面对大量动态加载内容的页面时。另一些人则强调,真正的区分点不在于「能不能渲染」,而在于「渲染后提取的内容是否保留了语义结构」——标题层级、列表、代码块、表格,这些元素对 RAG 的检索质量影响很大。
无头浏览器(Headless Browser) 指没有图形用户界面的浏览器实例,如 Chrome Headless、Playwright、Puppeteer,可在服务器上以编程方式加载页面并执行 JavaScript,从而获取动态渲染后的 DOM。许多现代网页的内容依赖 JS 异步加载,单纯的 HTTP 请求只能拿到空壳 HTML,因此抓取 JS 渲染页面通常需要无头浏览器。但无头浏览器的运维负担不轻:每个实例占用数百 MB 内存,长时间运行易出现内存泄漏,Chrome 版本更新可能破坏兼容性,并发抓取时还需管理实例池。这正是文中「凌晨三点被 OOM 告警叫醒」的技术根源,也是托管 API 把浏览器运维抽象掉的核心价值所在。
Markdown 质量差距:真实存在还是心理作用?
回到那个核心问题:不同 API 输出的 Markdown 质量差距有多大?
从社区反馈来看,差距确实存在,但体现在细节上。最常见的差异包括:
- 导航与页脚的保留策略:有的提供商会保留网站导航、侧边栏、页脚等 boilerplate 内容,有的会自动剥离。对于 RAG 来说,剥离通常更优,因为导航文本会稀释嵌入向量中的有效信息。
- 代码块的处理:技术文档中的代码块如果被错误地格式化为普通文本,检索时的语义匹配会显著下降。
- 表格结构:Markdown 表格的保留程度直接影响结构化信息的可用性。
- 标题层级:H1-H6 的准确还原决定了文档切分时的边界判断。
那位开发者观察到的「三分之一 token 被导航占据」的情况,如果属实,意味着嵌入成本和检索噪声都会大幅增加。但正如他所说,二十个页面的样本量不足以得出统计显著的结论。
这里有一个实用的建议:建立自己的小型评测集。选取 30-50 个你实际需要抓取的页面类型(文档页、博客、产品页、论坛帖子),对每个候选 API 的输出做人工评分,重点关注 boilerplate 剥离、代码块保真度、表格完整性和标题层级。这个工作量不大,但能给你超越「轶事」级别的决策依据。
Boilerplate(样板内容) 指网页中与主体信息无关、在大量页面上重复出现的结构性元素,包括全局导航栏、侧边栏、页脚、版权声明、Cookie 提示等。对 RAG 管道而言,boilerplate 是有害噪声:它会被一并切分和嵌入,稀释有效信息的向量表示,增加嵌入成本,并在检索时引入与问题无关的匹配。因此,网页转 Markdown 服务是否具备 boilerplate 剥离能力,是衡量输出质量的关键指标之一。剥离策略也存在权衡——过度剥离可能误删正文中的目录或相关链接,保守剥离则残留噪声,不同提供商在这条光谱上的位置不同,这也是社区评测结论分歧的原因之一。
选型 checklist:从需求倒推方案
根据社区讨论和实际管道需求,可以从以下几个维度评估托管 API:
1. JS 渲染的真实覆盖率
不是所有「支持 JS 渲染」的 API 都一样。有些只在检测到特定框架时才启动浏览器,有些则对所有页面都走浏览器路径。你需要确认的是:对于你目标站点中依赖 JS 加载内容的页面,输出是否完整。
2. 失败语义
好的 API 应该在抓取失败时返回明确的错误码和原因,而不是返回空内容或一个包含错误信息的 HTML 页面。社区中有人抱怨某些服务「给你一个 shell 和一个 200」,这正是 RAG 管道最怕的情况——垃圾进,垃圾出,而且你毫不知情。
3. 速率限制与并发
每周 500 页的量不大,但如果你需要批量回填历史数据,短时间内的并发能力就变得重要。确认 API 的速率限制策略,以及是否支持异步任务模式。
4. 输出一致性
同一站点不同页面的输出格式是否稳定?如果今天保留导航、明天又剥离,你的文档切分逻辑就需要不断调整。一致性比绝对质量更重要。
5. 价格模型
按页计费还是按 token 计费?对于 Markdown 输出,按页计费通常更可预测。注意隐藏成本,比如 JS 渲染页面是否额外收费。
社区共识与分歧
综合多个讨论来源,以下几点形成了较高共识:
- 对于小规模管道(每周几百页),托管 API 的总体成本低于自建。
- 代理管理是自建方案中最容易被低估的复杂度来源。
- 输出 Markdown 的 boilerplate 剥离能力是区分提供商的关键指标之一。
分歧则集中在:
- 哪家提供商的质量最好:不同开发者的评测集不同,结论差异较大。有人推崇极简输出,有人则需要保留更多上下文。
- 是否需要自己后处理:一部分开发者认为任何 API 的输出都需要二次清洗,另一部分则期望开箱即用。
- JS 渲染的必要性:对于静态文档站点,是否需要为 JS 渲染能力付费存在争议。
结论:先定义「干净」,再选工具
在选型之前,先明确你的 RAG 管道对「干净 Markdown」的定义。是要求零 boilerplate,还是允许保留少量上下文?代码块和表格的保真度优先级有多高?失败时你希望收到什么信号?
对于每周 500 页的单人管道,最务实的路径是:选取 2-3 个候选托管 API,用你真实的 30-50 个页面做一轮对比评测,重点看 boilerplate 剥离、代码块和表格处理、失败语义。不要追求「最佳」,而是找到那个输出行为可预测、失败时让你知道的「无聊」选项。毕竟,凌晨三点不被叫醒,本身就是一种核心竞争力。
失败语义(Failure Semantics) 指系统在出错时以何种方式表达失败——是返回明确的错误码和原因,还是静默返回空内容或伪装成成功的响应。对自动化管道而言,失败语义的清晰度往往比功能覆盖更重要:一个返回 200 状态码但内容为空的响应,会让管道把垃圾数据当作正常输入继续处理,错误在下游才暴露,排查成本极高。理想的失败语义应区分网络超时、目标站点反爬拦截、JS 渲染失败、内容解析失败等不同原因,并配套可重试与不可重试的分类,使调用方能够据此决定重试、降级还是告警。评估候选 API 时,应主动构造失败场景(如不存在的 URL、需登录的页面)来检验其行为。
相关推荐
Jetpack Compose如何将输入交互扩展至触屏之外
Jetpack Compose团队详解如何将输入支持扩展到触屏之外:指针事件六阶段管线、触控板假手指拦截与重解释、智能眼镜一维手势导航,以及配套测试API。
微软放弃Copilot电视端:一场无人问津的AI实验
微软结束智能电视Copilot支持,距LG三星宣布接入仅两年。功能以网页链接形式呈现,体验粗糙,折射AI助手盲目扩张终端的困境。
小模型智能体编程:成本降百倍,成功率翻倍
探索如何利用小语言模型构建高效的智能体编程工作流,在成本、隐私和延迟之间取得平衡。了解小模型的类型、本地运行优势、评估方法及实战技巧,实现成本降百倍而成功率翻倍。