小模型智能体编程:成本降百倍,成功率翻倍
Google团队分享如何用小语言模型构建低成本、可本地运行的智能体编程工作流,并与前沿模型编排互补。
文章基于Google团队演讲,探讨用小语言模型(SLM)构建智能体编程工作流。小模型成本可比前沿模型低20-200倍,Gemma 4在测试集上能独立解决约53%的任务。本地运行带来隐私、低延迟、零边际成本和离线可用四大优势,量化技术可将内存需求减少75%。评估需覆盖模型、推理引擎、框架和硬件整个技术栈,上下文配置不当可使成功率减半。通过优化上下文窗口、添加验证提示等技巧,成功率可从26%提升至53%。编排策略(级联、顾问模型、委员会)能结合两类模型优势,实现成本与质量的平衡。
在AI编程领域,前沿大模型(如Gemini系列)的能力令人惊叹,但对于许多日常开发任务,它们可能过于昂贵甚至“杀鸡用牛刀”。一场来自Google团队的演讲深入探讨了如何利用小语言模型(SLM)构建高效的智能体编程工作流,在成本、隐私和延迟之间找到平衡点。
小模型不是替代品,而是互补工具
演讲者Jose用一个生动的比喻开场:前沿模型是火箭,小模型是自行车。火箭虽快,但自行车在短途通勤中往往更高效。他们强调,小模型并非要取代大模型,而是作为补充,尤其当模型开源、权重可下载时,优势更为明显。
成本差异是直观的。在一个包含200个中高难度任务、消耗近1.31亿token的数据集上,使用Gemma 4的成本不到9美元(通过商业网关调用,若本地运行则免费),而前沿模型的成本可能高出20到200倍,具体取决于token缓存等因素。
但成本并非唯一考量。在同一个数据集上,Gemma 4能独立解决约53%的任务。这意味着,如果你用前沿模型处理所有任务,可能造成浪费;而如果只用小模型,则需要引导或换用更大模型。关键在于找到合适的场景。
了解你的工具箱:小模型种类繁多
在决定使用哪种模型前,需要先了解有哪些选择。演讲者Zoe指出,大多数人想到语言模型时,首先想到的是自回归模型,它基于输入token逐个预测下一个最可能的token。但模型种类远不止于此。
扩散模型(如Diffusion Gemma)一次处理256个token的块,类似于先勾勒草图再逐渐聚焦,能降低延迟。嵌入模型则将文本或图像转换为向量,通过计算距离来比较概念相似性,例如判断“热狗是不是三明治”只需简单的数学运算。
此外,还有专精于单一任务的模型:函数调用模型将自然语言转为API调用,视觉模型处理图像,分类器则对输入进行评分。这些模型尺寸、上下文窗口和内存占用各异,选择时需要根据任务需求权衡。
自回归模型是当前绝大多数语言模型(包括GPT、Gemini、Llama系列)的基础架构。其核心机制是“逐token预测”:给定前文,模型输出下一个词的概率分布,采样后再作为输入继续预测,直到生成结束符。这种串行生成方式天然带来延迟,因为每个token都依赖前一个token的计算结果。相比之下,扩散模型一次并行处理一个token块(如256个),通过多轮“去噪”逐步细化输出,在需要低延迟的场景(如代码补全)中具有潜在优势,但目前在长文本连贯性上仍不及自回归模型成熟。理解这一区别有助于判断何时该用哪种模型。
本地运行小模型的四大优势
为什么选择本地模型?演讲者Ian总结了四点:
- 隐私:API密钥、专有代码等敏感数据无需离开本地。
- 低延迟:模型加载到内存后,响应无需网络往返。
- 零边际成本:本地运行的重试和错误循环不会产生额外费用。
- 离线可用:在飞机、火车等无网络环境下仍能工作。
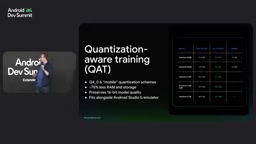
然而,本地运行面临内存和速度两大挑战。大型模型(如26B、31B参数)在BF16精度下需超过50GB显存,难以在普通硬件上运行。量化技术可将精度降低(如4位),使内存需求减少75%,从而适配统一内存的Mac等设备。
量化感知训练(QAT)能在压缩模型的同时减少精度损失。针对移动端,混合量化方法可将模型进一步缩小,例如从7.4GB的Gemma E2B压缩到1.1GB,使其能在中高端手机上运行。
速度方面,投机解码(speculative decoding)利用小模型预测多个token,再由大模型验证,共享KV缓存,在编码等可预测任务中可实现约3倍加速且不损失质量。
量化是指将模型权重和激活值从高精度浮点数(如BF16/FP16,每参数2字节)转换为低精度表示(如INT8、INT4,每参数1或0.5字节)的过程。常见的训练后量化(PTQ)直接对已训练好的模型做精度截断,实现简单但可能损失精度;量化感知训练(QAT)则在训练阶段就模拟量化误差,让模型学会补偿,从而在同等压缩率下保留更多能力。4位量化可将内存占用降至BF16的约四分之一,使原本需50GB以上显存的模型能跑在32GB统一内存的Mac上。但量化并非无损,位宽越低、任务越复杂,精度下降越明显,因此需要结合具体任务评估量化后的实际表现。
投机解码(speculative decoding) 是一种加速自回归生成的推理优化技术。其思路是:用一个更小、更快的“草稿模型”先连续预测多个候选token,然后让目标大模型在一次前向传播中并行验证这些token——接受匹配的部分,拒绝不一致的部分并从拒绝处重新采样。由于大模型验证多个token的计算成本与生成单个token相近,整体吞吐量可显著提升。关键在于草稿模型与目标模型共享词表和KV缓存,且草稿预测的接受率越高,加速越明显。编码任务因语法和模式高度可预测,接受率通常较高,因此能获得约3倍加速且输出质量与原始模型完全一致(因为最终由大模型把关)。
如何评估小模型:超越基准分数
Ian强调,单纯看基准分数(如Live Code Bench)只能提供高层指标,真正需要评估的是整个技术栈:模型(权重和量化方式)、推理运行时(如Ollama、LightRT)、智能体框架(如pi、OpenCode)以及上下文窗口。
一个实际案例:在Android Bench测试中,使用Ollama默认的32K上下文时,智能体框架的压缩机制会将文件移出内存,导致任务失败。将上下文提升到256K后,模型能保持文件在内存中,该任务的成功率翻倍。
因此,他们提出了“Are We There Yet?”框架,从模型、推理引擎、框架和硬件配置四个维度评估任务就绪度,考虑可靠性、延迟和内存占用等因素,最终给出绿、黄、红评分。
上下文窗口指模型单次推理能处理的最大token数(输入加输出)。当智能体工作流中的对话历史、文件内容和工具输出累计超过该窗口时,框架必须采取压缩策略:截断旧消息、摘要历史或把文件移出上下文。这些机制在长任务中极易导致模型“忘记”关键文件或指令,从而任务失败。将上下文从32K提升到256K,本质上是减少了触发压缩的频率,让模型在完整信息下工作。但更大的上下文也意味着更高的内存占用和更慢的推理速度,因此需要根据任务类型和硬件条件权衡配置,而非一味求大。
实战:小模型在Android开发中的表现
Jose将任务按难度分为四类:小任务、中任务、大任务和长周期任务。小模型在小任务上表现优异,例如Compose基础优化(一行代码修改,耗时3分钟)。中任务如修复Pocket Casts中的请求错误和重试逻辑,耗时10分钟,修改3个文件,成本仅0.06美元(通过OpenRouter)。
但小模型也有局限。在一个失败的中任务中,模型几乎正确实现了所有逻辑,却假设初始同步值为-1(实际为0),且未运行现有单元测试验证。这反映出小模型倾向于“提前停止”,不会像前沿模型那样主动追求完美。
大任务中,约一半能通过,但有些失败案例显示模型“完成了90%”,却遗漏了关键需求(如畸形URL解析时未添加测试用例)。小模型会遵循指令,但不会“试图让你印象深刻”。
对于长周期任务(如迁移整个应用、从零构建复杂应用),前沿模型在Android Bench v2上的成功率也仅有3%到40%,小模型显然力不从心。但可以通过路由将初步分析交给前沿模型,再将简单任务级联给小模型,实现成本效益。
优化小模型工作流的实用技巧
要提升小模型表现,有几个简单且有效的调整:
- 正确配置上下文窗口:例如Ollama默认32K,但Gemma 4支持8倍。在评估中,启用完整上下文使结果从26%提升到53%。
- 使用Android CLI:对于新API或小众API,直接搜索文档比网络搜索更有效。
- 添加验证提示:在agents.md中告知模型如何运行测试、管理模拟器等,但避免过长的文件,以免降低性能。
- 增减示例:小模型可能需要更多时间,但对于新API,提供示例有助于理解;对于通用基础,则避免填充过多示例。
编排:让自行车和火箭协同工作
Zoe介绍了编排的多种用途:通过备用模型避免服务中断或速率限制;让小模型在需要时咨询“顾问”模型;让多个模型组成“委员会”同时执行任务并评估结果;用另一个模型进行同行评审;以及通过级联实现成本效率——例如用前沿模型规划,小模型执行,再用另一个模型测试。
编排可以手动设置,也可以使用轻量级LLM代理或分类器自动路由。最终,小模型与前沿模型之间的质量差距并非固定不变,而是可以通过工程手段来弥补。
结语
小模型智能体编程工作流的核心在于:选择合适的工具,调整任务范围,测试整个系统,并灵活编排。通过开源小模型如Gemma 4,开发者可以在本地获得隐私、低延迟和零边际成本的优势,同时利用编排与前沿模型互补,实现高效能的AI辅助开发。正如演讲者所言,你可以同时拥有自行车和火箭,关键在于如何搭配使用。
相关推荐

零基础用Claude Code搭建AI Agent:从工作区到云端自治
无需编程,用Claude Code桌面应用四步搭建AI Agent:从工作区配置、Agent Designer生成第一个智能体,到Skill固定流程、Memory自我进化,最终部署云端定时自治运行。

无需Python基础:Cursor AI编程如何重塑自动化测试与测试开发
测试工程师不学Python也能做自动化测试?本文梳理Cursor等AI编程工具如何赋能功能测试、自动化脚本、测试平台开发与性能调优,并对比国内外主流工具的成本与访问限制,给出测试人员的能力转型建议。

近5000人中招!AI编程插件被植入后门,官方紧急下架
Claude Code的VS Code扩展2.1.313版本被恶意篡改,植入后门可远程登录并持久化控制,最多5000名用户或受影响。官方已下架恶意版本,本文详解攻击手法与清理步骤。