免费AI编程模型可行吗?工业级代码生成的现实选择
探讨个人开发者能否仅凭免费AI模型产出商用级代码,并给出多提供商轮换与本地部署的组合策略。
一位开发者在Reddit提问:能否只靠免费AI模型完成可商用、可发布的工业级软件开发?文章围绕这一问题梳理了免费AI编程服务的三大核心痛点——频繁触发的429限流错误、免费层推理能力受限,以及动辄数天的冷却等待期。针对这些约束,文章提出分层组合策略:日常开发通过OpenRouter、Groq等多提供商轮换规避单点限流;对隐私要求高或需要稳定吞吐的场景,本地部署Qwen Coder、DeepSeek Coder等开源模型可彻底绕开所有限流;而真正面向公众发布的核心代码,则值得保留少量付费预算以确保质量。文章最终结论是:完全零成本持续产出商用级软件是理想化的,但通过分层策略与工具组合,个人开发者的绝大多数实际需求可以被满足。
问题的起点:用免费模型做商业级软件
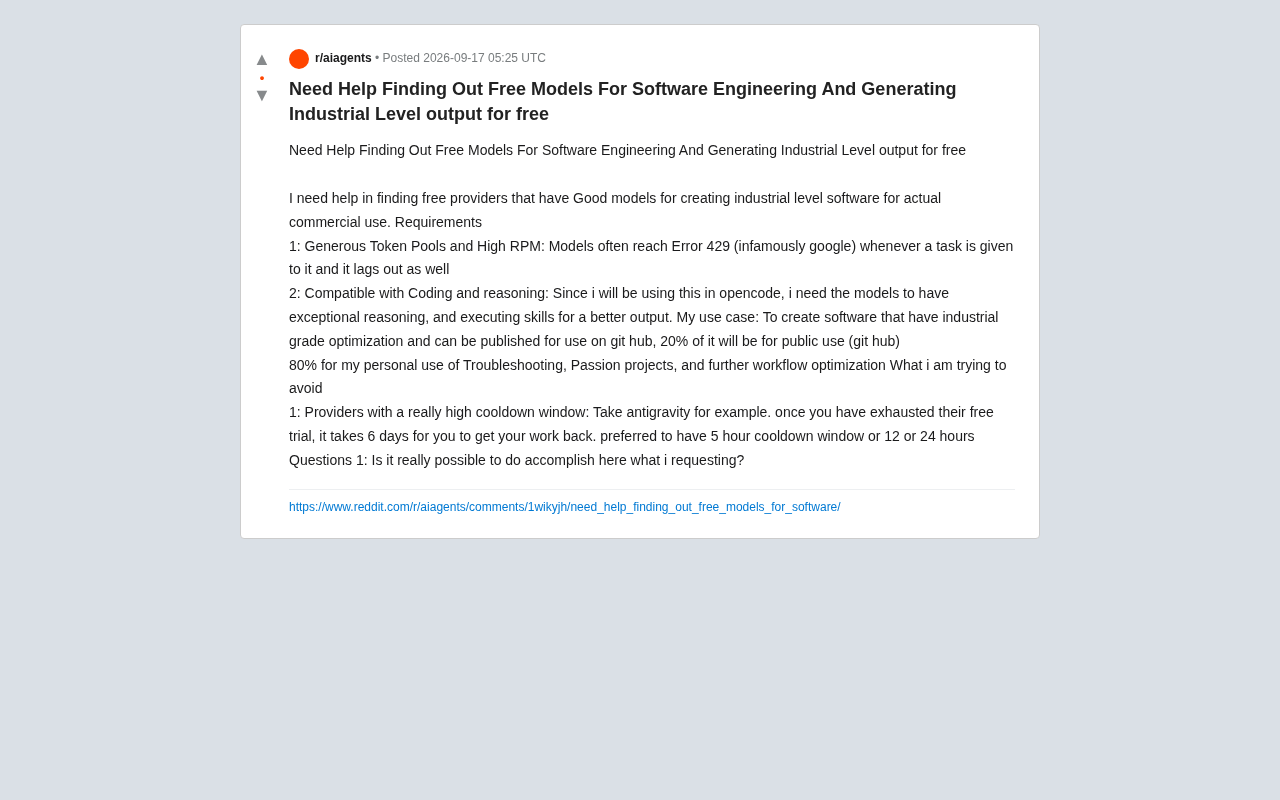
在 Reddit 的开发者社区里,一位用户抛出了不少人都关心的问题:能不能只靠免费的 AI 模型,写出可以真正投入商用、发布到 GitHub 的工业级软件?
他的需求相当具体:模型要有充足的 Token 额度和较高的每分钟请求数(RPM),能在 opencode 这类工具中稳定运行,同时具备出色的推理与代码执行能力。用途方面,大约 20% 的产出会开源到 GitHub 供公众使用,其余 80% 用于个人的排障、兴趣项目和工作流优化。
这个问题看似简单,背后却牵涉到当前免费 AI 编程工具生态的诸多现实约束。
免费额度的三大痛点
原帖作者列出的困扰,几乎是所有依赖免费 AI 编程服务的人都会遇到的。
频繁的 429 错误
他特别点名了 Google 的模型,指出在派发任务时经常触发 Error 429(请求过多),甚至出现卡顿。这是免费或低配额服务的典型症状——当请求速率或总量超过限制,服务端会直接拒绝响应。对于需要连续多轮交互的编程任务来说,这种中断极大地影响开发节奏。
HTTP 429 状态码(Too Many Requests)是服务端实施速率限制(Rate Limiting)的标准响应机制。AI API 提供商通常从两个维度设定限制:RPM(每分钟请求次数)和 TPM(每分钟处理的 Token 总量)。免费层的 RPM 普遍在 10-60 之间,而付费层往往可以达到数百甚至数千。对于 opencode 这类 AI 编程工具,每完成一次代码生成或多轮对话,都可能连续触发多个 API 请求,因此在免费层下极易触碰 RPM 上限。部分提供商还设有日度配额(RPD),即便每分钟请求量不高,当天总量耗尽后同样会返回 429,直到次日重置。
推理与执行能力的门槛
作者强调需要模型具备卓越的推理和执行能力,因为工业级优化的代码对逻辑严谨性要求很高。这实际上暴露了一个矛盾:能力最强的模型往往也是最贵的,免费层通常只开放较弱的版本或严格限流。
冷却窗口过长
他以 Antigravity 为例,抱怨一旦用完免费试用,需要等待长达 6 天才能恢复使用。他理想中的冷却窗口是 5 小时、12 小时或 24 小时。对持续开发者而言,动辄以天计的等待几乎等同于不可用。
现实答案:可能,但需要组合策略
从当前生态看,完全依赖单一免费服务实现"工业级、可商用、无中断"的目标并不现实,但通过合理组合仍有较大操作空间。
多提供商轮换
与其押注单一服务,不如同时注册多个提供商,在触发限流时切换。常见的免费或慷慨额度来源包括 OpenRouter(聚合多家模型并有免费层)、Groq(以高速推理著称)、以及部分模型的官方免费 API 层。轮换使用可以有效规避单点的 429 错误和冷却限制。
OpenRouter 是一个 API 聚合平台,通过统一接口接入数十家模型提供商,开发者只需一个 API Key 即可按需切换模型。其免费层包含部分开源模型(如 Mistral、Llama 系列)的有限额度,适合轮换时的备用节点。Groq 则以自研的 LPU(Language Processing Unit)硬件著称,推理速度远超传统 GPU 方案,免费层提供较高的 RPM 配额,尤其适合对延迟敏感的实时编程辅助场景。值得注意的是,这类聚合或高速服务的免费政策随商业策略调整较为频繁,建议定期核查最新限额。
开源本地模型
如果硬件条件允许,运行本地开源模型(如 Qwen Coder、DeepSeek Coder 等系列)是彻底绕开限流和冷却窗口的方案。本地部署没有 RPM 限制,也不存在冷却期,唯一成本是硬件与电力。对于 80% 的个人用途,这往往是最稳定的选择。
Qwen Coder 是阿里云推出的代码专项模型系列,Qwen2.5-Coder 在多项代码基准测试中表现接近闭源商业模型;DeepSeek Coder 系列同样以代码能力为核心设计目标,两者均提供从 1.5B 到 33B 不等的参数规模,可根据本地 GPU 显存灵活选择。在本地运行框架方面,Ollama 和 llama.cpp 是目前主流选择,前者提供类似 Docker 的模型管理体验,后者则针对 CPU 推理做了深度优化,即便没有独立显卡也可运行较小参数量的模型。本地部署的核心优势除无限流外,还包括数据隐私——商业代码无需经过第三方服务器。
区分场景使用
作者自己已经做了 20/80 的用途划分,这其实是关键思路。真正需要"工业级"品质、面向公众发布的那 20%,值得投入更强的模型(哪怕偶尔付费或精打细算地使用免费高配额);而占大头的排障和兴趣项目,用能力中等但稳定的免费或本地模型完全够用。
免费方案的隐性代价
需要清醒认识到,"免费"从来不是没有成本。免费层的代价通常体现在时间成本(等待冷却、处理限流)、稳定性成本(服务随时可能调整政策)以及能力上限(顶级模型很少长期免费开放)。
对于真正商用的软件,代码质量、安全性和可维护性直接关系到产品声誉。当项目发展到一定规模,为核心部分投入少量预算换取稳定的高质量输出,往往比在免费额度间反复挣扎更划算。
给同类需求者的建议
综合来看,原帖作者的目标是可以部分达成的:
- 短期内通过多提供商轮换 + 免费高速服务(如 Groq、OpenRouter 免费层)应对日常开发;
- 中期考虑本地部署开源代码模型,彻底摆脱限流困扰;
- 对面向公众的核心项目,保留少量付费预算或谨慎使用最强免费额度,确保产出质量。
完全零成本地持续产出商用级软件是理想化的,但通过分层策略与工具组合,绝大多数个人开发者的实际需求是可以被满足的。
相关推荐
Jev Ultrafast:动态索引动作空间的浏览器智能体
Jev Ultrafast 是一款主打「动态索引动作空间」的浏览器智能体,通过索引化优化元素定位效率,实现超快浏览器自动化。本文解析其设计理念与技术价值。
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
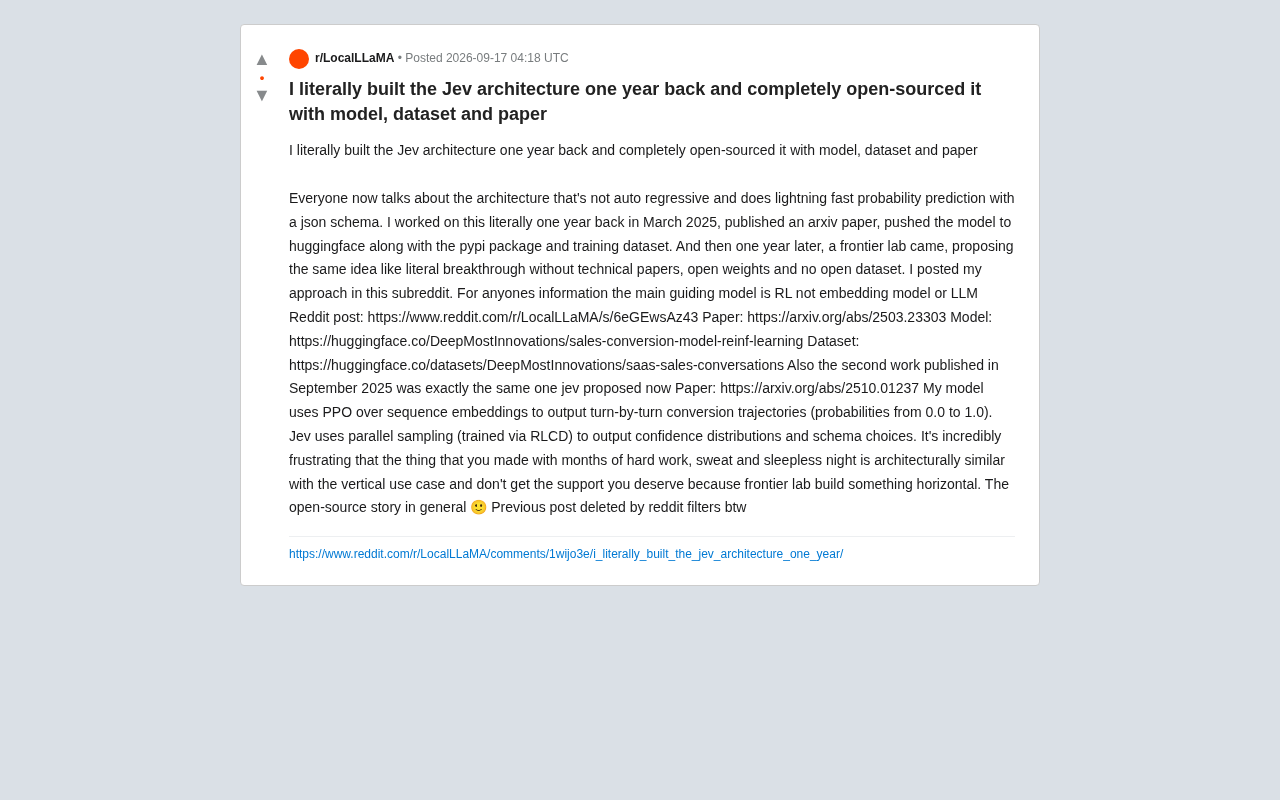
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。