免费本地部署的开源大模型实测:消费级显卡也能跑
125B参数开源大模型经IQ3量化后可在消费级显卡本地免费运行,兼顾隐私与低成本。
一个开源项目凭借"本地部署、永久免费"的核心卖点在社区迅速走红,上线一周Star数破5000。其核心技术路径是将125B参数的大型模型通过IQ3量化方案压缩,使其能在12G显存显卡配合32G内存的消费级硬件上运行。实测中,该模型支持100万Token超长上下文,能在约一小时的对话中生成可用的桌面音乐软件;通过加装几百兆的轻量视觉编码器还可扩展图像识别能力。文章同时提示:量化带来客观的精度损失,本地推理速度较云端服务慢,宣称"媲美顶级云端模型"的表述缺乏标准基准验证,用户需理性预期。整体而言,这类项目代表了开源生态通过激进量化持续降低硬件门槛、让大参数模型走向普通用户的重要趋势。
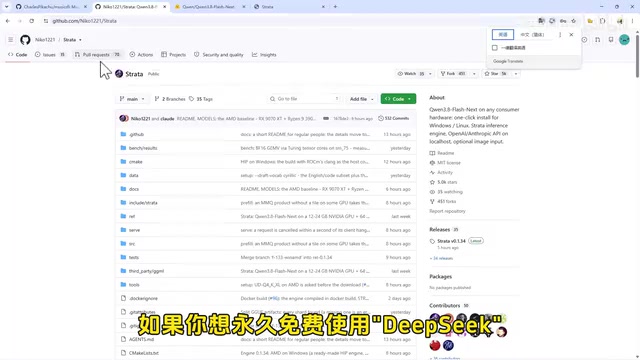
最近一个开源仓库在社区里引发不小的关注——据B站UP主的分享,这个项目上线短短一周 Star 数就突破 5000,其核心卖点是:帮助普通用户在本地免费部署一款高性能大模型,无需依赖云端服务,也不用付费订阅。对于长期受限于 API 调用费用或隐私顾虑的用户来说,这无疑是个值得研究的方向。
需要说明的是,原始素材中提到的模型名称(如"千万3.8 FlashNext")和对标版本("DeepSeek广告 V4.1")存在明显的语音转写误差,本文将聚焦于其技术路径与实际体验,不对具体型号命名做过度解读。
核心定位:本地化与免费化
这类项目的吸引力,本质上来自两个关键词——本地部署和永久免费。与调用云端 API 不同,本地部署意味着模型完全运行在自己的机器上,数据不出本地,隐私性更强,同时也彻底摆脱了按 Token 计费的成本压力。
据UP主介绍,该模型参数量高达 125B(1250 亿参数),被形容为"像一个知识渊博的大学教授"。这个量级在开源模型中已属大型,通常需要专业显卡才能运行。但该项目的亮点在于通过量化技术(素材中提到的 IQ3 系列量化方案),让如此庞大的模型得以在消费级硬件上流畅跑起来。
硬件门槛与运行体验
从素材给出的配置要求看,运行门槛被压得相当低:一张 12G 显存的显卡,加上 32G 以上的 CPU 内存,就能驱动起经过 IQ3 量化的版本。这意味着不少中高端游戏显卡用户都有机会尝试,而不必专门购置数万元的专业计算卡。
量化是这里的关键技术。简单说,量化就是用更低的数值精度(如 3-bit)来存储模型权重,从而大幅压缩显存占用,代价是轻微的精度损失。IQ3 这类方案正是在"能跑"和"够用"之间找平衡的产物。
实际部署后的界面被描述为"跟平时用豆包聊天差不多",支持深度思考模式,并且可以手动调节思考强度。模型宣称最多支持 100 万 Token 上下文,这个长度足以处理长文档、大型代码库等复杂任务。
量化技术的演进背景有助于理解 IQ3 方案的意义。早期量化主要采用 INT8(8-bit 整数)或 FP16(16-bit 浮点),显存压缩幅度有限。近年来,GGUF 格式配合 llama.cpp 框架推动了更激进的低比特量化实践,将权重精度压缩至 4-bit、3-bit 乃至 2-bit。IQ3 属于"重要性感知量化"(Importance-aware Quantization)系列,其核心思路是对模型中不同权重层按重要性分配不同的量化精度——关键层保留更高精度,次要层压缩更激进,从而在整体 3-bit 的显存占用下尽可能保住模型性能。相比朴素的统一 3-bit 量化,IQ3 系列通常能以相近的显存代价换来明显更好的输出质量,这也是 125B 量级模型能在消费级硬件上"够用"的关键所在。
实测案例:从对话到生成桌面软件
真正能检验模型能力的还是实际任务。UP主做了一个颇有代表性的测试:给模型一个 GitHub 地址,要求它生成一个桌面音乐软件。
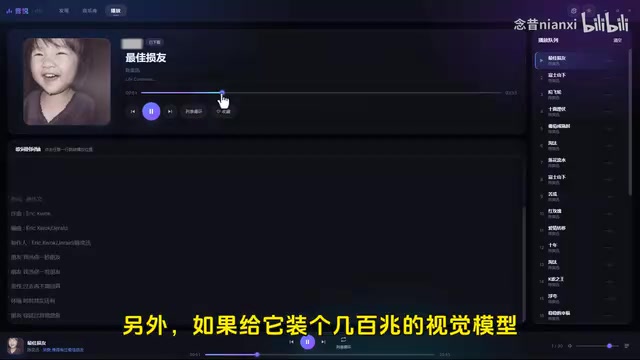
经过约一小时的来回对话,模型最终产出了第一版成品——这个软件能够搜索明星、下载对应歌曲。虽然只是初版,但UP主评价"第一版能有这水平很不错了"。
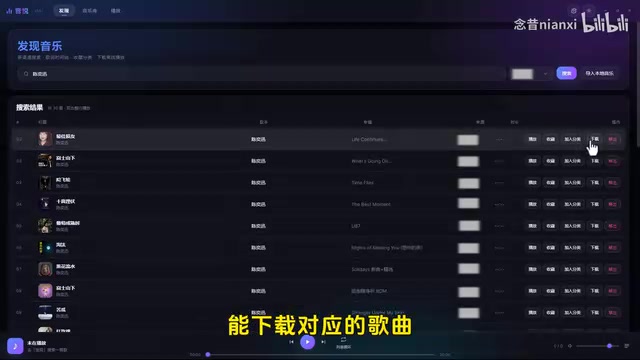
这类编程任务对模型的推理能力、长上下文记忆和代码生成准确度都是综合考验。能在本地运行的量化模型上完成一个可用的应用雏形,说明其代码能力并未因量化而严重退化。当然,一小时的对话时长也提示我们:本地推理速度相比云端大厂服务仍有差距,需要耐心。
多模态扩展:加装视觉模型识图
除了文本和代码,该模型还支持通过加装一个几百兆的视觉模型来获得图片识别与分析能力。
素材中演示了一个场景:给模型一张关于"大模型发布周期随时间推移越来越短"的时序图,模型很快就返回了对图表内容的分析结果。这种模块化的多模态扩展方式值得关注——用户可以按需叠加能力,而不必一次性加载臃肿的全功能模型,这对显存有限的本地环境尤为友好。
这种"文本主模型 + 轻量视觉编码器"的组合架构,在技术上通常被称为 LLaVA 式多模态方案。其原理是用一个独立的视觉编码器(如 CLIP 系列)将图像转化为向量嵌入,再通过一个投影层拼接到语言模型的输入序列中,让大模型"看到"图像内容。视觉编码器本身参数量极小(通常几百 MB),无需重新训练主模型,只需加载额外权重即可激活图像理解能力。这种解耦设计的优势在于灵活性——用户可以单独更新视觉模块,也可以在显存吃紧时选择不加载。对于本地部署场景而言,按需叠加能力而非一次性加载全功能模型,是在有限硬件资源下最大化实用性的务实选择。
理性看待:机会与注意事项
把这类项目放到更大的背景下看,它反映了开源大模型生态的两个明显趋势:一是通过激进量化不断降低硬件门槛,让大参数模型走向普通用户;二是模块化、可组合的部署方式日益成熟。
不过也需要保持理性。素材中"媲美 DeepSeek"等表述来自UP主的主观体验,缺乏标准化基准测试佐证;3-bit 量化虽然能跑,但精度损失客观存在,在高精度推理任务上可能不如原始模型稳定。本地推理的速度、长时间任务的耐心成本,也都是尝鲜前需要有心理预期的地方。
对于看重数据隐私、希望摆脱 API 费用、或者单纯想折腾本地 AI 的用户来说,这类开源项目确实提供了一条低成本的入门路径。感兴趣的话,建议先确认自己的显卡显存和内存是否达标,再去对应的开源仓库查阅具体的部署文档。
评估本地模型性能时,常用的标准化基准测试包括 MMLU(衡量多领域知识理解)、HumanEval(代码生成正确率)、GSM8K(数学推理)以及 GPQA(专业知识问答)等。量化模型通常会在这些基准上相较原始全精度版本出现 1-5 个百分点不等的下滑,具体幅度取决于量化方案和任务类型。对于日常对话和一般性代码生成,这种损失往往感知不明显;但在需要精确数值计算、严格逻辑推导或专业领域问答的场景下,精度损失的影响会被放大。因此,在没有可复现基准数据支撑的情况下,"媲美某云端旗舰模型"的主观评价只能作为参考,而非替代实际测试的依据。
结语
开源与本地化正在让大模型变得越来越"亲民"。无论最终这个具体项目能否长期维护,它所代表的方向——用量化技术把高性能模型塞进消费级硬件——都值得每一个关注 AI 的人持续留意。
相关推荐
永生经济学:当时间不再稀缺,价值将如何重构?
SFIA 深度探讨永生经济学:当时间不再稀缺,生物永生、数字意识上传、冷冻复活如何重写劳动、财富与价值规则?从专利强制许可到意识复制的劳动力崩塌,再到意义成为新稀缺品,一场关于永生社会的硬核思想实验。
Claude存储架构大变动:本地与云端的界限正在重划
Anthropic正在调整Claude的数据存储架构。10月6日起Pro/Max新会话将仅支持云端存储,Claude Code保留本地选项,企业版存储位置仍由管理员决定。本文梳理本地与云端的最新界限及对不同用户的影响。
共同主导AI安全训练营:法律与治理从业者的实践启示
一位AI安全训练营的共同主导者分享面向法律与治理从业者的培训经验,探讨跨学科教学的挑战、概念翻译的必要性,以及AI治理人才能力建设对行业的深远意义。