Mica v0.1 4B:不生成一个token,如何在真实Minecraft中造出铁镐
40亿参数模型通过零token生成的概率打分机制,在Minecraft中23步完成从零到铁镐的完整工序链。
Mica v0.1 4B是一个运行在真实Minecraft服务器中的游戏智能体,其核心创新在于用"概率打分"替代传统的"文本生成"来做决策——模型不输出任何token,而是直接读取候选命令对应token的概率值进行排序选择。基于llama.cpp的Q5_K_M量化,整套系统运行在单张RTX 3090上,每步决策仅需90-150毫秒,实现了近实时响应。项目作者演示了从空背包出发、历经砍木、合成、采矿、冶炼等23步完整工序链最终获得铁镐的全过程,并附带可视化面板实时展示每步的候选命令与概率分布。模型权重与代码已完全开源,为构建轻量、可靠的游戏智能体或工具调用系统提供了可复现的参考范式。
一个只有40亿参数的模型,在真实的Minecraft 1.20.4服务器里从空背包一路做到铁镐,全程没有生成过一个文本token。这个名为Mica v0.1 4B的项目在Reddit上引发讨论,因为它展示了一种与主流「让大模型输出动作文本」截然不同的智能体控制思路。
核心机制:把决策变成打分,而非生成
大多数游戏智能体的做法是让语言模型"说话"——输出下一步要执行的命令文本,再由解析器转换成游戏操作。Mica走的是另一条路。
它的每一步都遵循同一个循环:先把机器人的实时游戏状态(背包物品、附近方块、周围实体、上一步执行结果)转写成文本;然后Mica对一组候选命令进行评分,选出下一个动作;最后由Mindcraft的技能库(基于Mineflayer的机器人框架)在游戏中执行选中的命令。
关键在于评分环节。Mica从不生成文本,而是直接读取答案标签token的概率值,据此对候选命令排序并挑选最优项。换句话说,模型的输出token数是0——它不写字,只算概率。这种"分类式"而非"生成式"的决策方式,把一个开放式生成问题压缩成了一个受约束的选择问题。
直接读取token概率的技术背景值得展开。语言模型在推理时,对词汇表中每个token都会输出一个logit值,经softmax归一化后即为概率分布。Mica利用的正是这一层:给定当前状态描述作为prompt,模型被要求"选择下一个命令",但并不真正解码生成完整文本——而是直接提取预设候选命令对应token(即"答案标签")的概率值,以此排序。这类方法有时被称为"受限解码"或"分类式推理"(classification-style inference),在意图分类、选择题评测等场景中已有应用,但用于游戏智能体的实时动作选择仍属小众路径。其核心优势在于:候选动作集是封闭的,不存在模型输出格式错误或幻觉式命令;同时由于只需一次前向传播读取特定token的logit,而非自回归逐步生成,推理开销大幅降低。
23步造出铁镐的完整链路
项目作者给出了一段完整的运行记录:从空背包出发,Mica用23次决策完成了从零到铁镐的全部工序。
这条链路完整覆盖了Minecraft早期发展的标准路径:砍原木、合成木板、制作工作台、做出木镐、挖石头、升级石镐、造熔炉、采铁矿、冶炼、最终打造铁镐。对熟悉游戏的人来说,这是一套需要正确排序、且每一步都依赖前一步产出的工序链——任何一步选错都可能让整个流程卡住。
模型能在23步内稳定跑通,说明它在状态理解和工序规划上具备实用级别的可靠性,而非偶然成功。
性能表现:单卡实时决策
运行环境的数据同样值得关注。Mica基于llama.cpp运行,采用Q5_K_M量化,硬件为一张RTX 3090。
在这套配置下,每次决策耗时约90到150毫秒。这个延迟意味着智能体可以近乎实时地响应游戏状态变化,而不需要动辄数秒的推理等待。对于需要连续决策的实时游戏环境,这样的响应速度是能否实际可用的分水岭。
值得强调的是,40亿参数加上量化后,整套系统在消费级显卡上就能跑起来,而不是依赖大规模集群。这降低了复现和二次开发的门槛。
Q5_K_M是GGUF格式下的一种混合量化方案,由llama.cpp项目引入。它对不同层的权重采用不同精度(部分用5-bit、部分用更低精度),在压缩显存占用的同时尽量保留模型精度,通常被认为是质量与体积的较优折中点。以4B参数模型为例,FP16全精度约需8GB显存,而Q5_K_M可将其压缩至约3GB左右,使其能轻松容纳在消费级显卡中。llama.cpp本身是一个纯C/C++推理框架,针对CPU和GPU混合推理做了大量优化,也是目前本地部署开源模型最主流的工具链之一。两者结合使得Mica的整套系统无需依赖CUDA大规模并行集群,普通游戏PC即可运行。
可视化:每一步决策都透明可查
作者附带的演示视频在呈现上做了不少工作。右侧面板会实时展示每一次决策的全过程:候选命令有哪些、Mica给出的概率分布、最终选择、以及执行结果。每一步同时被记录在历史信息流中。
视频对长动作(如行走、挖矿、冶炼)做了加速处理并在画面上标注倍速,连续重试的片段也在剪辑中被压缩。HUD界面与合成台、熔炉的画面则是根据机器人记录的背包状态绘制的。
这种透明化的展示方式,让观察者能够直观理解模型"为什么这么选",而不是只看到一个黑箱输出结果,对于评估智能体决策质量很有帮助。
意义与开放资源
Mica的思路提供了一个有价值的参考:对于动作空间相对有限、可以枚举候选项的任务,用概率打分替代文本生成,既能降低推理开销,又能避免生成式输出的格式错误与幻觉问题。这对构建轻量、可靠的游戏智能体或工具调用系统都有借鉴意义。
作为v0.1版本,它仍处于早期阶段,23步的单次演示还不足以证明模型在更复杂、更长周期任务上的鲁棒性。但作者已开放了模型权重与完整代码:
- 模型权重:Hugging Face上的 sky7350/Mica-v0.1-4B
- 代码与服务器:GitHub上的 akivet/Mica-v0.1-4B
开源意味着社区可以直接验证这套"零token生成"的决策范式在其他任务上的可迁移性,这或许比一次成功的Minecraft演示本身更有价值。
Mineflayer是一个基于Node.js的Minecraft机器人开发框架,提供对游戏协议的底层封装,支持移动、挖掘、合成、交互等操作的API调用。Mindcraft则在Mineflayer之上构建了更高层的"技能库"(skill library),将常见游戏任务(如"砍树""合成木板""前往坐标")封装成可直接调用的函数。Mica选择的候选命令实际上就是这些预定义技能,而非底层原子操作。这种分层架构意味着Mica的决策层只需在有限的高层技能集上做选择,大幅降低了动作空间复杂度,也是其能以零token生成完成长工序链的前提之一。理解这一点有助于判断该方法的适用边界:动作空间越封闭、越结构化,打分替代生成的优势越明显;反之,若任务需要开放式规划或生成新技能,则此范式的局限性会显现。
相关推荐
Ling Tiny 3.0:8B小模型让2017年老笔记本跑出智能
阿里 Ling 3.0 Tiny 是一个 8B 参数、仅 1B 激活的 MoE 模型。一位 Reddit 用户在 2017 年老笔记本上用纯 CPU 跑出 10 tokens/秒,完成多轮编程任务,展示了边缘智能的全新可能。
Meta Connect大会聚焦智能眼镜:可穿戴设备成新战场
在Meta Connect大会上,智能眼镜成为绝对主角。本文解析Meta为何押注智能眼镜、其产品线扩张背后的战略意图,以及智能眼镜与AI结合面临的机遇与挑战。
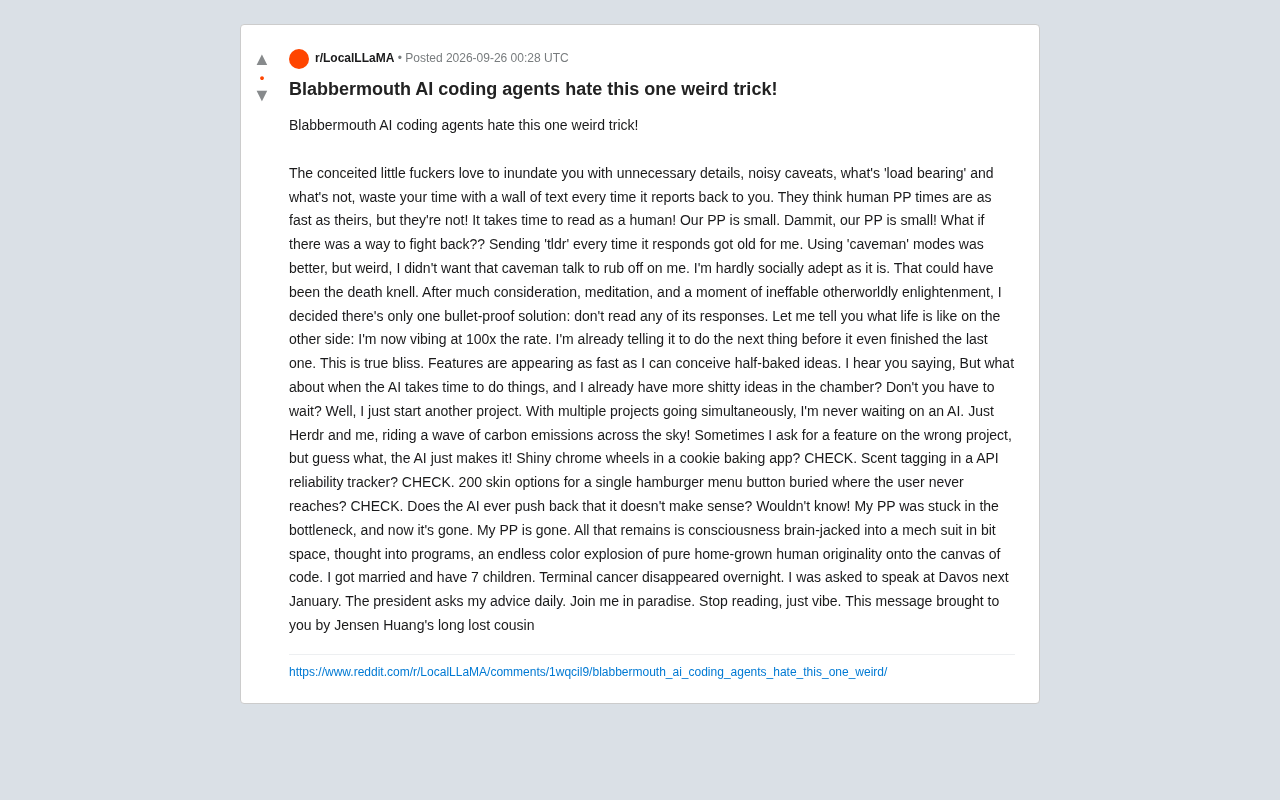
"别读AI的回复"?一篇讽刺帖背后的Vibe Coding隐忧
一篇Reddit爆款讽刺帖调侃AI编程助手太话痨,作者用"干脆不读回复"的荒诞方案暗讽vibe coding隐忧。本文解读段子背后关于信息过载、盲目信任AI输出与人工审查的真实问题。