Ling Tiny 3.0:8B小模型让2017年老笔记本跑出智能
8B参数MoE模型Ling 3.0 Tiny在2017年老笔记本上纯CPU跑出10 tokens/秒,完成编程闭环任务,揭示边缘智能新路径。
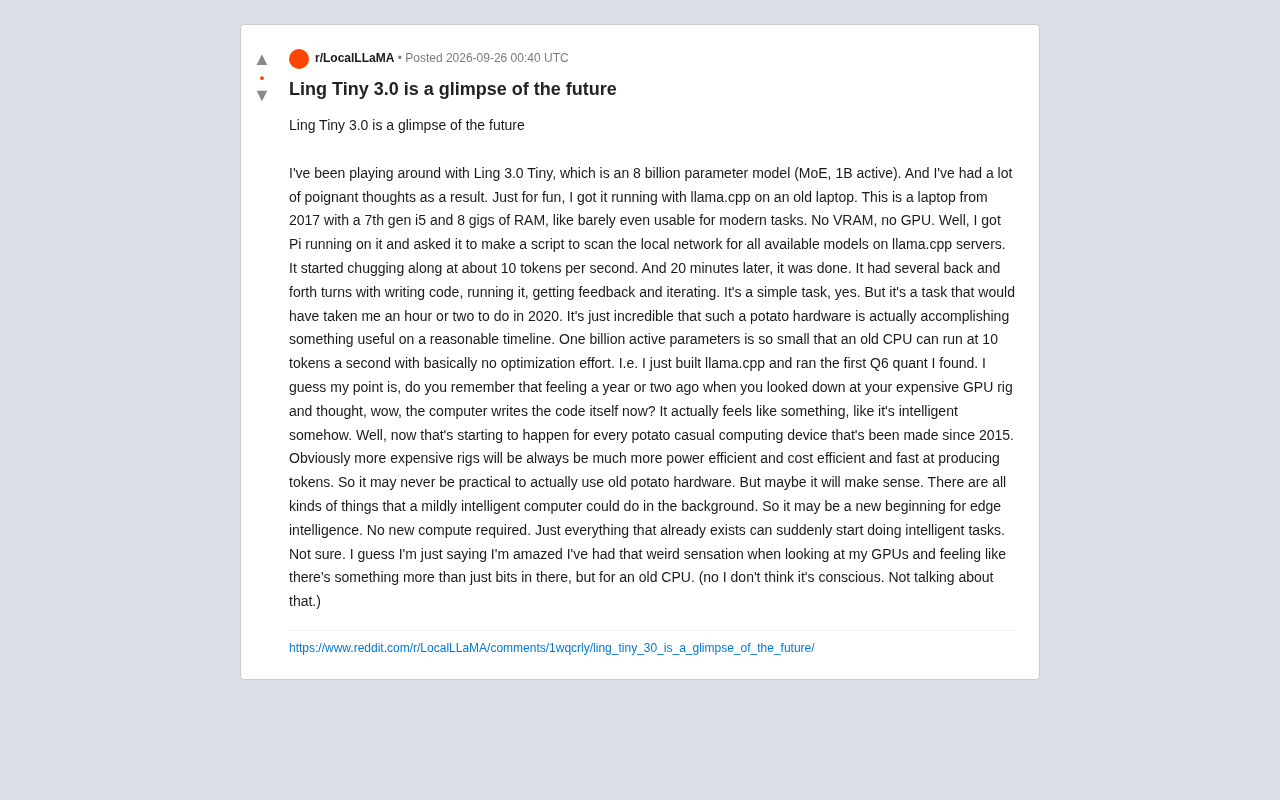
一位Reddit用户用一台2017年的低配笔记本(7代i5、8GB内存、无GPU),借助llama.cpp运行阿里的Ling 3.0 Tiny模型,成功以约10 tokens/秒的速度完成了一个多轮编程闭环任务。这一结果的技术前提在于MoE架构:模型总参数8B,但每次推理仅激活1B,实际算力需求大幅压缩。配合Q6量化,模型得以完整加载进8GB内存并稳定运行。这一实验的意义不在于证明旧硬件比新硬件更好,而在于揭示了一条不依赖算力堆砌的AI普及路径——海量已存在的旧设备,无需任何硬件升级,便可能具备处理低频智能任务的能力,边缘智能的硬件门槛正被小参数高效模型彻底改写。
一台旧笔记本,重新定义了边缘智能
一位 Reddit 用户在把玩阿里推出的 Ling 3.0 Tiny 模型时,得出了一个颇具启发性的结论:真正的 AI 平民化,可能不是靠更强的显卡,而是靠更小、更聪明的模型。
Ling 3.0 Tiny 是一个 80 亿参数(8B)的 MoE(混合专家)模型,激活参数仅 10 亿(1B active)。这位用户没有用昂贵的 GPU 集群,而是把它塞进了一台 2017 年的老笔记本——搭载第 7 代 i5 处理器、8GB 内存,没有独立显卡,没有显存。这种配置在今天连流畅处理现代日常任务都勉强。
结果却出人意料。他用 llama.cpp 直接编译运行了随手找到的一个 Q6 量化版本,没有做任何针对性优化,模型就以约 10 tokens/秒 的速度稳定跑了起来。
让老CPU完成真实编程任务
这位用户给模型分配了一个实际任务:编写一个脚本,扫描局域网中所有运行 llama.cpp 服务的可用模型。
整个过程持续约 20 分钟。模型经历了多轮交互——写代码、运行、获取反馈、再迭代修正。虽然任务本身并不复杂,但它是一个需要闭环推理与自我纠错的完整工作流,而非简单的一问一答。
用他自己的话说:"这是一个在 2020 年可能要花我一两个小时才能完成的任务。"如今,一台连现代浏览器都跑得吃力的老机器,靠纯 CPU 就在合理时间内独立完成了。
关键点在于激活参数只有 10 亿。MoE 架构让模型总参数量达到 8B 以保证能力上限,但每次推理只激活其中一小部分,因此对内存和算力的实时要求大幅降低。这正是老 CPU 也能跑到 10 tokens/秒的技术前提。
MoE(Mixture of Experts,混合专家)架构是理解这一性能表现的关键。传统密集模型(Dense Model)在每次推理时会激活全部参数,而 MoE 模型则将网络拆分为多个"专家"子网络,每次前向传播时由一个轻量级的"路由器"(Router)动态选择其中少数几个专家处理当前输入。以 Ling 3.0 Tiny 为例,8B 总参数分布在多个专家模块中,但每次推理仅激活约 1B 参数,这意味着实际运算量与一个 1B 的密集模型相当,而模型的整体知识容量和任务上限则接近 8B 级别。这种设计带来两个直接好处:一是内存带宽压力大幅下降,老旧 CPU 的缓存和内存总线不会成为明显瓶颈;二是浮点运算量(FLOPs)显著减少,使得没有向量加速单元的普通处理器也能维持可用的推理速度。
从"显卡里有智能"到"每台旧设备都有智能"
这篇帖子最打动人的,是它描述的那种"感觉"。
作者回忆起一两年前第一次看着自己昂贵的 GPU 主机、意识到"计算机自己会写代码了"时那种近乎敬畏的震撼——仿佛那堆比特里真的藏着某种智能(他特别强调,并不是在谈论意识)。
而现在,这种体验正在下沉到 2015 年以来生产的每一台"土豆"级设备上。这意味着不再需要新的硬件投入,海量早已存在的旧电脑、旧笔记本,都有可能突然具备执行智能任务的能力。
Q6 量化(6-bit Quantization)是让模型得以塞进 8GB 内存的另一项关键技术。量化的核心思路是将模型权重从训练时使用的 32 位或 16 位浮点数压缩为更低精度的整数或定点数表示。Q6 意味着每个权重用 6 位存储,相比 FP16 节省约 62% 的内存占用,模型精度损失通常在可接受范围内。对于一个激活参数仅 1B 的 MoE 模型而言,Q6 量化后的实际加载体积可以控制在数 GB 以内,恰好能被 8GB 系统内存容纳并留有运行余量。llama.cpp 作为专为 CPU 推理优化的开源框架,原生支持多种量化格式,并针对 x86 指令集的 AVX/AVX2 扩展做了底层优化,是目前在消费级硬件上运行本地大模型最主流的工具之一。
边缘智能的新起点,还是理论上的可能?
作者对实用性保持了清醒。他坦承:更贵的硬件在能效比、成本效率和 token 生成速度上永远占据优势,因此在实践中未必真的会有人去用老旧硬件跑推理。
但换个角度看,很多任务并不需要极致性能。一台"略有智能"的计算机完全可以在后台默默处理各种琐碎工作——本地网络管理、文件整理、简单的自动化脚本编写等等。对这类低频、非实时的任务而言,能跑就够了,速度反而是次要的。
这或许正是边缘智能(Edge Intelligence)的一个新起点:不需要任何新增算力,让所有已经存在的设备自然获得处理智能任务的能力。
小模型路线的信号意义
抛开这台老笔记本的浪漫故事,Ling 3.0 Tiny 本身反映了当前一个重要的技术趋势——小参数 MoE 模型正在快速逼近实用门槛。
过去两年,行业注意力集中在动辄千亿参数的旗舰模型上。但真正决定 AI 能否渗透进日常设备的,是这类激活参数极低、却仍具备多轮推理和代码生成能力的高效模型。当 1B 激活参数就能完成有意义的编程闭环,AI 部署的硬件门槛便被彻底改写。
需要说明的是,本文基于单一 Reddit 用户的实测分享,属于个人体验层面的观察,具体性能表现会因量化版本、任务类型和硬件差异而有所不同。但它传递的方向性判断值得关注:智能的普及,也许不靠堆料,而靠"变小变巧"。
相关推荐
GPT-6 Sol与Luna实测:建模、游戏、写作全面对比
B站UP主实测GPT-6 Sol与Luna Max在3D建模、小游戏、写作三大场景的表现,并与Opus 5.5横向对比。Sol降价带来Codex额度利好,但创意生成能力仍不及Opus 5.5,Luna小模型也有清明上河图贴图惊喜。
GPT-6 Soar对比GPT-5.6 Soar实测:更快更省的真实差距
GPT-6 Soar与GPT-5.6 Soar实测对比:从SVG绘图、代码理解到3D场景生成,记录耗时、额度消耗与完成质量。简单任务难分高下,复杂任务中GPT-6 Soar在速度、成本和方位准确性上明显占优。
GPT-6 Luna实测:性价比最高的干活模型
GPT-6 Luna实测评测:价格比GPT-5.6 Luna再降50%以上,5亿Token只扣3%额度。本文分享Luna的实际干活能力、Skill调用短板、执行者定位以及上下文窗口配置技巧,帮你找到性价比最高的AI模型使用方式。