Milvus 2.6 实战:高性能 RAG 从向量原理到企业问答
梳理 Milvus 2.6 的向量原理、云原生架构与高性能 RAG 项目落地路径。
本文基于李锦老师的课程内容,系统梳理 Milvus 2.6 这一开源向量数据库的定位、原理与实战路径。文章首先将 Milvus 在 AI 技术栈中的角色类比为 Java 开发中的 MySQL,强调其开源免费、深度可控的优势,并说明其与 Zilliz Cloud 的关系类似 Linux 与红帽。随后从相似度计算与 ANN 检索切入,解释向量数据库相较传统关系型数据库的能力边界。架构部分介绍了 Stream、Query、Data 节点与 Coordinator 协调器,以及 etcd、消息队列、对象存储的组件组合,并给出 Python 轻量版与单机部署的硬件建议。RAG 实战聚焦分层存储、驱逐策略、预热机制与水位线管理等调优点,最后结合就业市场趋势指出向量数据库是进入 AI 大模型领域的基石。
向量数据库正在成为 AI 应用的基础设施,而 Milvus 作为全球最受欢迎的开源向量数据库,其 2.6 版本带来了架构与性能的显著升级。本文基于李锦老师的课程内容,梳理从向量原理到高性能 RAG 项目落地的关键路径,帮助开发者建立系统性认知。
为什么选择 Milvus 2.6:开源向量数据库的定位
在 AI 大模型技术栈中,向量数据库的角色类似于传统 Java 开发中的 MySQL——它负责存储和检索高维向量,是 RAG 系统的核心组件。Milvus 官方定位为全球最火爆的开源向量数据库,其 GitHub 热度居高不下,社区活跃度在同类产品中处于领先位置。
选择 Milvus 的核心理由在于开源免费与深度可控。相比商业收费方案,开源版本允许开发者深入理解底层原理,避免高昂的授权费用。同时,Milvus 提供了从单机到云原生的多种部署形态,适应不同规模场景。
值得一提的是,Milvus 与 Zilliz Cloud 的关系类似 Linux 与红帽/CentOS:Milvus 是开源内核,Zilliz Cloud 是基于 Milvus 的商业云服务,提供免运维、性能更优的企业级体验。对于个人学习与开源项目,直接使用 Milvus 即可;企业级生产环境则可考虑 Zilliz Cloud 的托管服务。
向量检索的本质:相似度计算与高维空间搜索
向量数据库的“绝活”是相似度计算。传统关系型数据库擅长精确匹配(如 WHERE id = 1)或模糊查询(如 LIKE '%keyword%'),但面对“从几十亿张图片中毫秒级找到目标”的需求时,传统方案无能为力。向量数据库通过将数据转化为高维向量,利用近似最近邻(ANN)算法在向量空间中快速检索相似项。
理解向量化、余弦相似度、Embedding 等概念是构建 RAG 系统的基础。在 RAG 流程中,文档被 Embedding 模型编码为向量存入 Milvus,用户提问时同样编码为向量,通过相似度检索找到最相关的文档片段,再交给大模型生成答案。
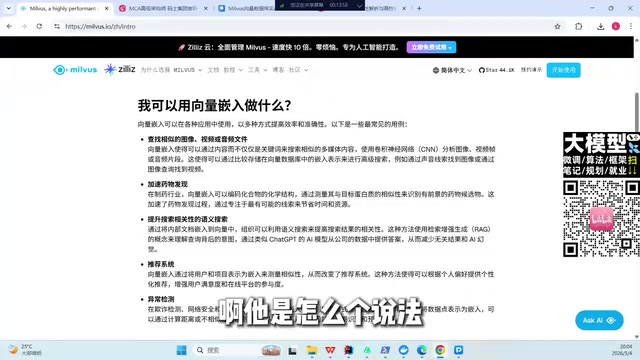
ANN(近似最近邻)算法是向量检索性能的关键所在。精确最近邻搜索需要逐一计算查询向量与库中所有向量的距离,复杂度为 O(N),在十亿级数据下无法满足毫秒级响应。ANN 通过构建索引结构(如 HNSW 图索引、IVF 倒排索引、PQ 乘积量化等)以少量召回率损失换取数量级的速度提升。
余弦相似度衡量两个向量在方向上的接近程度,取值 -1 到 1,值越大越相似,常用于文本 Embedding 检索;与之并列的还有欧氏距离(L2)和内积(IP),Milvus 在创建索引时需明确指定度量类型,且必须与所用 Embedding 模型的训练方式匹配。
Embedding 指通过深度学习模型将文本、图像等非结构化数据映射为固定维度的稠密向量,使语义相近的内容在向量空间中距离更近,这是向量数据库能够“理解语义”的前提。
Milvus 2.6 架构解析:云原生与分层设计
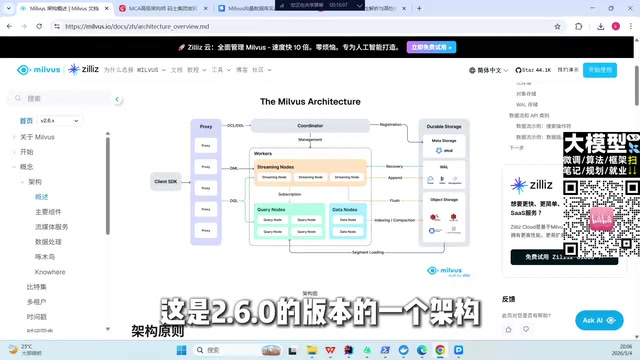
Milvus 2.6 采用云原生架构,完全基于 Kubernetes 生态设计。从官方架构图可以看到,系统包含多个核心组件:Stream 流式节点、Query 查询节点、Data 数据节点,以及 Coordinator 协调器。协调器根据操作类型将请求路由到不同节点,实现负载分离。
存储层支持 etcd(Kubernetes 常用元数据存储)、消息中间件(如 Kafka、Pulsar 或 WarpStream 等新型消息队列),以及对象存储(Amazon S3、MinIO 或云存储)。这种设计使得 Milvus 能够从单机部署平滑扩展到大规模云部署。
对于初学者,最简单的上手方式是 Python 轻量版:通过 pip install pymilvus 安装客户端库,使用 Milvus Lite 在本地启动服务,再用客户端连接即可。单机部署则建议至少 8GB 内存、英特尔第二代酷睿或更高 CPU,并强烈推荐使用固态硬盘——非固态硬盘下 Milvus 性能会明显受限。
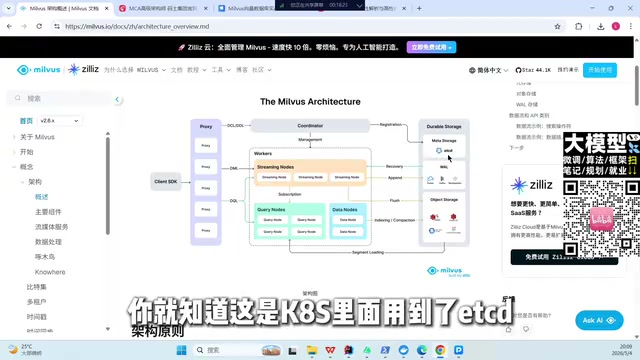
Milvus 的存算分离设计是其云原生能力的核心:Query 节点负责向量检索计算,Data 节点负责数据持久化与索引构建,二者通过消息队列解耦,因此可以独立扩缩容。etcd 承担集群元数据与协调服务(节点注册、健康检查、配置分发),消息中间件(Kafka/Pulsar/WarpStream)作为日志流保证数据写入的持久性与顺序性,对象存储(S3/MinIO)则存放段文件与索引文件。
这种组合正是“日志即数据”的架构范式:写入先落消息队列,再由 Data 节点消费并持久化到对象存储,Query 节点加载索引对外提供查询。Milvus Lite 则是将上述组件精简为单进程嵌入式实现,数据落本地文件,适合原型验证与学习,但不支持分布式特性。
RAG 项目实战:从理论到智能问答系统
课程中快速搭建了一个基于 Milvus 的 RAG 智能问答项目。实战环节重点不在于简单的安装入门,而是解决项目中的“蓝点”问题:分层存储、驱逐策略、预热机制等。这些概念在面试和实际项目中频繁出现,是区分普通开发者与架构师的关键。
在 RAG 系统优化方面,需要关注水位线管理、预热子段、索引策略等调优点。Milvus 2.6 的分层存储允许将冷热数据分离,驱逐策略则控制内存中保留哪些数据,预热机制确保查询命中时数据已就绪。合理配置这些参数,能够显著提升检索性能与资源利用率。
分层存储(Tiered Storage) 指 Milvus 将数据按访问热度划分为内存、本地磁盘与对象存储多个层级,热数据常驻内存以保证查询延迟,冷数据下沉到廉价存储以控制成本。驱逐策略(Eviction Policy) 决定内存不足时哪些数据段被换出,可类比操作系统的页面置换算法,Milvus 支持基于访问频率与时间的策略配置。
预热(Warm-up) 指在查询到来前主动将指定集合或分区的索引加载进内存,避免首次查询时的冷启动延迟。水位线(Watermark) 在流式写入场景中标记数据消费的进度边界,用于保证查询可见性与数据一致性。这些机制共同决定了 RAG 系统在数据量增长后的延迟稳定性与资源开销。
2026 年 AI 大模型就业市场与技术趋势
李锦老师结合自身超过 13 年的 Java 开发与架构经验指出,当前 AI 大模型领域持续火热,但开发者需要抓住核心技能点:多智能体系统、RAG 优化、模型微调以及核心算法。对于 Java 开发者而言,向 AI 架构转型需要同时掌握 Java 架构能力和 AI 应用开发能力。
向量数据库作为 AI 基础设施,是进入大模型领域的基石。掌握 Milvus 的原理与实战,不仅能够应对面试中的深度问题,更能在企业级项目中落地高性能 RAG 系统。从向量原理到架构设计,再到项目调优,这条学习路径覆盖了未来一到两年 AI 架构技术的核心。
本文基于 B 站李锦老师的公开课程内容整理,结合 Milvus 官方文档信息,供开发者学习参考。
相关推荐

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。

黄仁勋若卸任,英伟达AI帝国将何去何从?
英伟达的AI霸权是否过度依赖黄仁勋个人?本文分析硅谷对CEO的个人崇拜现象,探讨英伟达技术护城河与组织风险,以及AI产业为何需要摆脱救世主叙事。

2026科技诉讼风向标:立法者欲收紧AI与平台责任
2026年科技诉讼成为焦点:美国参议院司法小组委员会听证会推动限制在线平台强制仲裁,并加强对深度伪造创作者的追责,科技平台与AI工具面临责任重构。