MiniMax H3开源部署教程:低显存本地生成AI视频

MiniMax H3开源:AI视频生成的成本革命
近期,开源视频生成领域迎来了一次重量级更新——MiniMax H3 正式全面开源。对于长期依赖线上平台按秒付费的创作者而言,这不仅是一次模型迭代,更是一场成本结构的彻底重构。
在MiniMax H3之前,开源视频生成领域已经经历了几轮重要迭代。2023年Stability AI发布的Stable Video Diffusion开启了开源视频生成的先河,随后AnimateDiff、CogVideo等模型相继涌现。但这些早期模型在画质、时长和一致性方面与闭源商业产品(如Runway Gen-3、Pika、Sora等)存在明显差距。2024年以来,随着DiT(Diffusion Transformer)架构在视频生成中的广泛应用,开源模型的质量开始大幅追赶闭源产品,MiniMax H3正是这一趋势中的重要里程碑。
过去,生成一条15秒的高质量AI视频,往往需要在云端平台反复"抽卡",一条视频动辄消耗几十甚至上百元。目前主流商业AI视频平台普遍采用积分/Credits制度——例如Runway按秒收费,生成一段5秒视频约需0.5-1美元;Kling和可灵等平台则按次收费或提供月度订阅。对于需要大量迭代的创作者来说,一段满意的视频可能需要反复生成10-30次才能得到理想结果,这就是所谓的"抽卡"成本。一个月下来,工具订阅费用可能比房租还高。
而MiniMax H3开源后,本地运行的边际成本几乎趋近于零——除了电费,生成10条、100条乃至1000条视频,都不再额外付费。以RTX 4090为例,满载功耗约450W,生成一段视频耗时几分钟,电费仅几分钱。
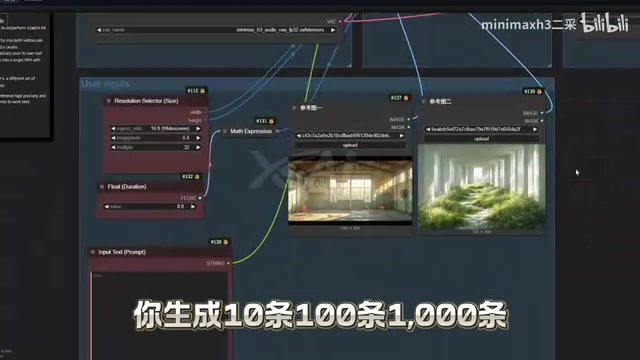
这种从"按秒计费"到"按电费计算"的转变,把高端AI视频生成的门槛从企业级预算拉低到了个人创作者可承受的范围。
MiniMax H3的四大核心优势
作为目前开源可商用视频模型中综合体验处于第一梯队的产品,MiniMax H3在几个关键维度上表现突出。
音视频同步生成,省去后期配音
传统AI视频工作流中,画面生成后往往还需要单独配音、添加音效和BGM,后期工作量巨大。这通常需要借助TTS(文字转语音)、音效生成或音乐生成等独立工具来完成,并且还面临音画对齐、Lip-sync(唇形同步)等技术难题。
而MiniMax H3采用了多模态联合生成架构,在训练阶段就将视觉帧与音频波形进行对齐学习,使模型能够理解画面内容与声音之间的语义关联。例如,当画面中出现流水场景时,模型能自动生成匹配的水流声;人物说话时能生成对应的口型与语音。这种端到端的多模态生成方式,在生成视频画面的同时直接输出与之匹配的音频音效,贴合度和质感都相当出色,大幅缩减后期制作时间。
文生视频、图生视频、参考生视频三大场景全覆盖
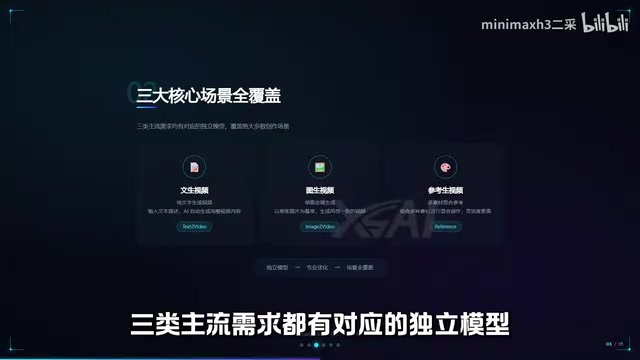
MiniMax H3提供了针对三类主流需求的独立模型:
- 文生视频(Text-to-Video):纯文字描述即可生成完整视频,完全依赖文本编码器将语言描述映射到视觉空间,对prompt工程要求较高
- 图生视频(Image-to-Video):单张图片定调后生成动态视频,以输入图像作为首帧或风格锚点,通过图像编码器提取视觉特征后进行时序扩展,生成结果的可控性更强
- 参考生视频(Reference-to-Video):多素材混合作为参考输入,模型从中提取风格、角色外观、动作模式等多维度信息进行融合创作
这三类需求几乎覆盖了绝大多数创作场景,无论是概念验证、素材动态化,还是基于已有素材的多素材混剪重组,都能找到对应方案。
画面一致性与动态表现力兼顾
画面一致性(Visual Consistency)是很多开源视频模型的痛点,也是视频生成领域的核心难题之一。由于视频本质是逐帧生成的序列,模型需要在每一帧之间维持人物外貌、服装细节、背景元素的连贯性。早期模型常出现"形象崩坏"——即人物在不同帧之间面部特征突变、肢体比例失调。技术上,解决这一问题通常依赖时序注意力机制(Temporal Attention)和跨帧特征传播(Cross-frame Feature Propagation)。
在图生视频任务中,MiniMax H3通过更深层的时序建模和身份保持模块,能完整保留原图中的人物形象与画风特征,不会出现中途"形象崩坏"的问题。同时,视频动态效果充足,包含完整的动作与镜头变化,而非仅有轻微抖动的"换灯片"效果。这种在保证动态丰富性的同时维持形象稳定性的能力,对叙事性内容创作尤为关键。
本地部署方案:ComfyUI整合包一键启动
对于许多用户来说,开源模型最大的门槛在于环境配置——装依赖、调参数,折腾半天还可能报错。针对这一痛点,社区提供了解压即用的ComfyUI整合包。
ComfyUI是一款基于节点式工作流的AI图像/视频生成界面工具,由开发者comfyanonymous于2023年初发布。与传统的WebUI不同,ComfyUI采用可视化节点图的方式组织生成流程,用户可以像搭积木一样将模型加载、条件输入、采样器、后处理等步骤自由连接。这种设计使其具有极高的灵活性和可扩展性,已成为AI创作社区中最受欢迎的本地部署前端之一。
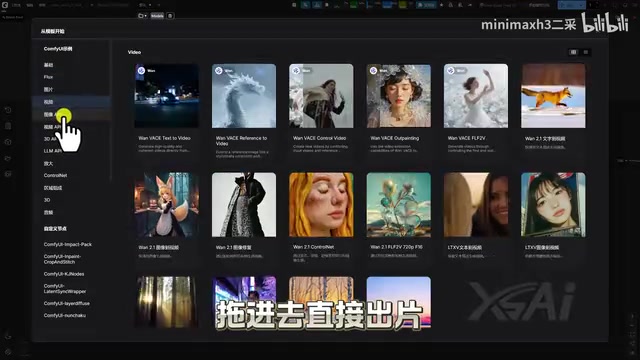
所谓"整合包",是社区将ComfyUI本体、Python环境、模型权重、自定义节点等打包在一起的一站式解决方案,用户解压后即可使用,无需手动安装任何依赖。这套整合包的核心特点包括:
- 双击启动,零代码零配置,非技术用户也能轻松上手
- 显卡兼容性广泛,支持30系(Ampere架构)、40系(Ada Lovelace架构)、50系(Blackwell架构)全系列NVIDIA显卡,新架构在AI推理效率上有显著提升
- 显存要求友好,最低16G显存即可运行标准工作流(6G显卡通过模型量化如FP8、INT4和分块推理Tiling等优化方案也能参与部分流程)
- 内置加速插件与预设工作流,拖入ComfyUI即可直接出片
视频生成对显存(VRAM)的需求远高于图像生成,因为模型需要同时在显存中维持多帧的潜空间表示。16GB显存(如RTX 4080、RTX 5080)是当前运行完整视频生成模型的基础门槛,可以生成标准分辨率(如720p)的短视频;24GB显存(如RTX 4090、RTX 3090)则能支持更高分辨率和更长时长的生成。
即便没有深厚技术背景的用户,也能在本地搭建起一套完整的AI视频生产线。
从云端体验到本地调优的完整学习路径
对于不同基础的用户,可以按照循序渐进的方式学习MiniMax H3的使用。
整套学习路径涵盖三个层次:
- 云端免安装体验:让新手快速建立直观认知,先感受模型的实际效果,无需任何硬件投入即可上手
- 本地部署:提供完整的环境搭建方案,包括模型下载与ComfyUI配置,让用户摆脱云端平台的费用限制
- 参数调优:面向进阶用户,讲解如何精细控制生成效果,包括采样步数、CFG(Classifier-Free Guidance)强度、去噪策略等关键参数的调整,提升画面质量与生成效率
三套完整工作流分别覆盖文生视频、图生视频与参考生视频三大场景。
总结:MiniMax H3开源对创作者意味着什么
MiniMax H3的开源,本质上是把过去需要按秒付费的高端AI视频生成能力,交还到了每一位创作者手中。当生成成本从"比房租还贵"降到"只算电费"时,AI视频创作的可能性被极大释放。
需要注意的是,本地部署仍需一定的硬件基础:显存大小会影响可生成的分辨率,显卡性能决定生成速度。对于追求4K高清与长视频的用户,硬件升级和工作流调参仍是需要持续探索的课题。但无论如何,MiniMax H3的开源让"人人都能用AI做视频"这件事变得触手可及。
核心要点
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。