MiniMax M3.1 Flash评测:Agent性能与成本双突破

MiniMax 发布 M3.1 Flash,以百万上下文和低价主攻 Agent 规模化落地
MiniMax 更新 M3.1 Flash,定位为面向 Agent 场景的高性价比模型。它提供 100 万 Token 上下文窗口、原生多模态输入和五档可调的思考深度,且思考能力无法关闭,强制模型在 Agent 任务中保留推理步骤。性能上,复杂编程评测 Deeps V1.1 得分 73.7%,电脑操作 Oathworld 得分 61.7,输出速度超过 200 TPS,比上一代快近三倍;但在官方 15 项评测中仅 3 项第一,其余均进入前四,属于均衡型第一梯队而非全能冠军。成本方面,输入百万 Token 一元、输出四元、缓存读取一毛,官方称 Agent 类任务综合开销下降七成。M2.5 和 M2.7 将于 11 月 18 日下线,订阅用户请求自动转发至新模型。
MiniMax 更新了 M3.1 Flash,官方标题直指“重新定义 Agent 的性能与成本”。从公开的数据看,它在复杂编程评测 Deeps V1.1 上拿到 73.7%,电脑操作 Oathworld 得分 61.7,输出速度超过 200 TPS,比上一代快了近三倍。对做 Agent 应用的开发者来说,这组数字意味着两件事:响应更快,单次任务成本更低。
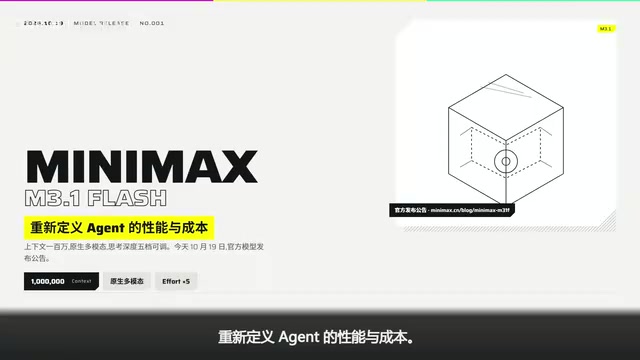
一、核心规格:100万上下文与原生多模态
M3.1 Flash 提供 100 万 Token 的上下文窗口,支持原生多模态输入,思考深度五档可调,并且该能力无法关闭。这意味着模型默认就处于“带思考”的工作模式,不需要额外开关。对于需要处理长文档、完整代码库或大规模日志的 Agent 场景,100 万上下文显著减少了分段处理和信息丢失的问题。
思考深度五档可调的设计,让开发者可以根据任务复杂度在速度与推理质量之间做取舍。简单任务用低档位快速返回,复杂规划任务用高档位获取更完整的推理链。官方强调“关不掉”,实际上是强制模型在 Agent 任务中保留推理步骤,避免为了省成本而牺牲任务成功率。
二、性能定位:第一梯队,但不是全能冠军
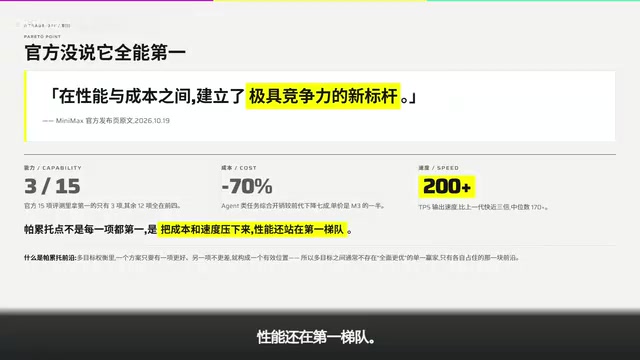
官方公布了一份 15 项评测的对比表,M3.1 Flash 在其中只有 3 项排第一,其余全部进入前四。这个分布很能说明问题:它不是每一项都拔尖的“全能冠军”,但也没有明显短板。换句话说,模型在大多数维度上都处在第一梯队,同时把成本和速度压了下来。
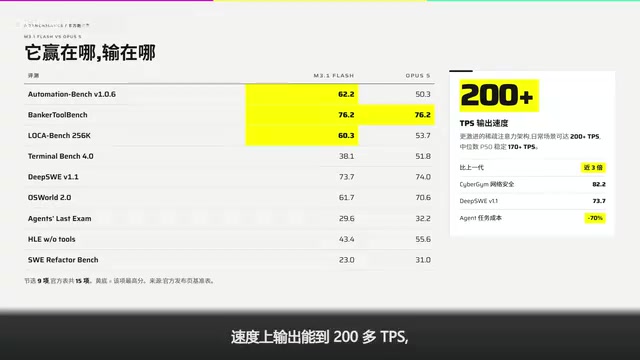
从 Agent 应用的实际需求看,这种偏均衡的定位往往比单项冠军更实用。Agent 任务通常涉及规划、工具调用、代码生成和多轮修正,任何一个环节掉链子都会影响整体成功率。M3.1 Flash 在复杂编程评测 Deeps V1.1 上达到 73.7%,电脑操作 Oathworld 拿到 61.7 分,说明它在代码和操作两类关键任务上都有稳定表现。
速度方面,输出超过 200 TPS,比上一代快了近三倍。对于需要多轮交互的 Agent 来说,输出速度直接影响用户体验和任务完成时间,这个提升幅度相当可观。
TPS(Tokens Per Second,每秒输出 Token 数)是衡量大语言模型推理速度的常用指标,数值越高代表模型生成文字越快。对 Agent 应用来说,TPS 不仅影响用户等待时间,还直接关系到多轮工具调用任务的完成效率——一次 Agent 任务往往包含数十次模型调用,单次响应慢几百毫秒,累积起来就会明显拖长整体任务时长。200 TPS 意味着每秒可输出约 200 个 Token,大致相当于每秒 100 多个汉字,已经接近甚至超过人类快速阅读的速度。需要注意的是,厂商标注的 TPS 通常是理想条件下的峰值吞吐,实际使用中会受并发量、输入长度、思考深度档位等因素影响,尤其是开启高思考档位时,模型会先进行内部推理再输出,端到端延迟可能明显高于标称值。
三、成本结构:Agent 综合开销降七成
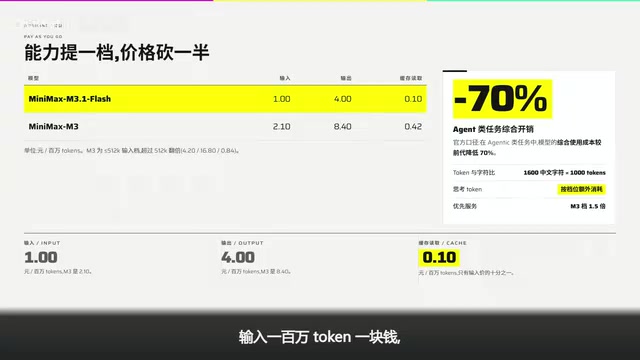
官方给出的定价是:输入 100 万 Token 一块钱,输出四块钱,缓存读取一毛钱。按官方说法,Agent 类任务的综合开销下降了七成。这个降幅主要来自两方面:一是单价本身较低,二是缓存读取价格极低,适合 Agent 场景中反复引用同一段上下文的工作模式。
100 万 Token 输入一块钱的定价,配合 100 万上下文窗口,意味着开发者可以把整个代码库或大体积知识库直接放进上下文,而不必做复杂的检索分段。对于代码 Agent、文档分析 Agent 这类应用,这直接降低了工程复杂度和调用成本。
缓存读取(Prompt Caching)是当前大模型 API 的一项关键优化机制:当多次请求包含相同的前缀上下文(例如固定的系统提示词、整段代码库或知识库)时,服务端会缓存这部分内容的计算结果,后续请求只需按远低于正常输入的价格读取缓存,而无需重新计算。对于 Agent 场景,这一点尤为重要,因为 Agent 往往在同一段长上下文上反复进行多轮工具调用和推理,缓存命中率很高。文章中“缓存读取一毛钱”对比“输入一块钱”,意味着命中缓存的输入成本仅为正常输入的十分之一,这正是 Agent 综合开销能下降七成的重要来源之一。开发者在使用时应注意将稳定不变的内容放在请求前部、可变内容放在后部,以最大化缓存命中率。
四、迁移安排:M2.5 与 M2.7 即将下线
老用户需要留意版本切换。M2.5 和 M2.7 已停止对新用户开放,并将在 11 月 18 日正式下线。订阅用户不需要修改代码,请求会自动转到 M3.1 Flash。官方同时提到,按量付费稍后开放,Pro 版本也在路上。
自动转发的安排降低了迁移成本,但开发者仍需验证原有 Prompt 和工具调用逻辑在新模型下的表现。思考深度不可关闭这一变化,可能影响那些依赖固定输出格式或低延迟响应的旧应用,建议在下线前做一轮回归测试。
回归测试(Regression Testing)是指在模型或系统变更后,重新运行既有测试用例,以确认原有功能没有被破坏。在大模型版本迁移中,回归测试尤其重要,因为模型行为具有概率性,即使接口和参数不变,输出的格式、语气、工具调用决策也可能发生变化。对于依赖固定输出格式(如 JSON 结构)或对延迟敏感的应用,思考深度不可关闭这一变化可能导致输出中出现额外的推理内容或响应变慢,需要通过回归测试提前发现。建议开发者在 M2.5 和 M2.7 下线前,用有代表性的真实任务样本对比新旧模型的输出,重点检查结构化输出解析、工具调用参数正确性和端到端延迟三项指标。
五、适合谁用
M3.1 Flash 的定位很清晰:面向 Agent 场景,用均衡的性能和显著降低的成本换取更大的调用量。如果你的应用需要长上下文、多轮工具调用、代码理解或电脑操作能力,同时对新模型的多模态和思考深度可调有需求,它是一个值得评估的选项。但如果你的任务对单项能力有极高要求,官方那张 15 项评测表里只有 3 项第一的事实,提醒你需要针对自己的场景做实测,而不是只看总榜。
能装下整个代码库的上下文,配合按半价卖的定价策略,MiniMax 这次把竞争焦点放在了 Agent 的规模化落地成本上。对开发者来说,这意味着可以用更低的预算跑更多的 Agent 任务,但前提是选对场景、做好迁移验证。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。