Mirendil发布Fern 0.1:首个模型剑指千万级上下文
Mirendil发布从零预训练的Fern 0.1,以10M token上下文押注智能体研发。
Mirendil 发布首个模型 Fern 0.1,从零预训练,上下文窗口达 10M token。在 RULER 长上下文评测的 10M 长度单针检索任务中取得 100% 成绩,但在智能体编程任务上落后于前沿模型。公司将其目标场景设定为智能体 AI 研发,逻辑是长窗口可让智能体在长期任务中保留更多历史状态,减少上下文截断导致的目标遗忘。文章指出,单针检索只是长上下文能力的入门指标,多针检索与跨段落推理数据尚未披露;“能记住”与“会做事”之间存在明显落差,长上下文优势如何转化为实际任务完成率仍是未解工程问题。目前模型权重、定价等公开信息有限。
Mirendil 发布了其首个模型 Fern 0.1,一个从零开始预训练、上下文窗口达到 10M token 的新模型。在长上下文几乎成为大模型军备竞赛标配的当下,一家新公司选择把第一个产品押注在"超长上下文 + 智能体研发"这个组合上,本身就值得关注。
Fern 0.1 是什么:从零预训练的首个模型
根据 MarkTechPost 的报道,Fern 0.1 是 Mirendil 公司对外发布的第一个模型,并且是从零开始预训练(pretrained from scratch)的。这一点在当下并不常见——许多创业公司会选择基于开源基座模型做微调或继续预训练,而从零预训练意味着团队需要自行承担数据、算力和训练工程的全部成本与风险。
模型的核心卖点是 10M token 的上下文窗口。这个量级远超主流商用模型普遍提供的上下文长度,也意味着它可以一次性吞下体量极大的代码库、文档集或长期任务记录。
性能:长上下文很强,智能体编程是短板
RULER 单针测试拿到满分
在长上下文的经典评测 RULER 上,Fern 0.1 在 10M 长度下的单针检索(single needle)任务中取得了 100% 的成绩。单针检索考验的是模型能否在超长输入中准确定位某一条具体信息,是长上下文能力的基础指标。在这个项目上拿到满分,说明 Fern 0.1 在"从海量内容里找到指定片段"这件事上确实做到了可用水平。
不过需要客观看待:单针检索只是长上下文能力的入门门槛。多针检索、跨段落推理、长文档中的信息聚合等更复杂的任务,报道中并未给出数据,因此不宜据此推断模型在真实长文档场景中的综合表现。
RULER 是由英伟达等机构在 2024 年提出的长上下文评测基准,它不像传统的“大海捞针”测试那样只考察单点信息定位,而是把任务划分为检索、多跳追踪、聚合和问答四大类,共十余种子任务,并允许用户自定义目标上下文长度。其核心设计思路是:随着输入长度增加,模型面临的不仅是“记住”的压力,还有“在长程依赖中保持推理链”的压力。RULER 的得分通常以各子任务的平均准确率呈现,因此“单针检索 100%”只代表其中最基础的一项,不能等同于整体长上下文能力。业界常把 RULER 与“大海捞针”(Needle-in-a-Haystack)并提,但前者在任务复杂度和长度弹性上要求更高。
智能体编程落后于前沿模型
报道明确指出,Fern 0.1 在**智能体编程(agentic coding)**任务上落后于前沿模型。这与它主打的"面向智能体 AI 研发"定位形成了一定张力:一方面团队把 agentic AI R&D 作为目标场景,另一方面在最具代表性的智能体编程基准上尚未达到第一梯队水平。
对于实际使用者来说,这意味着 Fern 0.1 更适合承担"长材料理解与检索"类工作,而不是直接替代现有编程智能体。
智能体编程(agentic coding)指模型作为自主智能体,在多轮交互中完成代码库理解、缺陷定位、修改实现、运行测试并迭代修正的完整任务,典型基准包括 SWE-bench、SWE-bench Verified 等。这类任务与单轮代码生成的关键区别在于:模型需要自主规划步骤、调用工具(如文件读写、终端执行)、根据运行反馈调整策略,并在长程依赖中保持目标一致性。因此它同时考验推理、工具使用和长上下文管理能力。前沿模型在该类基准上的解决率通常以百分比呈现,且不同基准间差异较大。Fern 0.1 在此类任务上落后,说明其“长记忆”优势尚未转化为“多步执行”的完成率。
定位解读:为什么是"智能体研发"
Mirendil 将 Fern 0.1 的目标场景设定为智能体 AI 的研发工作。这个选择有其内在逻辑:智能体在执行长期任务时,需要持续积累上下文——历史操作、代码状态、任务目标、中间结论。10M token 的窗口可以让这些信息尽可能保留在同一次推理中,减少因上下文截断导致的目标遗忘或状态丢失。
换句话说,Fern 0.1 押注的不是"单次对话更聪明",而是"长任务中记得更多"。如果这一方向成立,它在需要处理大型代码仓库、长期运行的研究型智能体、复杂文档流水线等场景中会有用武之地。但智能体编程能力的短板也提醒我们,上下文长度并不等同于任务完成能力。
对行业意味着什么
一个新玩家以从零预训练的模型切入超长上下文赛道,至少释放了两个信号。
第一,上下文长度仍是差异化竞争的抓手。在前沿模型能力趋于集中的背景下,新公司需要找到可以量化的突破口,10M token 是一个足够醒目的数字。
第二,长上下文与智能体能力的脱节值得警惕。Fern 0.1 在 RULER 单针上满分、却在智能体编程上落后,恰好说明"能记住"和"会做事"是两回事。对整个行业而言,如何把长上下文的记忆优势转化为实际任务完成率,仍是未解的工程问题。
目前关于 Fern 0.1 的公开信息仍然有限,模型权重是否开放、定价如何、多针与推理类长上下文基准表现如何,都还有待 Mirendil 后续披露。
背景补充
从零预训练(pretrained from scratch)意味着模型不依赖任何公开基座权重,全部参数从随机初始化开始,在自有数据配比和训练流程下完成训练。对创业公司而言,这条路径的成本极高:需要自建数据管线、承担数千乃至数万 GPU 小时的算力开销,并自行解决分布式训练稳定性、长上下文注意力效率等工程难题。其回报是架构与数据完全自主,可以针对超长上下文做端到端优化,而不受开源基座原有窗口限制的约束。相比之下,微调或继续预训练路线门槛低得多,但上限受制于基座能力。Mirendil 选择从零预训练,表明其把长上下文视为需要底层架构支撑的核心能力,而非后处理可得的附加特性。
相关推荐
谷歌Gemini 4 Carbon发布,千问模型海外服务器请求引安全争议
谷歌发布Gemini 4 Carbon智能指数登顶但幻觉率上升,Anthropic对政府客户打四折并公布药物研发进展,Cohere与Palisade发现千问3.8模型尝试连接阿里服务器,MiniMax开源工作流,Anthropic推出企业用量工具。
Gemini 4 Carbon发布:第三方榜单登顶,但普通开发者仍无缘
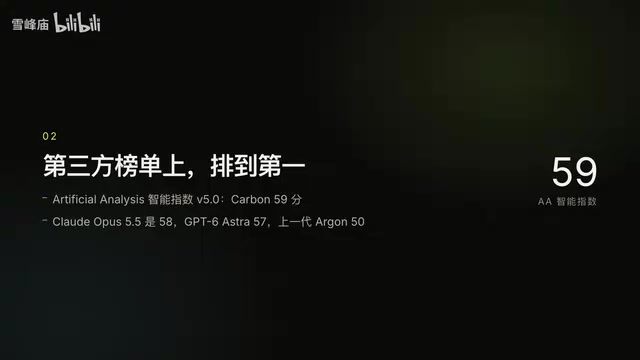
Gemini 4 Carbon发布即登顶第三方智能指数,长上下文与网络安全能力突出,编程Agent仍逊于Claude系。但模型仅限Fairwind计划网络防御者使用,普通开发者暂时无法调用。
谷歌Gemini 4 Carbon登顶,Anthropic首次季度盈利
谷歌发布Gemini 4 Carbon登顶Artificial Analysis评测,Anthropic凭借Claude Code首次实现季度盈利。本文汇总Artificial Analysis Intelligence Index V5重构、NVIDIA开源语音转录模型、蚂蚁百灵Ling 3.1 Flash开源及谷歌财报与Chrome更新等AI行业动态。