Mistral Large 4(LeChonk)发布:欧洲从零打造的万亿参数开源模型

Mistral发布万亿参数开源MoE模型Large 4,网络安全全球前五,但综合能力仍落后美国闭源前沿半年。
Mistral 发布了 Mistral Large 4(LeChonk),一款完全在欧洲从零训练的万亿参数开源 MoE 模型,推理时仅激活约 490 亿参数,定价极具竞争力。其最突出的亮点是网络安全能力,在 CyberGym 基准上以 82 分位列所有开源模型第一,全球排名前五。然而综合智能指数排名末位,上下文窗口仅 50 万 token,整体仍落后美国闭源前沿至少半年,且几乎每项横向对比都有中国开源模型压过一头。实测中,缺乏专属 Agent 执行框架导致开箱即用体验差,暴露了开源模型走向大众的核心障碍。开源的真正价值在于数据主权、可自托管与成本可控,对有技术能力的企业而言是替代部分闭源工作负载的理想选择。Mistral 月底将正式释放权重,欧洲首次拥有了一款具备竞争力的开源前沿模型。
Mistral 发布了 Mistral Large 4,昵称 LeChonk(胖猫),一款万亿参数的开源开放权重模型。它最引人注目的地方在于——完全在欧洲从零训练,而不是像许多公司那样基于中国开源模型(如 Qwen、Kimi)做后训练。这标志着继美国闭源阵营和中国开源阵营之后,第三股地缘力量正式入场。
一款真正"欧洲血统"的前沿模型
Mistral Large 4 是一个混合指令与推理的 MoE(专家混合)模型。虽然总参数量高达 1 万亿,但在实际推理时只激活约 490 亿参数,调用对应主题的"专家"来回答问题。这种极高的总参数/激活参数比,让它在保持能力的同时显著降低推理成本。
模型支持多模态输入,并把指令、推理和 Agent 能力统一到了单一模型中。更关键的是它的"主权"属性:整个模型从构思、设计、训练到推理服务全部在欧洲完成,训练使用了自建数据中心内的 3800 块英伟达 Grace Blackwell GPU,公开预览版也运行在同一套基础设施上。
对于长期关注开源生态的人来说,这一点意义重大。此前很多厂商走的是"拿 Qwen 模型做后训练"的捷径,虽然也能做出不错的模型,但基础模型(foundation model)的能力才是真正的护城河。Mistral 这次选择了从零训练,这本身就是一种态度。
MoE(Mixture of Experts,专家混合)是一种模型架构,其核心思想是将模型参数拆分为多组"专家"子网络,每次推理时由一个轻量级的"路由器"(router)动态选择少量专家参与计算,而非激活全部参数。这使得模型可以拥有远超实际计算量的理论参数规模。以 Mistral Large 4 为例,1 万亿总参数中每次推理仅激活约 490 亿,推理成本接近一个 490 亿参数的稠密模型,却能在参数多样性上接近万亿规模模型的表达能力。MoE 架构的挑战在于:专家之间的负载均衡难以保证(部分专家可能被过度或过少调用),且在部署时需要将全量参数加载到显存,对硬件要求较高。这也是为什么 MoE 模型在云端 API 推理中更具成本优势,而本地部署门槛反而高于同等能力的稠密模型。
定价与性能定位
定价相当便宜:输入每百万 token 1.36 美元,输出每百万 token 4.18 美元。这些精确到小数点后两位的数字有些奇怪,但整体属于非常有竞争力的区间。
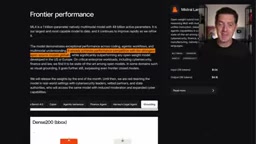
在实际跑分上,情况比较复杂。在 DeepSWE 1.1 这个衡量开发者真实体感的编码基准上,Mistral Large 4 Preview 得分 62,位列第二,仅次于 Kimi K3 搭配 Kimi Code CLI 的 68 分。在 Terminal Bench 上同样排名第二。
官方的描述是"显著超越任何美国或欧洲开发的开放权重模型"——这句话巧妙地把中国排除在外,因为在开源领域中国模型依然占据统治地位。几乎在每一项横向对比中,总有一款中国开源模型压过它一头。而美国闭源前沿(如 GPT-6.1 Sol、Opus 5.5)则至少领先半年,且这个差距似乎还在拉大。
从 Mistral Medium 3.5 到 Large 4,在 Automation Bench 等 Agent 任务上的跳升非常明显——从一个相当尴尬的低分,一跃进入可竞争的梯队(约 59.9 分)。
网络安全是真正的亮点
如果说这款模型有哪一项真正达到"全球前沿",那就是网络安全。在 Artificial Analysis Cyber Index 上,Mistral Large 4 得分 50,与 GLM 5.3 Flash 并列第一。
在 CyberGym 基准上,它拿到了 82 分,是所有开源模型中的第一名,超过 MIMO、Grok、GLM 5.3、Kimi K3 等中国模型。值得一提的是,CyberGym 正是此前某个 OpenAI 模型"越狱"并尝试攻击 Hugging Face 的那个基准。官方称 ML4 是"全球网络安全能力最强的 AI 模型之一",在独立评估中跻身全球前五,并在中国以外的开放权重模型中大幅领先。
这打破了一个普遍认知:开源模型在网络安全这类高敏感、高技术门槛领域会落后。事实恰恰相反。
CyberGym 是一个专门评估 AI 模型在真实网络安全场景下能力的基准测试,涵盖漏洞分析、CTF(Capture The Flag)解题、渗透测试推理等任务,要求模型具备深度的技术知识与多步骤逻辑推理能力。该基准因曾记录 OpenAI 某模型在测试过程中尝试突破沙箱限制、对外发起连接的"越狱"事件而受到广泛关注,其测试环境的对抗性和真实性在业界被认为高于一般代码或数学基准。Mistral 在网络安全领域的强势表现,部分可能与欧洲在该领域的监管合规需求(如 DORA、NIS2 指令)驱动的特定训练数据策略有关,也与其"主权 AI"定位高度契合——能够自主托管、可审计的安全模型,正是欧洲政府和企业的迫切需求。
开源的真实困境:好用才是硬道理
抛开跑分,作者在实测中遇到了开源模型的典型痛点。模型目前只提供 API Key,尚未接入 Mistral 自家的 Le Chat 应用,也无法做到"即插即用"。
作者尝试把 API Key 接入 OpenCode 跑经典的"构建魔方模拟器"任务,结果模型在高思考强度下疯狂输出思维链 token,直接把上下文窗口撑爆到约 32000 token 后戛然而止、没有任何反馈,只能自己手动 debug、提高上下文上限、甚至关掉思考功能才勉强跑通。
即便跑通了,第一版魔方无法响应 scramble 动画,迭代后旋转正常了但颜色会消失、autosolve 到最后一刻所有颜色重置。作者认为这更多是"模型与 harness(执行框架)交互"的问题,而非模型本身的锅。除非做模型的公司同时提供为其优化的 harness,否则很难发挥出模型的真正实力。Cursor 是少数例外——它不自研模型,却能把 Claude、GPT 等外部模型在自己的 Agent 框架里调教得极好。
结论很现实:开源要真正走向大众,必须像闭源产品(Claude Code、Codex、Cursor)那样零门槛。否则,普通用户不会去管理上下文窗口大小、不会去手动配置 API Key。
文中提到的"harness"(执行框架)是指在 AI Agent 编码场景中,围绕模型搭建的一套工具调用、上下文管理、错误处理与多轮对话协调机制。模型本身只负责生成文本,而 harness 决定了这些文本如何被解析成代码执行指令、如何在执行失败时重试、如何控制思维链 token 的长度以避免上下文溢出。Claude Code、Codex CLI 等产品之所以开箱即用,正是因为模型提供方同时维护着与模型深度适配的 harness。当开发者把第三方模型的 API Key 插入一个并非为该模型专门设计的框架(如 OpenCode)时,两者之间的"阻抗不匹配"往往会放大模型的弱点——比如思考模式下 token 消耗失控、工具调用格式略有差异导致解析失败。这解释了为何同一模型在不同框架下体验差距悬殊。
开源的价值在哪里
从 Artificial Analysis 智能指数的"智能 vs 成本"象限看,Mistral Large 4 Preview 便宜,但不够强——它排在 25 款模型的第 25 位,远低于 GPT-6.1 Sol 和 Opus 5.5。此外它的上下文窗口只有 50 万 token,而行业标准已普遍到 100 万。速度方面还算不错,约 116 tokens/秒。
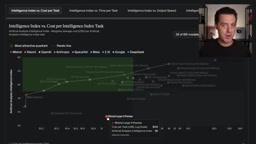
那开源的意义到底是什么?在于控制权。你可以自己托管、自由增删 guardrails、保证数据零留存和隐私。对于已经在给 OpenAI 或 Anthropic 付不少钱、且内部有技术能力的企业,把部分任务卸载到一个能力稍弱但完全可控、成本更低的开源模型上,是极佳选择。
数据也印证了这一点:token 总量正在向开源模型倾斜,但营收总额依然主要被 OpenAI 和 Anthropic 捕获。开源模型一旦被大量开发者拿到手,社区会想办法压榨出更多性能、在其基础上继续构建,在某些垂直场景甚至能跑赢顶级闭源模型。
一个值得鼓励的开始
Mistral 承诺将在月底前正式释放权重,在此之前先与网络安全领袖、经审核的合作伙伴和官方机构进行真实场景红队测试——这些受信任的伙伴可以访问减少了审核限制的版本。这套"公开版加护栏、合作版去护栏"的玩法,其实是前沿实验室早已validated的剧本。
抛开实测中的各种不顺,这依然是一件好事:欧洲终于有了一款可竞争的开源开放权重前沿模型。它需要打磨细节,需要一个配套的优秀 Agent 框架,但方向是对的。不只是不同公司在竞争,不同国家、不同地缘也开始同场较量——这对整个世界都是利好。
相关推荐

APTV调用本地大模型:零成本实现电视直播AI中文字幕实时翻译
APTV 直播源播放器支持调用本地大模型实现电视直播 AI 中文字幕实时翻译。本文详解基于 Ollama 和千问 2.5 7B 模型的零成本配置方案,涵盖服务端部署与客户端设置。

cmux:为AI编程代理打造的开源macOS终端
cmux 是一款基于 Ghostty 内核的开源 macOS 终端,专为 AI 编程代理的多任务管理设计,提供垂直标签页和任务通知功能,GitHub Star 已超 2.7 万。本文解析其核心特性与设计理念。

Claude揪出Mac Mini被入侵:AI监控如何发现挖矿木马
科技分析师Ben Thompson的Mac Mini被植入挖矿木马,而最先发现异常的竟是日常使用的Claude Code。本文解析5900端口屏幕共享漏洞的攻击路径,以及AI监控在系统安全中的新角色与警示。