APTV调用本地大模型:零成本实现电视直播AI中文字幕实时翻译

APTV 联动本地 Ollama 大模型,零费用实现外语直播实时中文字幕翻译。
直播播放器 APTV 新增 AI 字幕实时翻译功能,通过「语音识别 + 本地大模型翻译」的流水线,将外语直播实时转写并翻译为中文字幕。整套方案以 Ollama 在 Mac mini M4 等 Apple Silicon 设备上部署千问 2.5 7B 模型为核心,局域网内的 APTV 客户端直接调用该 API,无需任何云端付费接口。服务端需完成安装 Ollama、开放局域网端口、设置开机自启三步;客户端配置语音识别模型和模型 API 地址后即可启用。字幕同步效果主要受直播源网络质量和音频清晰度影响,对有 Apple Silicon 设备、常看外语直播的技术玩家来说,这是一个低成本、可长期运行的本地化方案。
直播源播放器 APTV 新增了 AI 字幕实时翻译功能,配合本地部署的大模型,可以把外语电视直播实时转写并翻译成中文字幕。整套方案无需付费的云端翻译 API,对持有 Mac mini M4(视频中称 MarkMini N4)这类设备的用户来说,几乎是零成本就能跑起来的本地化方案。
据 B 站 UP 主迪恩的演示,这套流程的核心在于:用 Ollama 在本机拉起一个大模型服务,再让 APTV 通过局域网调用这个 API 完成翻译。下面梳理一下它的工作原理和完整配置思路。
实时翻译的工作原理
APTV 的直播 AI 字幕其实是一条「语音识别 + 大模型翻译」的流水线。播放直播流时,语音识别模型先根据音频生成原语种的实时字幕;随后 APTV 把这段文字通过 API 传输到运行着大模型的 Mac mini 进行翻译;翻译完成后,中文文字再回传到 APTV 渲染显示。
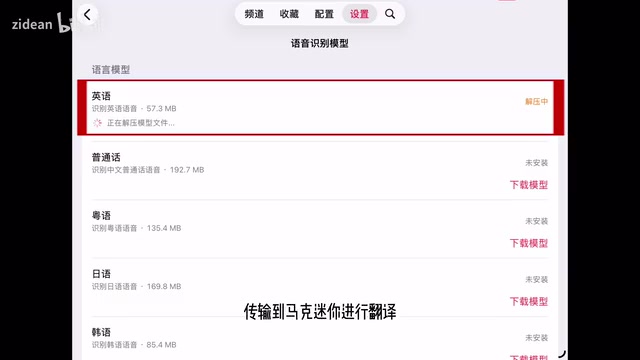
这种架构的好处是把算力压力分散到本地设备,语音识别和翻译各司其职。缺点同样明显:字幕能否与画面同步,很大程度取决于直播源本身的网络传输质量和音频清晰度。换句话说,瓶颈往往不在模型,而在直播源的稳定性。
模型选择与硬件匹配
视频中根据 Mac mini 的硬件性能,推荐使用通义千问广告 2.5 的 7B 视觉版本(Qwen2.5-VL 7B)作为翻译引擎。对于 Apple Silicon 这类统一内存架构的设备来说,7B 规模是一个相对平衡的选择——既能保证翻译质量,又不至于让推理延迟拖垮实时性。
UP 主明确表示,千问 2.5 的 7B 模型「完全可以应对翻译负荷需求」。这里需要理性看待:直播翻译是流式、短句、高频的任务,对模型的即时响应要求高于长文理解能力,7B 量级在这种场景下确实够用。如果设备内存更充裕,也可以尝试更大参数的模型以提升专业术语和长句的翻译准确度。
Apple Silicon 的统一内存架构(Unified Memory Architecture,UMA)与传统 CPU+独显的分离式内存设计有本质区别:CPU、GPU 和神经网络加速器共享同一块物理内存池,数据无需在不同内存间来回拷贝,带宽利用率极高。这一特性使得运行大语言模型时,内存容量直接决定可加载的模型参数量——16GB 统一内存的 Mac mini M4 可以流畅运行 7B 量级模型,而无需像 PC 平台那样还要单独考虑显存瓶颈。7B 模型在 4-bit 量化后约占 4-5GB 内存,为系统和语音识别模型留出足够空间,这也是视频中选择该规模模型的硬件依据。
服务端配置:用 Ollama 跑起本地模型
服务端的搭建围绕 Ollama 展开,大致分三步:
1. 安装 Ollama 并拉取模型
前往 Ollama 官网下载客户端完成安装,打开终端执行拉取命令,把千问大模型下载到本地。模型文件较大,首次拉取需要一些耐心。
2. 开放局域网访问
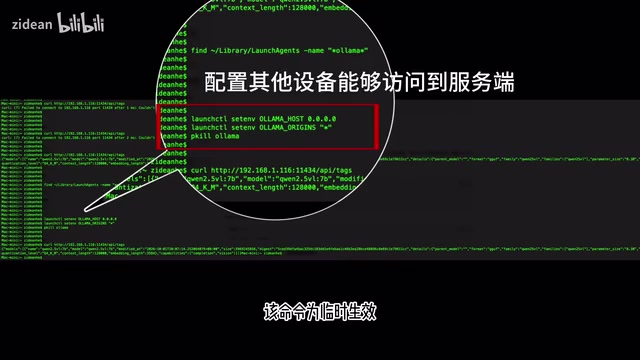
默认情况下 Ollama 只监听本机,其他设备访问不到。需要通过设置环境变量(如 OLLAMA_HOST)让局域网内其他使用 APTV 的设备能够访问 Ollama 的 API 端口。
3. 设置开机自启
UP 主提醒,开放端口的命令通常是临时生效的,重启后会失效。建议把它写成脚本,让设备每次开机都自动执行,省去反复手动配置的麻烦。这一步对把 Mac mini 当作长期运行的「翻译服务器」尤其实用。
Ollama 是一个专为本地部署开源大语言模型设计的运行时框架,它封装了模型下载、量化格式管理和 OpenAI 兼容 API 服务等功能,让用户无需手动处理复杂的模型权重转换和推理环境配置。其对外暴露的 HTTP API 与 OpenAI 的接口格式高度兼容,这意味着任何支持自定义 API 地址的应用(如 APTV)都可以直接对接 Ollama,而无需专门适配。默认情况下,Ollama 监听本机的 11434 端口,通过修改 OLLAMA_HOST 环境变量为 0.0.0.0:11434,即可让同一局域网内的其他设备访问该服务,这正是 APTV 能跨设备调用 Mac mini 上模型的技术基础。
APTV 客户端配置
服务端就绪后,回到 APTV 进行调用配置,整个过程分为字幕识别和翻译两部分。
在「实时字幕」设置下点击语音识别模型,根据要翻译的语种下载并调用对应的识别模型。接着在字幕样式里设定翻译后字幕的显示效果,完成后点击自动开启。
翻译环节在「实时翻译字幕」下进入翻译服务配置,选择「大模型翻译」,然后填入 Ollama 的 API 地址和端口。
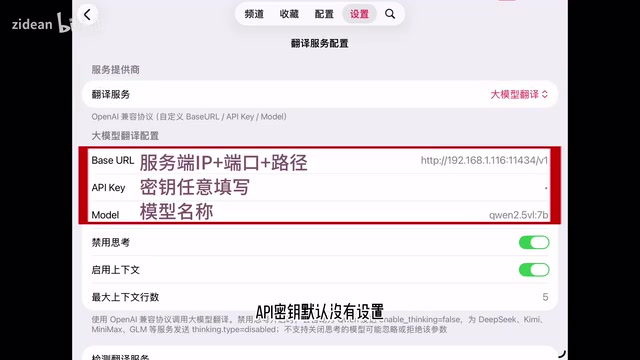
API 密钥这一项由于 Ollama 默认不设密钥,随意填写即可,最后点击启用上下文完成全部配置。启用上下文有助于模型结合前后句意,减少逐句翻译导致的割裂感。
配置完成后,打开直播源的 AI 字幕实时翻译功能,翻译字幕便会自动开始生效。
实际体验与适用人群
这套方案的最大亮点是「零 API 费用」。市面上多数实时翻译依赖云端付费接口,长期观看外语直播成本不低;而本地大模型方案一次部署、长期白嫖本地算力,对经常看外语体育赛事、新闻直播的用户很有吸引力。
不过也要坦诚它的门槛和局限:一是需要一台性能够用的 Apple Silicon 设备常驻运行;二是实时性依赖直播源质量,网络抖动或音频模糊都会影响字幕同步;三是整套流程涉及终端命令、环境变量、脚本自启,对完全不懂技术的用户有一定上手难度。
总体来看,这是一个把本地大模型落地到日常娱乐场景的有趣实践。它展示了 Ollama + 开源模型在边缘设备上处理实时任务的可行性,对想折腾本地 AI 的玩家来说值得一试。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。