Mistral Large 4发布:1T参数MoE登顶欧美开源榜

Mistral发布1T参数原生多模态MoE模型Large 4,登顶欧美开源权重榜。
Mistral推出新一代旗舰模型Mistral Large 4(昵称Lutronk),采用1万亿参数的原生多模态MoE架构,推理时仅激活490亿参数,在Mistral欧洲自建数据中心的3800张Grace Blackwell上从零训练完成。基准表现上,该模型为欧美开源权重模型第一,AA智能指数38分较上代Medium 3.5的14分翻倍以上;法律金融任务在Wealth.ai评测中超过GPT-6 Extra,Harvey法律智能体评测超越所有开源模型。但榜单头部仍由中国系MiniMax、GLM和Timmy占据,所谓"欧美最强"是区域性头名而非全球开源第一。产品策略上以开源权重加自托管为核心卖点,开放前与网安厂商及政府机构进行真实环境红队测试,训练数据覆盖160多种语言。
法国AI公司Mistral正式推出新一代旗舰模型Mistral Large 4,官方昵称Lutronk。这款模型以1万亿参数的原生多模态MoE架构,在多项基准上拿下欧美开源权重模型第一,成为当前欧美开源阵营的新标杆。
规格与训练:1T参数的稀疏激活路线
Mistral Large 4最引人注目的数字是参数规模——1万亿参数,但推理时只激活490亿参数。这种稀疏MoE设计让模型在保持超大容量的同时控制推理成本,也是当前前沿模型的主流工程思路。
训练从零开始,在Mistral欧洲自建数据中心的3800张英伟达Grace Blackwell上完成。这一细节值得关注:训练完全放在欧洲本土算力上,既是对自建基础设施能力的一次验证,也让"欧洲主权AI"的叙事有了具体支撑。
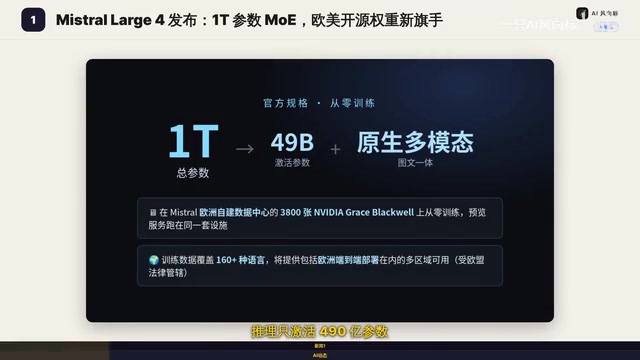
模型定位为原生多模态,公开预览已上线Mistral Studio,完整权重计划于本月底放出。
MoE(混合专家)架构是理解1万亿参数只激活490亿的关键。模型内部由多个"专家"子网络构成,每个token经过路由网络只被分配给少数几个专家计算,因此总参数量决定容量上限,激活参数量决定单次推理的实际算力开销。稀疏激活让模型可以在不按比例增加推理成本的前提下扩大参数规模,但代价是显存占用仍接近总参数量,且路由均衡、专家负载分布等训练细节会显著影响收敛质量。这也是各家前沿模型虽同走MoE路线、实际效率却差异很大的原因。
基准表现:欧美开源第一,专业领域有第三方背书
据快讯披露的成绩,Mistral Large 4在多项基准上是美国和欧洲开源权重模型中表现最好的,视觉定位能力甚至反超部分前沿闭源模型。
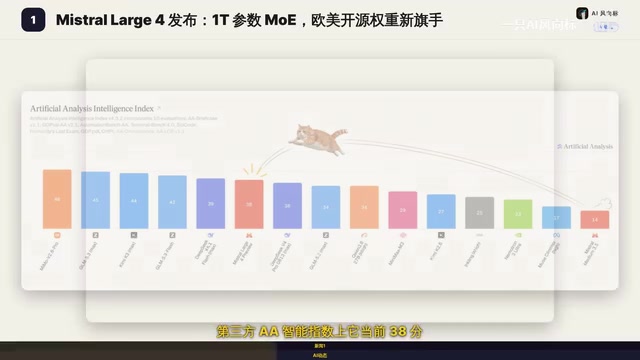
第三方AA智能指数上,Large 4当前得分38分,而自家上一代Medium 3.5为14分,提升幅度超过一倍。这个跨代跃升的幅度,比单纯"登顶欧美榜"更能说明这一代模型的定位变化。
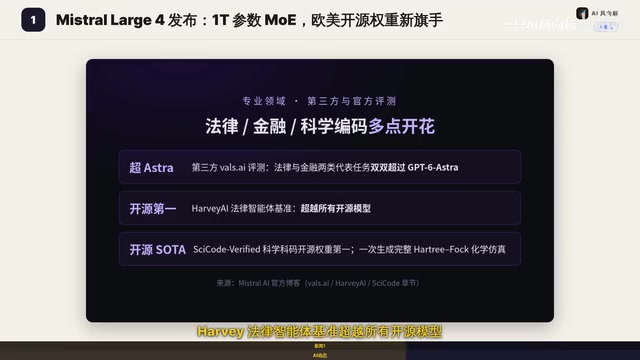
在专业领域,Mistral Large 4拿到了第三方背书:Wealth.ai评测中,法律和金融两项任务双双超过GPT-6 Extra;Harvey法律智能体评测中超越所有开源模型;科学编码Sycode基准上也是开源权重第一。
不过榜单最前面仍是中国系模型MiniMax、GLM和Timmy。所以"欧美最强"的准确含义是区域性的开源权重头名,而非全球开源模型绝对第一。
**AA智能指数(Artificial Analysis Intelligence Index)**是第三方评测机构Artificial Analysis维护的综合榜单,把多项推理、知识、编码、数学基准折算为单一分数,便于跨模型横向比较。它的价值在于评测口径统一、更新频繁,常被用于观察模型代际跃迁;局限在于单一分数会掩盖任务类型间的差异,且不同版本指数的题目集和权重可能调整,跨时间比较需谨慎。因此文中38分对14分的对比,更适合理解为同一评测体系下的相对提升幅度,而非绝对能力倍数的精确度量。
自托管与安全:把自主权一并交付
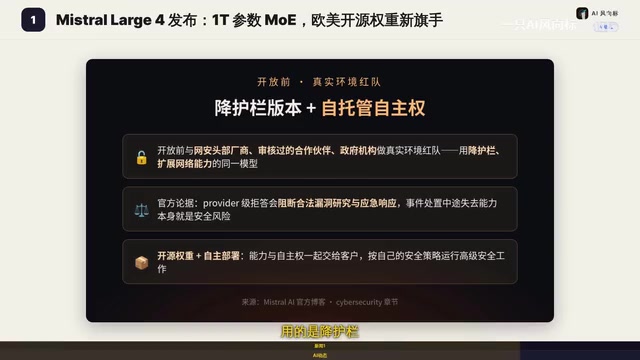
Mistral Large 4延续了自托管的核心卖点。官方明确表示,大型Provider可能阻断合法的漏洞研究与应急响应,而开源权重加自主部署能把能力和自主权一起交给客户。
网络安全是这次最激进的一手。正式开放前,Mistral正与网安头部厂商、经过审核的合作伙伴和政府机构做真实环境红队测试,使用的正是扩展网络能力的同一模型。
训练数据覆盖160多种语言,多语言能力延续了Mistral一贯的欧洲市场优势。
开源权重(open-weight)与开源模型并非同一概念。前者公开的是训练完成后的参数文件,使用者可以自行部署、微调、量化,但通常不包含训练数据、数据配比与完整训练代码,因此不满足OSI的开源定义。这一区别对文中的论点很重要:开源权重足以支撑"自托管、数据不出域"的合规诉求,却不足以让外部复现训练过程或独立审计数据来源。企业评估此类模型时,需同时确认许可证条款(商用范围、再分发限制)与权重之外的配套(推理框架、微调工具链)是否齐备。
**红队测试(red teaming)**指由独立团队以对抗视角主动探测模型漏洞、越狱路径与滥用可能,在网络安全领域还包含对模型自身攻击面(提示注入、工具调用越权、权重泄露)的评估。文中"用扩展网络能力的同一模型做真实环境红队"意味着攻防能力与防护测试共用一套能力底座,这既是效率选择,也带来能力外溢的风险考量——同一份网络能力若缺乏访问控制,可能被用于非授权渗透。这也是Mistral强调"经过审核的合作伙伴与政府机构"参与的原因:把高能力模型的测试限制在可追责的主体范围内。
几点观察
从产品策略看,Mistral Large 4把"开源权重+自托管"和"欧美最强"两个标签绑在一起,瞄准的是对数据主权和部署自主性有硬性要求的企业与政府客户,金融、法律、网安这几个被点名的领域恰好都是合规敏感行业。
从竞争格局看,欧美开源权重榜和中国开源模型之间的差距仍然是这家公司需要面对的现实。AA指数38分是个不错的起点,但榜单头部的位置并没有易主。
权重月底放出后,真实的自托管部署反馈和社区微调效果,会比预览期的基准分数更能说明这代模型的实际水位。
相关推荐

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。