#MoE
共 34 篇相关文章
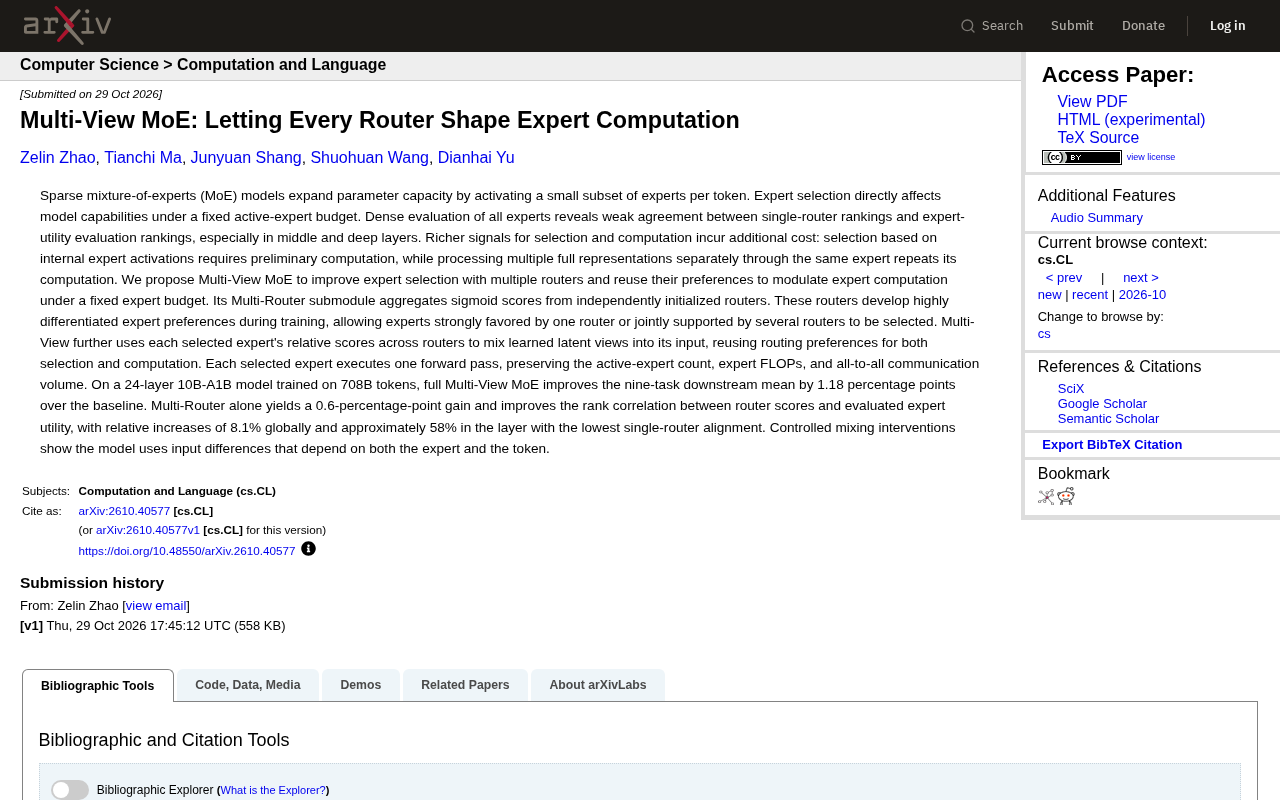
多视图MoE:让每个路由器重塑专家计算
Multi-View MoE提出多路由器与路由偏好复用机制,在不增加激活专家数和FLOPs的前提下改进专家选择。在10B-A1B模型上,九任务平均提升1.18个百分点。

Mistral Large 4发布:1T参数MoE登顶欧美开源榜
Mistral发布旗舰模型Mistral Large 4:1万亿参数MoE架构,推理仅激活490亿参数,在3800张Grace Blackwell上从零训练,登顶欧美开源权重榜,法律金融网安领域获第三方背书。

Prime Intellect推出Prime Mega MoE:可训练融合MoE内核,前向提速3.11倍
Prime Intellect 发布 Prime Mega MoE,为 DeepSeek 融合 Mega MoE 内核实现反向传播,使其可训练。前向传播最高提速 3.11 倍,prime-rl 中 Qwen3 MoE 训练步速最高提升 34%,推动 MoE 训练效率提升。

两天移植,预填充提速8倍:Strata引擎实测
海外实测Strata推理引擎:单卡运行125B模型,预填充速度达llama.cpp的约8倍。解析其专家调度、稀疏注意力与MTP推测解码的设计,以及移植实验、部署门槛与适用边界。

Qwen4架构预览已开源:125B参数、512专家,专为显存受限硬件设计
Qwen4尚未发布但架构已通过Qwen3.8 Flash Next开源预览:125B参数、每Token激活6B、512专家、262K上下文,专为显存受限硬件设计。本文梳理官方确认信息、config.json关键指标及24G内存本地部署实测。
英伟达开源Nemotron 3.5 Transcribe:30B MoE语音模型
英伟达发布 Nemotron 3.5 Transcribe 开源语音大模型:30B MoE 架构、约 4B 激活参数,支持 40 种语言转写,英文 Open ASR Leaderboard 平均 WER 4.71%,并原生集成说话人标签与词级时间戳。
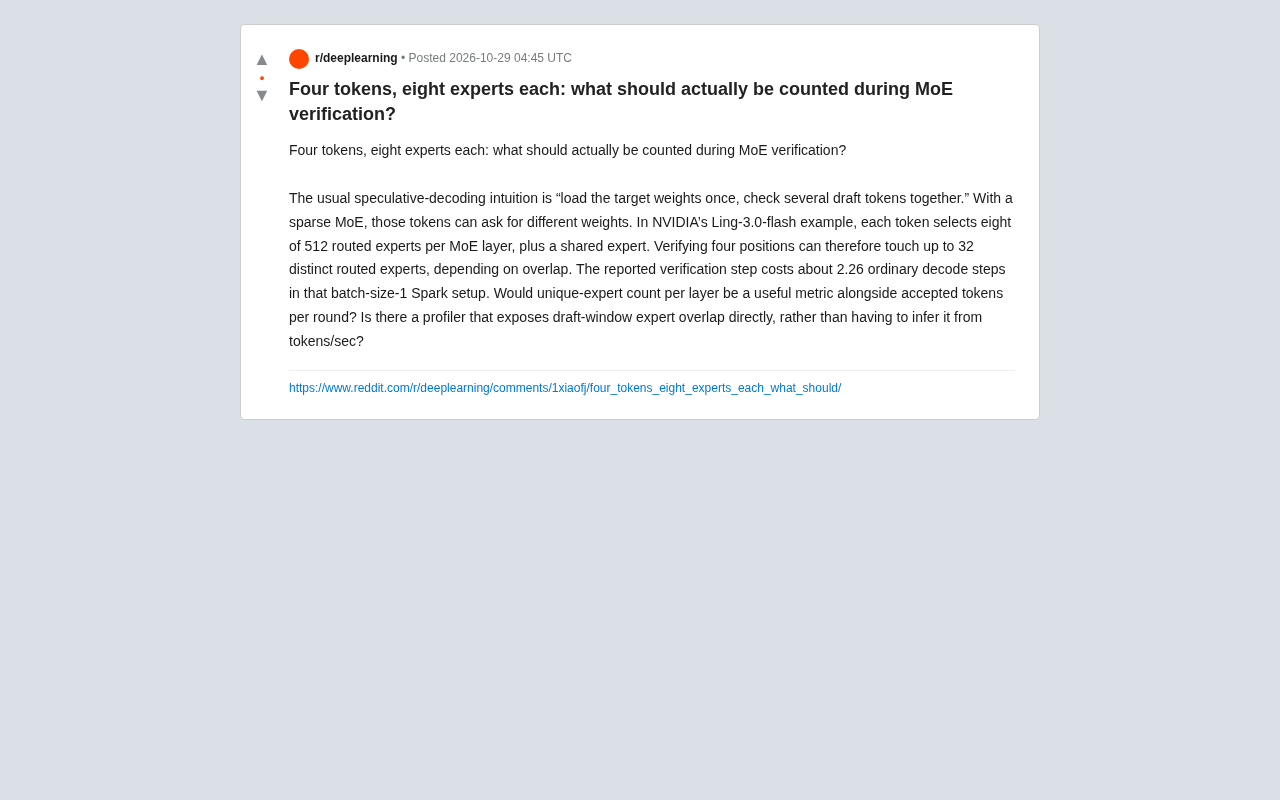
MoE验证该数什么?四token八专家背后的账
MoE投机解码中,验证多个草稿token会触达不同专家权重,四token八专家最多涉及32个路由专家。本文解析唯一专家计数为何应成为接受token数之外的补充指标,以及profiler如何在路由层暴露专家重叠。

Meta 816B模型仅激活5%参数:MoE混合专家架构动画详解
Meta 最新 816B 参数模型每 token 仅激活约 5% 参数,本文结合 Reddit 动画讲解,拆解混合专家 MoE 架构的稀疏激活、路由机制与负载均衡原理,分析其推理成本优势与部署挑战。

iPhone跑35B MoE达20.5 tok/s:不跳专家的调度魔法
OpenBMB 的 MiniCPM-V 4.7 借助 Lookahead Expert Scheduling 技术,让 35B-A3B MoE 模型在 iPhone 上以 20.5 tok/s 运行,不跳过专家,精度仅降 0.16 分,实现已在 llama.cpp-omni 开源。

MiniMax M3.1 Flash发布:428B MoE智能体模型,输入仅$0.15/M
MiniMax 发布 M3.1 Flash:428B 参数 MoE 模型,激活参数约 23B,支持 1M token 上下文,API 输入定价每百万 token 0.15 美元,权重计划 10 月 23 日开放。本文解析其稀疏架构、Agent 定位与定价策略。

llama.cpp MoE缓存实测:T4上30B模型解码速度翻倍
llama.cpp新增MoE专家缓存功能,在免费Tesla T4上让Qwen3-30B-A3B解码速度从22.6提升到43.2 tokens/s。本文详解缓存机制、配置脚本、实测数据以及并发场景下的性能陷阱。

12G显卡跑1250亿参数大模型:Strata本地部署实测
B站UP主FT实测开源项目Strata:一张12G显存游戏电脑本地跑1250亿参数大模型,RTX 5070每秒94 token,显存吃满11.2G,安装只需双击脚本,接口兼容OpenAI。
DeepSeek Flash 1017:单卡跑百万Token的LLM
DeepSeek v4.1-Flash 1017以284B稀疏MoE、每Token激活13B和HSQ-A压缩技术,将KV-cache压降85%,在单张A100上实现百万Token上下文。本文解析其架构、基准数据、单卡部署案例与风险。

开源权重逼近前沿:501B Beam与816B Meta MoE同周登场
一周内 Gemini 4 Argon 正式可用、Meta 816B Muse Spark Open 与 Reflection 501B Beam 相继开源。本文梳理三大前沿模型的能力、定价与硬件门槛,并解读小模型专精化趋势。

家用电脑跑1250亿参数大模型?两万五千星Strata本地部署解析
GitHub两万五千星项目Strata让家用电脑本地运行1250亿参数大模型成为可能。基于MoE架构与显存内存分层方案,兼容OpenAI接口,显卡12G、内存32G即可部署,数据不出本机。

细粒度专家+共享专家:MoE路由探索的两难困境
细粒度专家切分与共享专家的组合存在路由探索困境:共享专家降低token表示多样性,削弱探索动力,使细粒度切分的表达能力无法兑现。MirrorMoE通过自适应抑制缩小探索空间来破解这一矛盾。

Meta开源816B巨兽:Muse Spark Open的机遇与门槛
Meta发布Muse Spark Open开放权重模型,8160亿总参数、420亿激活参数、100万token上下文,支持多模态。本文解析其MoE架构、下载渠道、硬件门槛与Muse Model License限制。

Fish Audio发布Drama 3:35B开放权重MoE语音合成模型
Fish Audio发布Drama 3,35B参数MoE文本转语音模型,激活参数约3B,覆盖83种语言,开放权重采用营收上限社区许可,支持自然语言指令控制语音风格。