Mistral Large 4发布:欧洲最大开源模型剑指前沿

Mistral发布万亿参数MoE开源模型Large 4,剑指中美主导的开源前沿竞赛。
法国AI实验室Mistral推出其迄今最大开源模型Mistral Large 4,采用混合专家(MoE)架构,总参数约1万亿,每token激活约500亿,支持图文多模态输入及100万token超长上下文窗口。官方将其定位为开放权重类别的前沿级模型,强调在编程智能体、网络安全、金融和法律等专业场景领先于其他开源模型。此次发布的特殊意义在于:过去一段时间开源排行榜几乎被DeepSeek、Qwen、Kimi、GLM等中国实验室包揽,Mistral的强势入场代表欧洲AI力量的反击,也为全球开源生态带来新的竞争维度。目前模型处于预览阶段,权重将于本月晚些时候正式开放,届时社区将对其性能声明进行实际检验。
欧洲开源阵营的重磅反击
Mistral刚刚发布了Mistral Large 4,官方给它取了个颇为生动的昵称——"the Chonk"(意为"胖墩儿"),而这个名字确实名副其实。这是一个混合专家(Mixture of Experts, MoE)架构的模型,总参数量约为1万亿,每个token激活其中约500亿参数。
这样的规模让它成为Mistral迄今为止体量最大的开源模型。长期以来,这家法国实验室在高端模型领域相对低调,而Large 4的登场标志着它开始在参数规模和能力上发起正面冲击。
核心能力:多模态与百万级上下文
从技术规格来看,Mistral Large 4具备几个关键特性。它不仅能处理文本,还支持图像输入,是一个真正的多模态模型。更引人注目的是它拥有100万token的上下文窗口,这意味着它能够一次性处理极长的文档、代码库或多轮复杂对话。
MoE架构是这一代大模型的主流选择。通过只激活万亿参数中的一小部分(约5%),模型能够在保持强大能力的同时控制推理成本。这种"大容量、低激活"的设计思路,正是当前开源与闭源前沿模型普遍采用的路线。
混合专家(MoE)架构的核心思想是将模型拆分为多个"专家"子网络,每次推理时由一个轻量级的"路由器"(router)动态选择少数几个专家参与计算,而非激活全部参数。这种设计使得模型的"容量"(可学习的知识总量)与"计算量"(每次推理的实际开销)得以解耦。以Mistral Large 4为例,虽然总参数高达1万亿,但每个token实际只调用约500亿参数,推理成本与一个500亿参数的稠密模型相当。MoE架构的先驱性应用可追溯至Google的Switch Transformer(2021年),此后GPT-4、Mixtral 8x7B等主流模型均采用了类似路线,已成为构建超大规模语言模型的标准范式。
对标全球最强开源模型
Mistral对这款模型的定位相当自信。官方称其为"开放权重类别中的前沿级模型",声称它能与世界上最强的开源模型竞争,并在多项能力上领先于任何美国或欧洲构建的开源模型。
具体来说,Mistral强调Large 4在编程智能体(coding agents)、网络安全、金融和法律等专业领域表现突出。这些恰恰是企业级应用最看重的高价值场景,也暗示了Mistral试图在商业落地层面与竞争对手拉开差距的意图。
打破中国实验室的开源主导地位
这次发布最耐人寻味的一点,在于它所处的竞争格局。过去一段时间,开放权重模型领域几乎被中国实验室主导——DeepSeek广告、通义千问广告(Qwen)、Kimi以及GLM等模型占据了开源排行榜的前列。
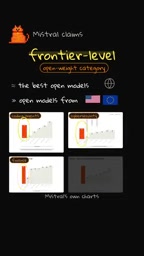
在这样的背景下,一家欧洲实验室能够推出对标顶级水平的开源模型,具有特殊的象征意义。它不仅代表欧洲AI力量的追赶,也为全球开源生态带来了新的多样性。值得一提的是,这次发布距离美国Reflection团队推出Beam模型仅仅一天,开源模型的竞赛节奏正在明显加快。

DeepSeek、通义千问(Qwen)、Kimi(月之暗面)和GLM(智谱AI)代表了中国AI实验室近年来在开源领域的集中爆发。其中DeepSeek-V3和DeepSeek-R1凭借极具竞争力的推理能力和相对低廉的训练成本在国际社区引发广泛关注;Qwen系列则以覆盖从小到大的完整模型族著称;GLM-4和Kimi的长上下文能力也多次登顶开源榜单。这些模型的集中涌现,使得Hugging Face等平台的开源排行榜在2024年底至2025年初几乎由中文实验室包揽前列,也让西方社区开始重新审视开源AI的地缘格局。Mistral Large 4的入场,是欧洲体系在这一格局中发出的为数不多的强力信号之一。
目前仍是预览版,权重即将开放
需要注意的是,Mistral Large 4目前仍处于预览(preview)阶段,Mistral表示模型权重将在本月晚些时候正式发布。换句话说,这些亮眼的性能声明还有待实际验证。
对于开发者和研究者而言,真正的检验要等到权重开放之后。届时社区可以在各类基准测试和真实任务中评估它是否真的达到了Mistral所宣称的前沿水平。无论结果如何,一个来自欧洲、体量达万亿参数的开源模型即将进入公众视野,这本身就足以让整个开源社区保持关注。
相关推荐

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。

NeurIPS SAC门票不可转让引讨论:政策变动惹争议
NeurIPS SAC 门票是否仍可转让引发 Reddit 机器学习社区热议。本文梳理政策变动争议、收紧背后的可能原因及对参会者的实用建议,帮助研究者正确应对顶会票务管理变化。