MLX框架新增Flint模型支持:v0.40.8更新解析

MLX v0.40.8 为 Flint 模型增加原生支持,优化序列化、量化导入与注意力机制。
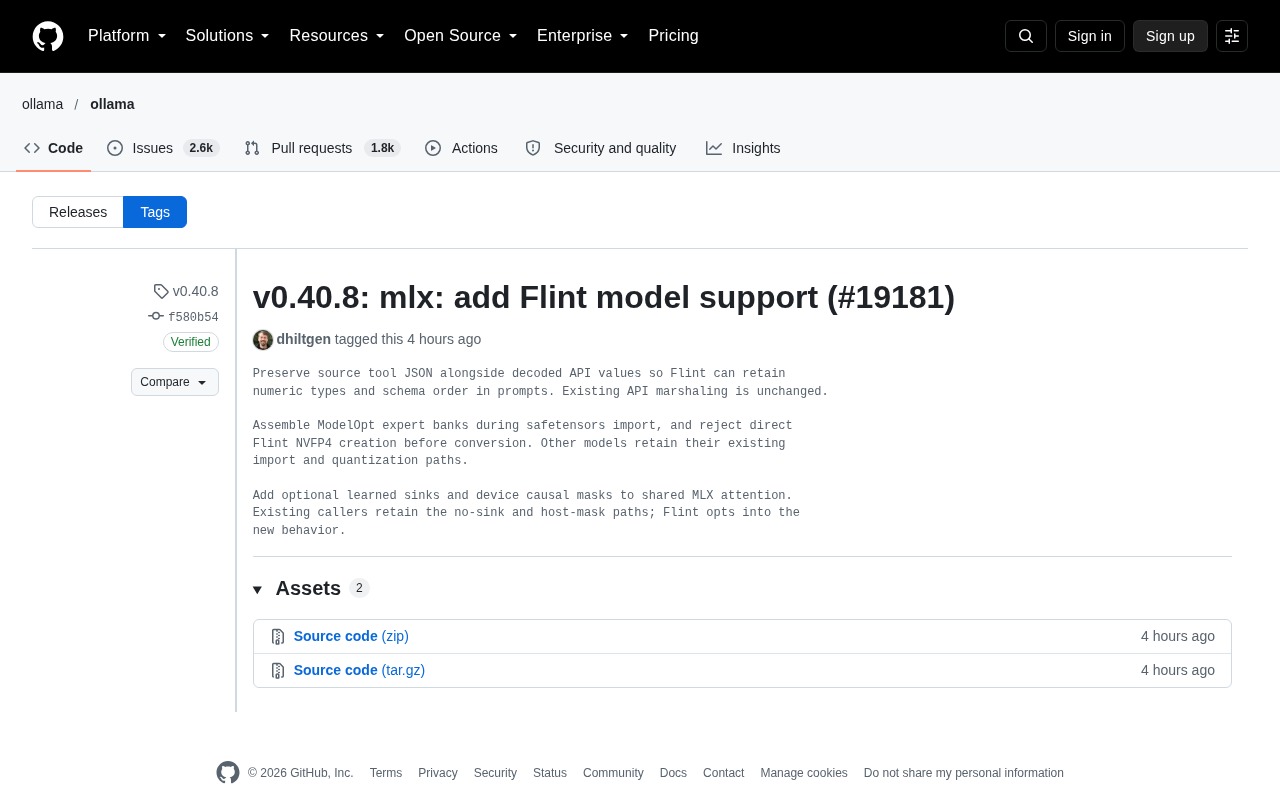
MLX 框架 v0.40.8 通过 PR #19181 为 Flint 模型增加原生支持,改动集中在三个层面:保留源工具返回的原始 JSON,使 Flint 在提示词中维持数值类型和 schema 顺序;在 safetensors 导入时组装 ModelOpt 专家库,并禁止在转换前直接创建 Flint NVFP4 权重;共享 MLX 注意力实现新增可选的 learned sinks 和 device causal masks,仅 Flint 显式启用,其他调用方保持旧路径。这些改动体现了“结构化输入保真”和“量化推理效率”两条主线,现有 API 行为保持不变,隔离性较好。但提交信息未披露 Flint 模型的具体参数与基准数据,实际推理表现仍需开发者自行验证。
一次面向推理优化的框架级更新
MLX 框架的 v0.40.8 版本合并了编号 #19181 的 PR,核心变更是为 Flint 模型增加了原生支持。从提交说明看,这次更新并非简单的模型列表扩充,而是在数据序列化、量化权重导入和注意力机制三个层面做了针对性适配。对于关注端侧推理和模型部署的开发者来说,这些改动值得细看。
保留源工具 JSON:Flint 的类型与顺序诉求
第一个改动围绕提示词的构造展开。更新后,框架会在解码后的 API 值之外,同时保留源工具返回的原始 JSON。这样做的目的是让 Flint 在提示词中能够保留数值类型和 schema 顺序。
这个细节看似琐碎,实际影响不小。在工具调用场景中,参数类型(如整数与浮点、字符串与布尔)以及键的排列顺序,往往会被模型当作结构化信号来理解。如果框架在序列化过程中把数值统一转成字符串或改变了字段顺序,模型对工具 schema 的解读就可能出现偏差。此次改动明确了现有 API 的序列化行为保持不变,意味着其他模型不会受到这一调整的影响,属于隔离性较好的兼容性设计。
ModelOpt 专家库与 NVFP4 量化路径
第二个改动涉及权重导入环节。在 safetensors 导入过程中,框架会组装 ModelOpt 专家库(expert banks),同时在转换之前拒绝直接创建 Flint NVFP4。
这里的关键词是 NVFP4——一种 4 位浮点量化格式。从提交描述可以推断,Flint 的 NVFP4 权重需要经过特定的转换流程,而不能在导入阶段直接以目标格式实例化。这种“先组装、后转换”的顺序约束,通常是为了保证量化参数在转换时已经完整可用。提交同时说明,其他模型保留原有的导入与量化路径,说明这是一条为 Flint 单独铺设的分支逻辑。
ModelOpt 是 NVIDIA 推出的模型优化工具库,提供量化、剪枝、蒸馏等训练后优化能力。在混合专家(MoE)模型或某些量化架构中,"专家库"(expert banks)指按专家索引组织的权重集合;导入时需要先按模型结构组装这些专家权重,再执行后续量化转换。NVFP4 则是一种 4 位浮点格式,利用极低精度压缩权重、降低显存占用并提升吞吐,但通常需要特定的缩放因子与校准流程。因此框架选择"先组装专家库、再执行 NVFP4 转换",避免在数据不完整时直接实例化目标格式导致精度损失或转换失败。
注意力机制:可学习 sink 与设备因果掩码
第三个改动落在共享的 MLX 注意力实现上:新增可选的 learned sinks 和 device causal masks。
Learned sinks 指的是注意力机制中可学习的“汇聚点”,让部分注意力权重有专门的落脚位置,这在长上下文场景中被用来稳定注意力分布。Device causal masks 则是把因果掩码放到设备侧计算,减少主机与设备之间的数据传输。提交说明现有调用方仍然走无 sink、主机掩码的旧路径,只有 Flint 显式启用新行为。这种 opt-in 的设计降低了回归风险,也说明新特性目前主要服务于 Flint 的推理需求。
Learned sinks 源于对注意力机制中"注意力汇"现象的研究:序列开头若干 token 会异常吸收大量注意力权重。可学习 sink 在注意力计算中引入额外的可训练汇聚位置,使模型能显式地将多余注意力导向这些位置,从而在长上下文中稳定注意力分布、缓解数值异常。Device causal masks 指将因果掩码(确保每个位置只能关注自身及之前位置的三角矩阵)直接生成在设备(GPU)侧,而非在主机内存中构建后再传输。这能减少主机与设备间的数据搬运开销,对长序列推理尤其有利。两者均以可选参数形式加入共享注意力实现,保持向后兼容。
更新背后的信号
把三处改动放在一起看,v0.40.8 对 Flint 的支持集中在“结构化输入保真”和“量化推理效率”两条线上。前者解决的是提示词层面的类型与顺序问题,后者涉及专家库组装、NVFP4 转换顺序以及注意力计算的设备侧优化。
对于使用 MLX 做本地推理的开发者,这次更新的直接价值在于 Flint 模型可以更顺畅地接入现有管线;间接价值则在于注意力层新增的可选能力,未来可能被更多模型复用。需要注意的是,提交信息没有披露 Flint 模型的来源、参数量或基准测试数据,实际推理表现仍需开发者自行验证。
相关推荐

zCAD AI:用自然语言生成可编辑参数化3D零件
zCAD AI 在 Product Hunt 登顶,主打用自然语言生成可编辑的参数化 3D 零件与装配体,支持浏览器 CAD 编辑与 STEP 导出,本文拆解其能力边界与适用场景。

AI代码文档不只枯燥文字:可视化交互式文档的实践
AI生成代码越来越普遍,传统静态文档难以跟上节奏。本文介绍可视化、动态、交互式文档的实践思路,包括与Linear、Jira集成及交互式PR审查,帮助工程师持续理解AI构建的代码。

myPip:用AI氛围编程打造可变现游戏
myPip是一款AI游戏创作工具,支持通过自然语言描述生成可玩游戏,并集成内购、广告等变现方式。本文介绍其功能、适用场景及面临的挑战。