MNN-Pocket-0.3B技术报告:173MB端侧模型实现466 tokens/s推理

阿里MNN团队开源300M参数端侧模型,INT4仅173MB,iPad Pro M5上解码达466 tokens/s。
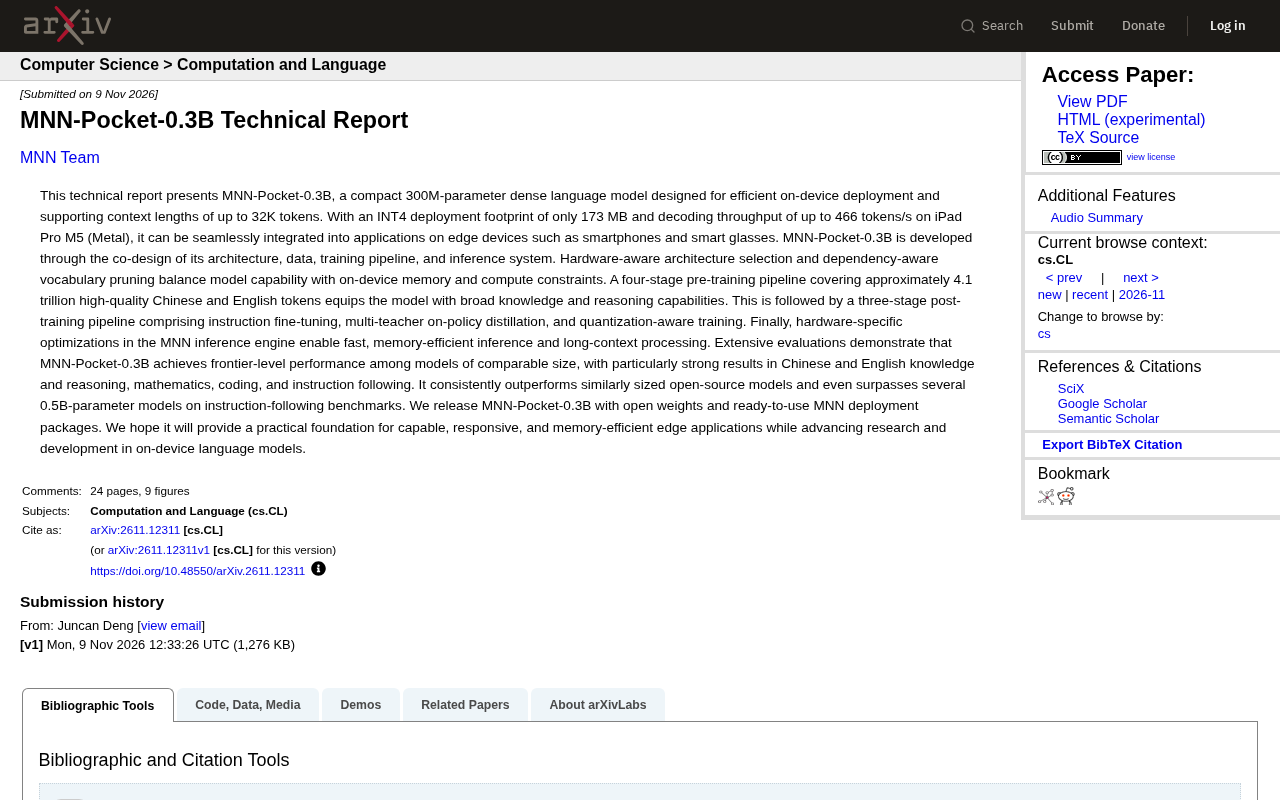
阿里MNN团队发布MNN-Pocket-0.3B技术报告,展示了一条完整的端侧大模型工程路径。该模型为300M参数稠密语言模型,经INT4量化后部署体积仅173MB,支持最长32K tokens上下文,在iPad Pro M5的Metal后端上解码吞吐最高达466 tokens/s。方法论上强调架构、数据、训练流程与推理系统的协同设计,包括硬件感知选型与依赖感知词表剪枝;预训练覆盖约4.1万亿中英文token,后训练含指令微调、多教师在线策略蒸馏和量化感知训练三阶段。评测称其在中英文知识推理、数学、编程和指令跟随上达到同尺寸前沿水平,指令跟随基准甚至超过部分0.5B模型,权重与MNN部署包均已开源。
端侧部署大模型的最大障碍始终是内存和算力。阿里MNN团队发布的MNN-Pocket-0.3B技术报告给出了一个颇具参考价值的解题思路:用300M参数的稠密模型,在INT4量化下把部署体积压到173MB,在iPad Pro M5(Metal)上实现最高466 tokens/s的解码吞吐,同时支持最长32K tokens的上下文。模型权重和MNN部署包均已开源。
架构与数据的协同设计
MNN-Pocket-0.3B的核心方法论是架构、数据、训练流程和推理系统的协同设计(co-design),而不是先训模型再想办法塞进设备。
在架构层面,团队采用了硬件感知(hardware-aware)的选型策略,根据目标设备的实际内存和计算约束反推模型结构。其中一个值得关注的技术点是依赖感知的词表剪枝(dependency-aware vocabulary pruning)——词表大小直接决定嵌入层和输出层的参数量,对端侧模型的影响尤为显著,剪枝时兼顾token之间的依赖关系,在压缩体积的同时尽量保住模型能力。
这种"从部署约束倒推模型设计"的思路,与云端模型"先做大再蒸馏"的路径形成鲜明对比,也更贴近端侧场景的真实需求。
依赖感知词表剪枝的核心思路是:在多语言或大词表模型中,嵌入层和输出层的参数量与词表大小成正比,而这两层在3亿参数模型里可能占据相当比例。剪枝时如果简单按词频删除低频词,容易破坏语义关联紧密的token簇(例如数字、标点、子词片段之间的组合依赖)。依赖感知方法会先统计token在语料中的共现与替换关系,把强依赖的token作为整体保留或裁剪,再重新映射词表索引,从而在压缩嵌入矩阵的同时减少对下游任务的影响。对端侧模型而言,词表从十万级降到数万级往往能直接省下数十MB权重,是性价比很高的压缩手段。
四阶段预训练:4.1万亿token
预训练方面,MNN-Pocket-0.3B经历了一个四阶段流程,覆盖约4.1万亿高质量中英文token。对于300M参数级别的模型来说,这个数据规模相当可观——小模型配合大数据量训练,是当前提升小模型能力的主流做法。
报告称该模型由此获得了广泛的知识和推理能力。从后续评测结果看,中英文知识与推理确实是其相对突出的方向,这与预训练数据的配比设计应当直接相关。
三阶段后训练与量化感知
预训练之后是三阶段后训练管线:
- 指令微调:对齐指令跟随能力,这是端侧助手类应用的基础。
- 多教师在线策略蒸馏(multi-teacher on-policy distillation):用多个更强的教师模型指导学生模型,且采用on-policy方式,让学生在自己生成的轨迹上接受纠正,通常比离线蒸馏更有效。
- 量化感知训练(QAT):直接为INT4部署做准备。173MB的INT4部署体积能够落地,QAT这一步不可或缺。
说个细节,量化不是部署前的补救措施,而是被纳入训练管线的正式环节,这种"训练时就考虑量化"的做法正在成为端侧模型的标准配置。
多教师在线策略蒸馏与传统的离线蒸馏差异在于数据来源:离线蒸馏通常用教师模型在固定数据集上生成的答案作为监督信号,学生只是模仿;在线策略蒸馏则让学生模型先对提示生成自己的回复,再由多个教师模型对这些“学生轨迹”逐token给出概率分布或偏好修正,学生因此能纠正自己实际会犯的错误,而不是只学习教师理想状态下的输出。多教师并行还能融合不同教师在不同能力维度(如数学、代码、对话)上的优势,缓解单一教师偏好被放大的问题。代价是需要在线调用教师模型,训练基础设施和成本明显更高。
推理引擎的硬件级优化
模型侧的工作之外,MNN推理引擎针对具体硬件做了优化,实现快速、省内存的推理和长上下文处理。466 tokens/s的解码速度是在iPad Pro M5的Metal后端上测得的具体数字,说明这套优化并非泛泛而谈。
32K上下文与173MB部署体积的组合,意味着在智能眼镜、手机等内存受限设备上也能承载长文档处理、多轮对话等场景。报告明确将智能手机和智能眼镜列为目标设备。
**量化感知训练(QAT)**与训练后量化(PTQ)的关键区别,是QAT在训练前向传播中模拟INT4的舍入和截断误差,让权重在更新时就适应低精度表示;反向传播通常用直通估计器(STE)绕过不可导的量化算子。相比PTQ直接对训练好的权重做量化,QAT能显著降低4bit下的精度损失,尤其对3亿参数这种容量本就紧张的小模型更为重要。代价是训练流程更复杂,需要校准量化范围、处理异常值,并与蒸馏阶段联合调度,这也是端侧模型把量化纳入正式训练管线的原因。
评测表现:小模型中的前沿水平
报告称MNN-Pocket-0.3B在同尺寸模型中达到前沿水平,在中英文知识与推理、数学、编程和指令跟随方面表现尤其突出。它稳定优于同规模开源模型,在指令跟随基准上甚至超过了一些0.5B参数模型。
参数更小却表现更好,背后是协同设计带来的效率优势——同等能力下更少的参数,意味着更小的内存占用和更快的推理速度,这正是端侧场景最看重的 trade-off。
开源与部署
团队以开放权重形式发布了MNN-Pocket-0.3B,并提供开箱即用的MNN部署包。对应用开发者而言,这意味着可以直接在端侧集成,无需自行完成模型转换和量化流程。
从技术报告披露的信息看,这款模型的价值不在于刷新某个榜单,而在于展示了一条完整的端侧大模型工程路径:硬件感知设计、大规模小模型训练、蒸馏与量化感知后训练、推理引擎优化,四个环节环环相扣。对于希望把语言模型塞进手机或智能眼镜的团队,这份报告本身可能比模型权重更有参考意义。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。