模型指纹闹剧:DeepSeek蒸馏GPT的谣言与开源反击

模型指纹工具库不全导致“蒸馏”误判,DeepSeek以全面开源推理框架回应质疑。
文章从一则“DeepSeek蒸馏闭源模型”的帖文切入,复盘了模型指纹测试的全过程:同一模型在不同测试中被判为不同闭源模型,先发布的DeepSeek R1被鉴定为晚发布9个月的Claude模型,甚至随机数生成器也被“鉴定”出蒸馏了GPT和Claude。作者查看工具GitHub仓库后发现,其内置指纹库仅有GPT和Claude两家,导致任何输入都只能在两者间二选一,测试结论因此失去说服力。与此同时,DeepSeek宣布开源内部推理框架DeepInfer和生产级token编解码组件DeepSeek Recipe,兼容英伟达与华为昇腾,单集群日吞吐达155万亿token。文章认为,指纹测试并非严谨的“亲子鉴定”,而开源工程细节才是回应蒸馏质疑的底气。
最近,AI社区里流传着一个颇具戏剧性的说法:开源模型DeepSeek竟然“蒸馏”了闭源模型,甚至出现了“先发布的模型蒸馏后发布的模型”这种时空错乱般的指控。这场风波从一个模型指纹测试开始,最终却演变成对测试工具本身的质疑,以及DeepSeek用全面开源做出的回应。
模型指纹测试引发的“蒸馏”疑云
事情的起点是一则帖子。在DeepSeek广告 V4.1 Flash 1017发布后不久,有人晒出了对该模型的指纹测试结果,称其被识别为GPT-65 AllStar的概率高达90.71%。这个数字足以让人浮想联翩:难道DeepSeek真的蒸馏了GPT?
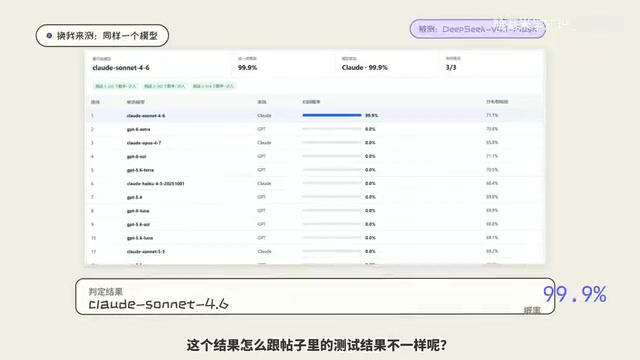
为了验证,视频作者使用帖子中提到的模型指纹工具Model Trace进行了测试。结果却出人意料——DeepSeek V4.1 Flash 1070被测出是Claude Sonnet 4.6的概率为99.9%。同一个模型,在不同测试中指向了不同的闭源模型,这本身就与帖子中的结论矛盾。
模型蒸馏是知识蒸馏(Knowledge Distillation)的简称,指用一个已训练好的“教师模型”的输出(如概率分布、中间特征或生成文本)来训练另一个“学生模型”,使学生模型以更小的参数量或更低的成本逼近教师模型的能力。因此,“某模型蒸馏了某闭源模型”的指控,核心在于怀疑其训练数据或监督信号来自另一个模型。判断是否发生蒸馏通常需要训练数据溯源、输出分布比对等证据,仅凭输出风格相似或单一指纹测试很难成立。
穿越时空的指纹:当工具只认识两家模型
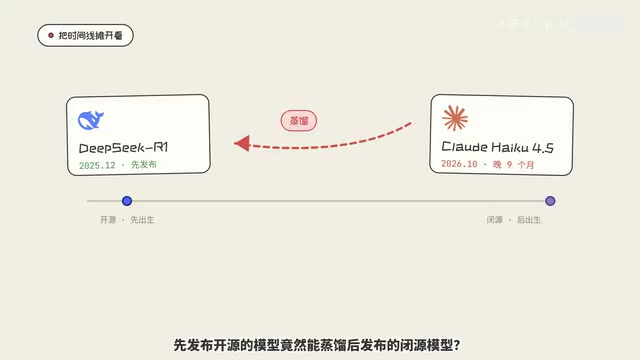
作者随后换用硅基流动上的DeepSeek R1进行测试,结果更加离谱:DeepSeek R1被鉴定为晚发布9个月的Claude Haiku 45 2025 1001,概率达到100%。一个先发布的开源模型,竟然“蒸馏”了后发布的闭源模型,这显然违背基本的时间逻辑。
更荒诞的还在后面。在原帖评论区,有人用Python随机数生成器竟然也成功“鉴定”出随机数蒸馏了Claude Sonnet 5.5和GPT-5 4。这时作者意识到,所有测试结果都只指向GPT和Claude两家。打开该工具的GitHub仓库后,真相浮出水面:这个工具的内置指纹库竟然只有GPT和Claude这两个模型的指纹。
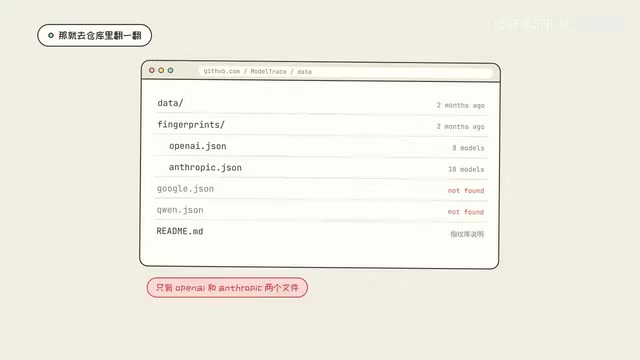
换句话说,无论输入什么模型,工具都只能从这两个选项里“猜”一个答案。所谓90.71%或99.9%的概率,更多反映的是工具内置库的局限性,而非模型之间的真实关系。用这样的工具去指控蒸馏,显然缺乏说服力。
模型指纹(Model Fingerprinting) 是一类通过分析模型输出的统计特征(如特定提示下的回答风格、词频分布、困惑度模式等)来推测模型身份或来源的技术。其基本假设是不同模型在训练数据、对齐策略和解码方式上会留下可区分的“痕迹”。但指纹测试本质上是一种封闭集分类:工具只能在其内置的候选模型库中给出最相似项,无法证明“不在库中”或“确实同源”。当候选库不完整时,任何输入都会被强制归入已有类别,产生高置信度却无意义的判定,这正是本次风波中随机数也被“鉴定”为蒸馏闭源模型的根源。
DeepSeek的开源回应:推理框架与生产级组件
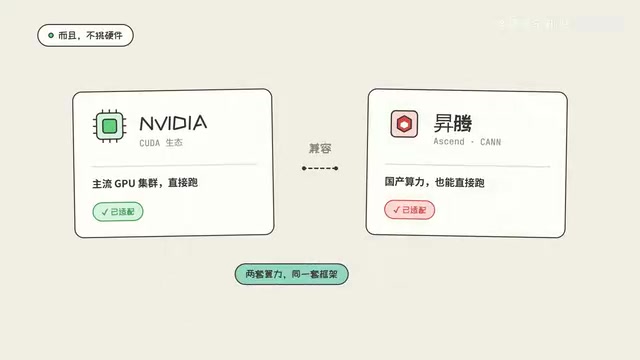
就在社区为蒸馏争论不休时,DeepSeek宣布全面开源自己的内部推理框架DeepInfer,同步开源的还有生产级token编解码组件DeepSeek Recipe。根据视频中的信息,DeepInfer兼容英伟达和华为昇腾两大平台,单集群日吞吐量能达到155万亿token,每张GPU每小时能收入38美元。
同样的算力,它能跑更多请求、花更少钱、耗更少电。DeepSeek把模型如何构建、如何部署、如何省钱的全过程都公开了。这种“把底牌亮出来”的做法,与某些闭源模型“绞尽脑汁把自己藏得严严实实”形成了鲜明对比。
推理框架是介于训练完成的模型与实际服务之间的工程层,负责模型加载、请求调度、批处理(batching)、KV Cache 管理、量化与算子优化等,直接决定单位算力的吞吐量和推理成本。DeepInfer 这类自研框架的价值在于针对特定硬件(如英伟达 GPU 与华为昇腾 NPU)做深度调优,从而在相同集群上服务更多请求、降低每 token 成本。Token 编解码组件则负责文本与 token 序列之间的双向转换,需与模型词表严格对齐,是推理服务链路中容易被忽视但影响兼容性与正确性的基础环节。
指纹测试的边界与开源的底气
这场风波揭示了一个容易被忽视的问题:模型指纹测试并非严谨的“亲子鉴定”。如果工具的内置指纹库不完整,或者测试方法存在偏差,结果就可能产生严重误导。用随机数都能“蒸馏”出闭源模型,恰恰说明这类测试在缺乏透明方法时多么脆弱。
另一方面,DeepSeek选择用开源推理框架来回应质疑,本身就是一种态度。当技术细节、部署方案和成本结构都公开可查时,“蒸馏”的指控自然失去立足之地。开源不是口号,而是把工程实践摊在阳光下,让社区自行判断。
对于关注AI行业的人来说,这起事件提醒我们:面对“模型蒸馏”这类敏感指控,先看看测试工具本身是否可靠,再下结论也不迟。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。