MudawanSn:填补沃洛夫语-阿拉伯语机器翻译的空白语料库
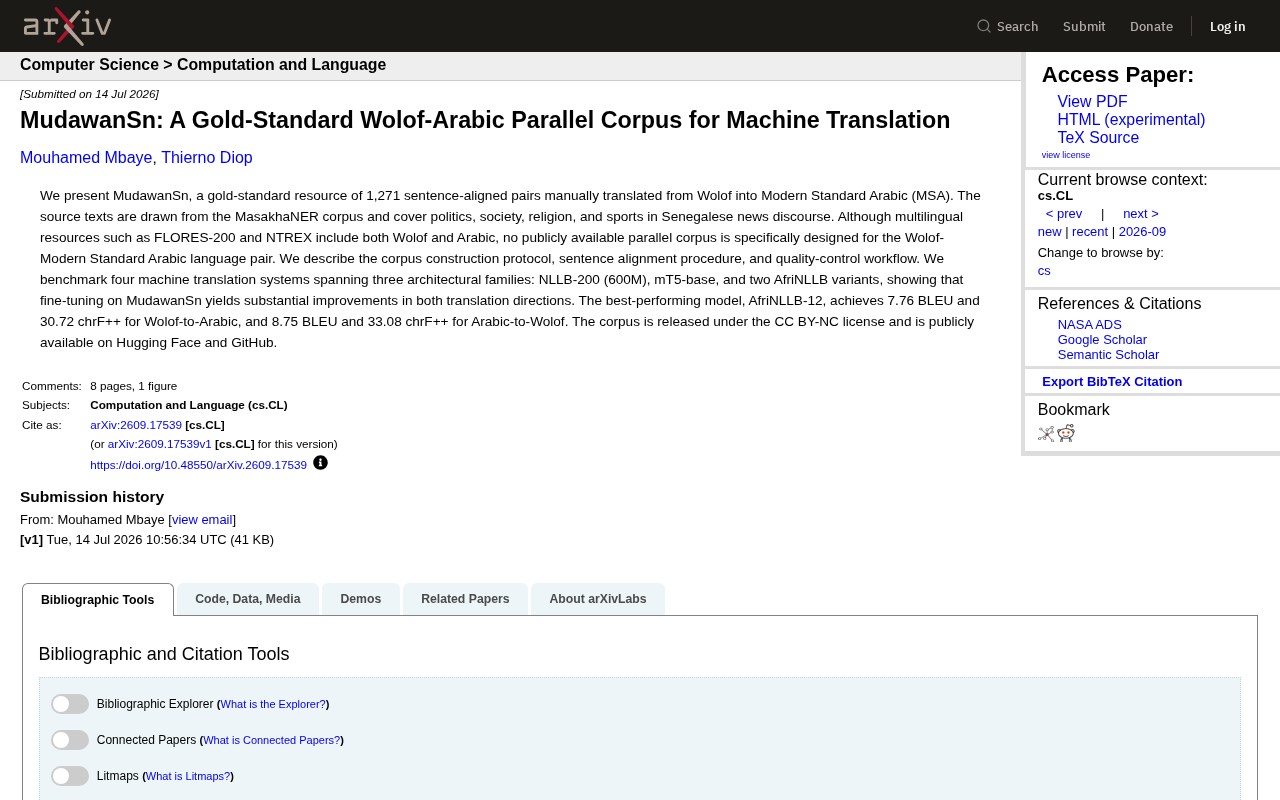
MudawanSn:首个沃洛夫语与现代标准阿拉伯语黄金标准平行语料库,填补低资源语言翻译空白。
MudawanSn 是首个专门面向沃洛夫语与现代标准阿拉伯语的人工翻译平行语料库,包含1,271对经过句子对齐的高质量译文,源文本取自覆盖塞内加尔政治、社会、宗教与体育话题的MasakhaNER新闻语料。研究团队在NLLB-200、mT5-base及两个AfriNLLB变体上开展基准测试,结果表明用该语料库微调后翻译质量显著提升,针对非洲语言优化的AfriNLLB-12表现最佳,两个方向的chrF++分数均超过30。该语料库以CC BY-NC许可证发布于Hugging Face与GitHub,为一个此前完全缺乏专用资源的语言对建立了可复现的评测基线,对推动AI语言技术的公平覆盖具有重要意义。
一个被忽视的语言对
机器翻译研究长期聚焦于英语、汉语、法语等高资源语言,而非洲本土语言与阿拉伯语之间的翻译能力却严重欠缺。沃洛夫语(Wolof)是塞内加尔及周边地区数百万人使用的主要语言,而现代标准阿拉伯语(MSA)在西非穆斯林社群中同样具有重要的宗教与文化地位。这两种语言之间的直接翻译需求真实存在,但相关资源却几乎是一片空白。
尽管 FLORES-200、NTREX 等多语言基准同时收录了沃洛夫语和阿拉伯语,却没有任何一个公开的平行语料库专门针对「沃洛夫语—现代标准阿拉伯语」这一语言对进行设计。MudawanSn 正是为填补这一缺口而诞生的成果。
语料库的构建与规模
MudawanSn 提供了 1,271 对经过句子对齐的黄金标准平行语料,全部由人工从沃洛夫语翻译为现代标准阿拉伯语。这些源文本取自 MasakhaNER 语料库,内容覆盖塞内加尔新闻话语中的政治、社会、宗教和体育等主题,具有较强的真实语境代表性。
研究团队详细披露了语料库的构建协议、句子对齐流程以及质量控制工作流。「黄金标准」(gold-standard)意味着这些译文经过人工翻译与校验,而非机器生成或众包低质数据,这对于低资源语言的评测基准尤为关键——在数据稀缺的场景下,数据质量比数量更能决定模型微调的效果。
值得关注的是,1,271 对句子对于训练大型模型来说规模有限,但作为微调数据集和评测基准,其价值在于精确性与领域覆盖,而非绝对体量。
MasakhaNER 是专为非洲语言命名实体识别任务构建的多语言标注语料库,覆盖10余种非洲语言(包括沃洛夫语),文本来源均为各语言的本地新闻网站。选用 MasakhaNER 作为源文本的优势在于:其新闻体裁确保了句子的自然流畅性与话题多样性,且已有社区维护的质量保障,适合作为平行语料的起点。句子对齐(sentence alignment)则是平行语料库构建中的关键步骤,指在源语言与目标语言文本之间建立精确的句级对应关系,确保每一条源句恰好对应其译文,避免段落漂移或多句合并带来的训练噪声。
四个模型的基准测试
研究团队在三类架构家族上对四个机器翻译系统进行了基准测试,分别是 NLLB-200(600M 参数)、mT5-base,以及两个 AfriNLLB 变体。测试结果显示,在 MudawanSn 上进行微调能够在两个翻译方向上都带来显著提升。
表现最佳的模型 AfriNLLB-12 在沃洛夫语到阿拉伯语方向取得了 7.76 的 BLEU 分数和 30.72 的 chrF++ 分数;在阿拉伯语到沃洛夫语方向则达到 8.75 BLEU 和 33.08 chrF++。
从绝对数值看,这些 BLEU 分数仍然偏低,反映出低资源语言对翻译任务的固有难度——缺乏训练数据、语言形态差异大、缺少充分的预训练覆盖,都会拖累模型表现。不过 chrF++ 分数明显高于 BLEU,说明模型在字符级别的匹配上表现相对更好,这在形态丰富的语言翻译评测中是常见现象。针对非洲语言优化的 AfriNLLB 变体优于通用的 NLLB-200 和 mT5,也印证了区域化预训练的价值。
BLEU(Bilingual Evaluation Understudy)是机器翻译领域最广泛使用的自动评估指标,通过计算机器译文与参考译文之间的n-gram重合度来衡量翻译质量,分数范围为0到100,越高越好。chrF++则是基于字符级n-gram的改进指标,在处理形态丰富语言(如阿拉伯语的词形变化体系和沃洛夫语的前缀/后缀黏着构词)时更为鲁棒——因为字符级匹配对词形变体更宽容,不会因为一个词的词缀变化就完全失配。NLLB-200(No Language Left Behind)是Meta于2022年发布的多语言翻译模型,覆盖200种语言;AfriNLLB则是在此基础上针对非洲语言进一步优化预训练的衍生版本;mT5是Google发布的多语言文本到文本预训练模型。三者代表了从通用大模型到区域专项模型的不同路线,本研究的对比结果为"领域专化预训练"策略提供了实证支持。
开放许可与研究意义
MudawanSn 以 CC BY-NC 许可证发布,并已公开托管于 Hugging Face 和 GitHub,方便研究社区直接使用与复现。非商业许可意味着它可以自由用于学术研究,但商业应用需另行授权。
对于致力于语言多样性与技术公平的研究者而言,这类资源的意义超出了单纯的性能数字。它为一个此前完全没有专用平行语料的语言对建立了可复现的评测起点,也提供了一套可借鉴的构建方法论。未来无论是扩大语料规模、引入更多领域,还是探索更适合的模型架构,MudawanSn 都提供了一个坚实的基线。
低资源语言的机器翻译研究,本质上是在缩小全球数字鸿沟。MudawanSn 这样的工作,正是让 AI 技术惠及更多语言社群的必要一步。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。