MuscleMemory:为AI智能体打造的开源程序性记忆

MuscleMemory 将程序性记忆引入 AI 智能体,让 Agent 记住任务操作流程而非对话内容。
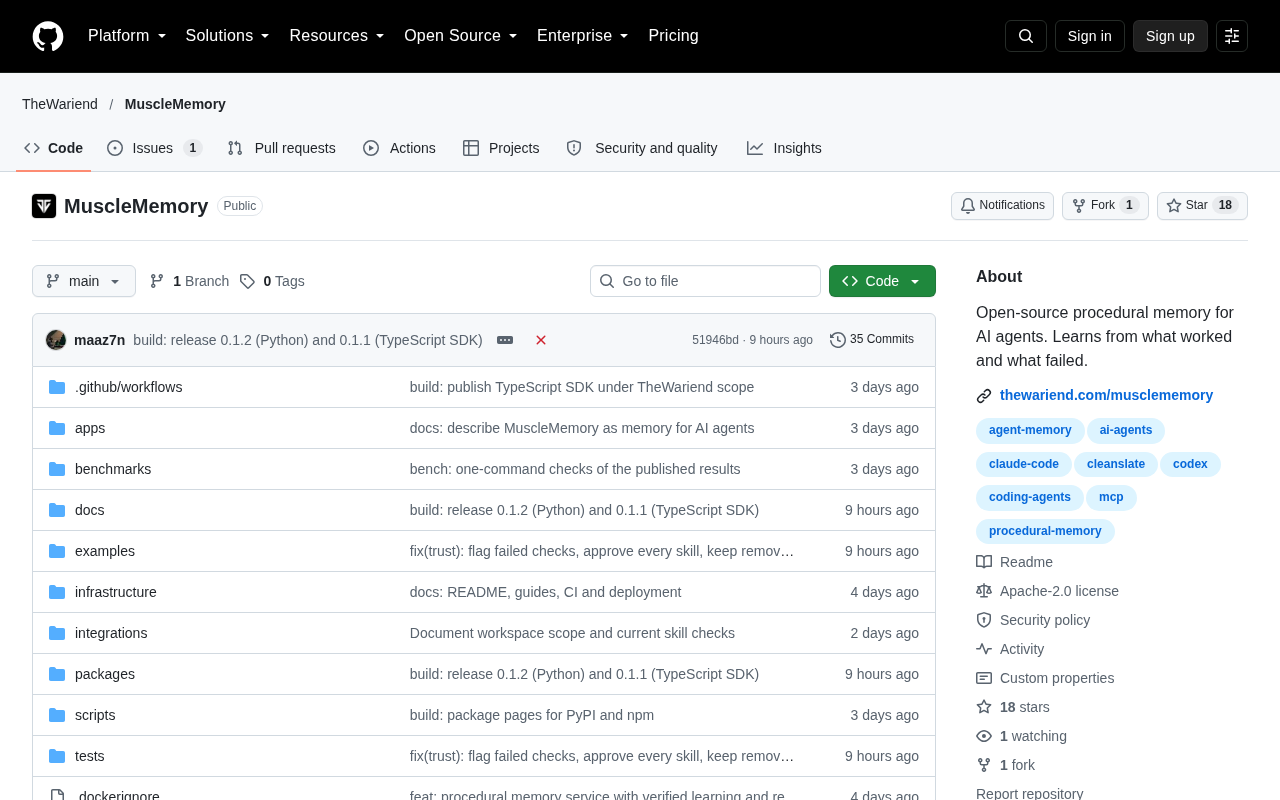
MuscleMemory 是一个处于极早期阶段的开源项目,它从认知科学中借来「程序性记忆」概念,试图让 AI 智能体记住完成某类任务的操作流程,而非仅仅记住对话内容或事实知识。当前主流 Agent 框架每一步推理都从零开始,导致效率浪费和稳定性不足,程序性记忆正是针对这一痛点的解决方案。其核心技术难点在于任务相似度度量、记忆的泛化与特化平衡以及失败记忆的处理。与 MemGPT、Mem0 等聚焦语义记忆的框架形成互补,MuscleMemory 把「技能」作为一等公民对待,对长期运行的自动化 Agent 具有潜在价值。但项目在 HN 上仅获 7 分 0 评论,暂不宜在生产环境中依赖。
什么是 MuscleMemory
AI 智能体(AI Agent)领域正在经历一场记忆机制的细分革命。过去,我们谈论 AI 记忆时,通常指的是向量数据库支撑的「语义记忆」——把对话历史和知识片段嵌入后检索。但 Hacker News 上冒出的一个开源项目 MuscleMemory,把焦点转向了另一个维度:程序性记忆(procedural memory)。
程序性记忆的概念借自认知科学。人类的记忆并非只有「记得什么事实」,还包括「记得怎么做一件事」——骑车、打字、系鞋带,这些技能一旦学会就内化为自动化的动作序列。MuscleMemory 试图为 AI 智能体赋予类似的机制:不是记住对话内容,而是记住完成某类任务的操作流程。
程序性记忆与语义记忆、情景记忆的区别
认知科学通常将长时记忆分为三类:语义记忆(semantic memory)存储一般性事实与概念,如「巴黎是法国首都」;情景记忆(episodic memory)存储个人经历的具体事件,如「我昨天在咖啡馆见了朋友」;程序性记忆(procedural memory)则存储技能与操作流程,如骑车、游泳、打字。三者的关键差异在于意识参与程度:语义和情景记忆可以被有意识地回忆和陈述,而程序性记忆往往是内隐的、自动化的,难以用语言完整描述。
映射到 AI 智能体领域,语义记忆对应向量数据库中的知识检索,情景记忆对应对话历史与任务日志,而程序性记忆则对应可复用的任务执行策略或操作序列。当前大多数 Agent 框架只实现了前两者,程序性记忆仍是一片待开垦的领域。MuscleMemory 正是试图填补这一空白,让 Agent 不仅「记得什么」,还能「记得怎么做」。
为什么 AI 智能体需要程序性记忆
当下主流 AI Agent 框架(如 LangChain、AutoGPT 等)在执行多步任务时,每一步推理都从「零」开始。即便同一个 Agent 昨天刚成功完成过一次「部署 Flask 应用到服务器」的流程,今天再遇到类似任务,它依然需要重新规划每一步。
这带来两个问题:
- 效率浪费:重复的规划开销消耗 token 和时间
- 稳定性不足:每次重新规划都可能走不同的路径,有时成功有时失败
MuscleMemory 的思路是,当一个 Agent 成功完成某个任务后,将整个操作序列「固化」为一条可复用的程序性记忆。下次遇到同类任务,直接调用这条记忆,跳过从零规划的过程。
这与「few-shot 示例」有本质区别。Few-shot 示例是静态的、人工编写的;而 MuscleMemory 强调从执行中自动积累,记忆本身会随着 Agent 的运行不断增长和修正。
Few-shot 示例与程序性记忆的本质区别
Few-shot 示例(few-shot examples)是提示工程中的常用技术:在提示词中提供几个输入-输出对,引导模型模仿示例的格式和逻辑完成任务。其核心局限在于静态性和人工依赖——示例由开发者预先编写,无法随 Agent 运行自动更新,且数量受上下文窗口限制。
程序性记忆则强调从执行中自动积累。Agent 每成功完成一次任务,就将操作序列固化为可检索的记忆单元,下次遇到同类任务时直接调用。这种机制的优势在于:记忆库随使用不断增长,覆盖的任务类型越来越广;成功的流程被保留,失败的路径被淘汰,形成一种经验驱动的优化循环。简言之,Few-shot 是「别人教你怎么做」,程序性记忆是「自己学会怎么做」。
技术路线的推测与关键设计问题
由于该项目在 Hacker News 上仅有 7 个积分、0 条评论,公开信息极为有限,我们只能基于项目定位和领域常识来推断其可能的技术路线。
一条合理的路径是:Agent 在任务完成后,将成功的动作序列(包括工具调用参数、中间状态、条件分支)序列化为结构化数据,存储在一个可检索的记忆库中。下一次任务开始时,先做一次「任务相似度匹配」,如果命中高置信度的程序性记忆,就直接执行或以此为模板微调。
这条路线的核心难点在于:
- 任务相似度如何度量——表面不同的任务可能共享底层流程,表面相似的任务可能需要完全不同的处理
- 记忆的泛化与特化平衡——记忆太具体则无法复用,太抽象则失去指导价值
- 失败记忆的处理——只记住成功的流程可能不够,失败的教训同样有价值
这些问题的答案,可能要等到项目文档和社区讨论进一步丰富后才能揭晓。
与现有记忆框架的差异
目前 AI 记忆领域最活跃的方向是语义记忆和情景记忆。语义记忆解决「知道什么」,情景记忆解决「经历过什么」,而程序性记忆解决「会做什么」。三者构成了一个更完整的认知架构。
MemGPT、Mem0 等项目已经在这个方向上做了大量探索,但它们的主要精力仍集中在对话上下文管理和事实检索上。MuscleMemory 的差异化在于,它把「技能」作为一等公民来对待——不是把技能藏在提示词模板里,而是作为独立的、可积累、可组合的记忆单元。
这个思路如果走通,对于需要长期运行的自动化 Agent(如运维机器人、客服 Agent、代码助手)会有实际价值:Agent 越用越熟练,而不是每次都在同一个起点上重新摸索。
MemGPT 与 Mem0 的记忆机制简介
MemGPT 是加州大学伯克利分校提出的一个框架,核心思路是将大语言模型类比为操作系统,通过分层的记忆管理(主上下文与外部存储之间的换页机制)来突破上下文窗口限制。它让 Agent 能够在对话过程中自主决定何时将信息写入长期存储、何时检索回来,从而实现跨会话的连贯记忆。
Mem0 则是一个面向生产环境的记忆层服务,为 AI 应用提供事实提取、存储和检索能力。它自动从对话中抽取用户偏好、关键事实等信息,构建个性化的知识库,使 Agent 在多轮交互中保持对用户的了解。
两者都聚焦于语义记忆和情景记忆的管理,而 MuscleMemory 关注的程序性记忆与它们形成互补关系——前者解决「知道什么」和「经历过什么」,后者解决「会做什么」,共同构成更完整的 Agent 认知架构。
开源项目的早期观察
在 Hacker News 上以 7 分、0 评论的状态出现,说明 MuscleMemory 还处于非常早期的阶段。对于关注 AI Agent 基础设施的开发者来说,这类项目值得保持关注,但暂时不宜在生产环境中依赖。
评估这类早期项目时,可以关注几个信号:项目是否提供了清晰的任务-记忆映射示例、是否有记忆冲突解决的机制设计、以及社区是否开始贡献真实场景下的使用案例。这些信号的成熟度,决定了程序性记忆能否从概念走向实用。
程序性记忆这个方向本身是成立的,问题只在于工程实现能否达到足够的鲁棒性。MuscleMemory 是一个值得标记的起点。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。