Muse Spark Open登陆vLLM:小模型的大故事
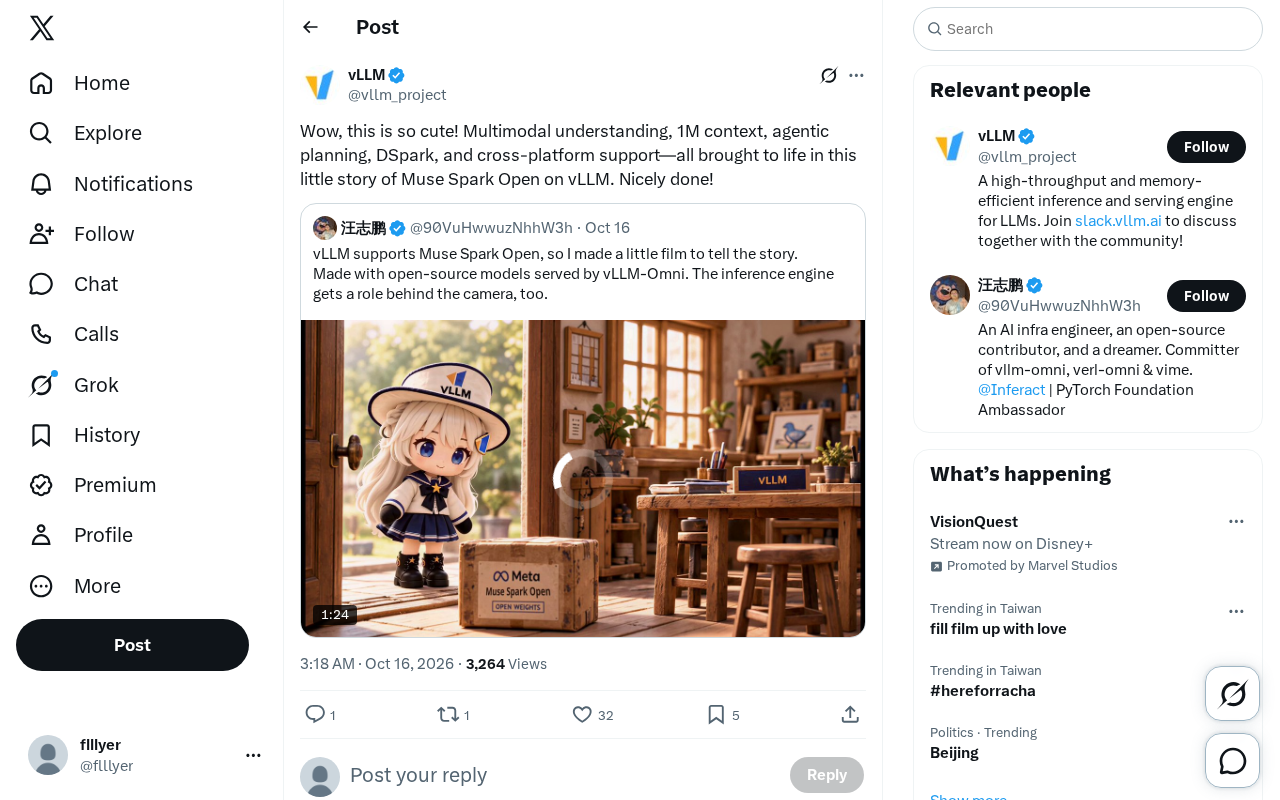
Muse Spark Open在vLLM上演示多模态、1M上下文与智能体规划等综合能力。
Muse Spark Open通过一个叙事化演示展示了多模态理解、1M上下文、智能体规划、DSpark和跨平台支持等能力,并以“on vLLM”强调其面向生产部署的定位。文章解读了vLLM集成对开发者的意义——可复用成熟的批处理、并行化和显存管理能力,降低接入成本。技术特性方面,多模态能力降低应用门槛,1M上下文结合agentic planning适合长文档处理与自动化工作流,DSpark推测与高效注意力或动态稀疏化有关,跨平台支持则影响社区采用率。文章同时指出,演示的传播效果不等于生产可靠性,实际吞吐、延迟和长上下文成本仍需评测验证。
一个小故事,五个技术亮点
最近在Twitter上,一个关于Muse Spark Open的演示引发了关注。作者用"小故事"的形式展示了这个模型的多项能力:多模态理解、1M上下文、智能体规划、DSpark以及跨平台支持。这种将技术特性融入叙事的方式,让原本枯燥的参数展示变得生动起来。
从原始推文来看,演示的核心在于"all brought to life"——这些能力不是孤立罗列,而是在一个连贯场景中协同工作。多模态理解让模型能处理文本之外的输入;1M上下文意味着它可以记住并利用超长对话历史;agentic planning则体现了模型自主拆解任务、规划步骤的能力;DSpark可能指向某种高效推理或稀疏注意力机制;跨平台支持则暗示了部署的灵活性。
vLLM集成意味着什么
演示特别提到"on vLLM",这一点值得展开。vLLM是目前最流行的高吞吐量推理引擎之一,以PagedAttention技术著称,能显著提升大模型服务的吞吐和内存效率。Muse Spark Open选择在vLLM上运行,说明它面向的是实际生产部署场景,而非仅仅停留在研究原型阶段。
对于开发者而言,这意味着可以以较低的成本将模型接入现有基于vLLM的服务栈,享受成熟的批处理、并行化和显存管理能力。同时,vLLM社区对多模态模型的支持也在逐步完善,Muse Spark Open的多模态能力能否在vLLM上充分发挥,是后续值得观察的点。
PagedAttention 的工作原理:传统推理引擎在为每个请求预分配 KV Cache 时,会因输入长度不确定而造成大量显存浪费。PagedAttention 借鉴操作系统虚拟内存分页的思想,将 KV Cache 切分为固定大小的块(block),按需分配、非连续存储,并用块表维护逻辑块到物理块的映射。这样一来,显存碎片大幅减少,多个请求还能共享相同的前缀块(如系统提示词),实现前缀缓存复用。vLLM 正是基于该技术,才能在相同硬件上支撑更高的并发请求数和更长的上下文。对于 1M 上下文这类极端场景,PagedAttention 的按需分配特性尤为关键,否则单个长请求就可能耗尽显存。
技术特性拆解
多模态理解
多模态理解是当前模型竞争的关键赛道。从演示的"cute"叙事风格推测,Muse Spark Open可能定位于轻量级、高交互性的应用场景,而非追求极致基准分数。这类模型的价值在于让多模态能力更易获取,降低应用开发门槛。
多模态理解的技术路径:当前主流做法是将视觉编码器(如 ViT)输出的图像特征,通过投影层或交叉注意力对齐到语言模型的嵌入空间,使文本 token 与图像 token 在同一序列中共同参与自注意力计算。这种“早期融合”方式让模型能进行跨模态推理,例如根据图片内容回答后续追问。与之相对的是“晚期融合”,即各模态独立编码后再拼接,交互能力较弱。多模态模型在推理引擎上的部署难点在于:图像 token 数量可变、预处理流水线独立于文本,需要引擎支持异构输入调度。这也是 vLLM 多模态支持仍在逐步完善的原因。
1M上下文与智能体规划
1M上下文窗口意味着模型可以一次性处理极长的输入,例如完整代码库、长篇文档或多轮复杂对话。结合agentic planning,模型能够在长上下文中保持任务目标的一致性和步骤的连贯性,这对于自动化工作流、复杂问题求解等场景尤为重要。
长上下文与智能体规划的耦合:智能体规划通常采用 ReAct、Plan-and-Execute 等范式,模型需要反复观察环境反馈、更新计划并执行下一步动作,整个轨迹可能包含数十轮交互和大量工具返回结果。若上下文窗口不足,早期目标和约束会被截断,导致规划漂移。1M 上下文使模型能在单次推理中保留完整的任务说明、历史动作和中间结果,从而维持长期一致性。但长上下文也带来“迷失在中间”(lost in the middle)问题——模型对序列中部信息的利用率下降,因此实际效果还取决于训练时的长文本数据配比和位置编码外推方案。
DSpark与跨平台支持
DSpark的具体含义在原始信息中未详细说明,从命名推测可能与动态稀疏化或高效注意力相关,目的在于降低长上下文带来的计算开销。跨平台支持则表明模型在设计时考虑了不同硬件和运行环境的适配性,这对于开源模型的社区采用率有直接影响。
对开发者的启示
Muse Spark Open的演示传递出一个信号:模型能力正在从单点突破转向系统集成。一个模型同时具备多模态、长上下文、规划能力和高效推理,并能在成熟引擎上运行,这种组合更贴近真实产品需求。
开发者可以关注几个方向:一是该模型在vLLM上的实际吞吐和延迟表现;二是DSpark机制对长上下文推理成本的影响;三是跨平台支持覆盖的硬件范围。这些因素将决定它在实际项目中的可用性。
社区反响与期待
原始推文以"Wow, this is so cute!"开头,情绪化的表达反映出演示在观感上的成功。技术演示能做到既展示能力又让人愿意看完,本身就是一种有效的传播方式。不过,演示的"可爱"与生产环境的"可靠"之间仍有距离,模型的实际表现需要等待更详细的评测和社区试用反馈。
对于关注开源模型生态的人来说,Muse Spark Open在vLLM上的落地是一个值得跟踪的进展。它能否在激烈的开源模型竞争中形成差异化,取决于后续的文档完善度、社区运营和真实场景验证。
相关推荐

AI不是替代者:从工厂根因分析看人机协作
从工厂根因分析场景出发,解析AI如何加速证据链构建而非替代人类专家,探讨「AI支持人而非取代人」的务实落地逻辑与商业价值。

AI Agent决策审计:受监管流程中的证据链怎么建
从Reddit讨论出发,分析受监管流程中AI agent决策审计的三个核心问题:审计记录该包含哪些字段、错误决策的反馈延迟如何应对、以及LLM评审员与人类判断的一致性如何持续校准。

FCC首度出手:含"外国监控芯片"设备被禁
FCC首次行使新权力,以含有"外国监控芯片"为由封禁两款设备。本文分析这一监管变化对硬件供应链合规、芯片采购决策及市场准入的影响。