n8n AI Agent 入门:Token 是什么,为何决定你的成本

在n8n中理解Token机制:输入输出均计费,输出规模才是成本的真正驱动力。
本文以n8n中搭建AI工作流为背景,系统讲解了Token的核心概念与实际影响。Token是AI模型处理文本的最小单位,输入与输出均计入消耗,即使一句简单问候也会产生约26个Token的开销。文章的核心洞察在于:决定Token消耗的不是提示本身的长度,而是其要求的输出规模——"生成一本百页小说"这样的简短提示会触发海量输出Token。更多Token带来四大连锁影响:更高API费用、更慢响应速度、更丰富的上下文质量提升,以及触碰模型上下文窗口上限的风险。文章最终给出了提示精简、控制输出规模、善用相关上下文、规划Token预算等实操建议,帮助开发者在成本与效果之间取得平衡。
在 n8n 搭建 AI 自动化工作流时,很多人会忽略一个看似简单却直接影响成本的概念——Token。无论你是刚接触 AI Agent 的开发者,还是想为企业落地自动化方案的工程师,理解 Token 的运作方式都是控制预算和优化效果的基础。
什么是 Token
Token 是 AI 模型处理文本时的最小单位。当你向模型发送一个提示(prompt)、提出一个问题,或在 n8n 中运行一个 AI Agent 节点时,模型需要先把文本拆解成一个个 Token 再进行处理。可以把 Token 理解为 AI 模型的"读写单位"——你发送的信息越多,消耗的 Token 通常也越多。
关键在于:Token 既包括你输入的内容,也包括模型返回的输出。换句话说,一次完整的交互中,输入和输出的所有字符都会被计入 Token 消耗。
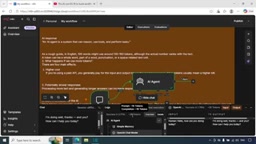
不同语言的 Token 切分效率差异显著。英文单词通常 1 个单词对应 1–2 个 Token,而中文由于字符集更大,1 个汉字往往需要消耗 2–3 个 Token,这意味着同等语义内容的中文提示通常比英文消耗更多 Token。主流模型提供商(如 OpenAI)使用的是 BPE(Byte Pair Encoding,字节对编码)分词算法,它会将高频字符组合合并为单个 Token,因此专业术语、生僻词或拼写错误的单词往往会被拆分成更多 Token 片段。你可以通过 OpenAI 官方提供的 Tokenizer 工具(platform.openai.com/tokenizer)直观地看到任意文本被切分的结果,这对估算 API 调用成本非常实用。
一个真实的例子
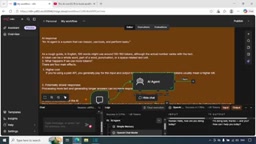
视频作者在 n8n 中用一个聊天触发器(chat trigger)连接 AI Agent 节点,输入了一句非常简单的提示:"Hello, how are you doing today?"
执行成功后,工作流显示本次总共使用了 26 个 Token。其中输入的提示约占 10 个 Token,而包含模型回复在内的完整交互合计消耗更多。一句简单的问候就能产生这样的消耗,说明 Token 的累积速度比大多数人想象的要快。
这也揭示了一个容易被忽视的事实:即使是极简的对话,背后依然在持续计费。对于需要高频调用模型的生产环境,这些看似微小的消耗会迅速放大。
提示的"上下文"比字数更重要
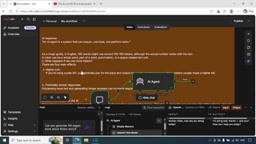
作者随后给出了一个很有启发性的对比。他输入了另一条提示:"Can you generate a 100-page fiction book?"
从字面上看,这条提示只有七八个单词,比第一条问候语长不了多少。但真正决定 Token 消耗的,不是提示本身的长度,而是它所要求的输出规模。要求模型生成一本一百页的小说,意味着输出端会产生海量 Token。
这个例子点明了一个核心原则:你的输入质量直接决定输出的 Token 消耗。好的输入能用很少的 Token 换来精准答案;而像"分析 100 页文档"或"生成一本书"这类请求,哪怕措辞简短,也会触发巨大的 Token 开销。
使用更多 Token 的四大影响
作者总结了 Token 消耗增加时会带来的四个主要后果:
1. 更高的成本
如果你使用付费 API,费用通常按输入和输出 Token 共同计算。模型处理的 Token 越多,账单金额越高。在金融、保险等大型企业环境中,员工往往需要向公司汇报自己提交了多少提示、产生了多少 Token,因为每一次调用都在产生真实的费用。
2. 更慢的响应速度
处理更多文本、生成更长答案会增加响应时间。如果你要求模型"生成一百页的书",它自然需要更长时间来逐步输出,整个工作流也会随之变慢。
3. 为 AI 提供更多上下文
Token 消耗增加并不总是坏事。当你提供长文档或对话历史这类相关信息时,更多的 Token 能给模型提供有用的上下文,从而提升回答质量。关键是信息必须真正相关,而非无谓堆砌。
4. 上下文窗口限制
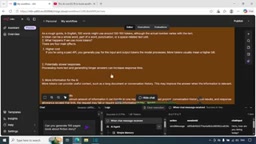
每个模型都有单次请求能处理的信息上限。当提示、对话历史、工具调用结果和回复内容的总和超过这个限制时,请求可能直接失败,或者系统会自动截断部分信息。这意味着输入过多内容时,模型甚至可能"砍掉"你的部分提示,以便更快返回结果。
如何高效使用 Token
理解了上述影响后,优化思路就很清晰了:
- 提示要简洁。能用一两句话说清的需求,就不要写成一长段。
- 控制输出规模。明确告诉模型你需要简短答案,避免无意义的长篇大论。
- 善用相关上下文。该提供的背景信息要给足,但避免塞入无关内容。
- 留意上下文窗口。在处理长文档或多轮对话时,提前规划 Token 预算,防止请求被截断或失败。
无论你是 Agent 工程师、提示工程师还是机器学习工程师,当你开始与 LLM 或 AI Agent 交互时,都应该把 Token 概念放在心上。学会用更高效的方式组织提示,让模型用更少的字数给出精准答案,既能节省成本,也能提升整体工作流的运行效率。
背景补充
上下文窗口(Context Window)是指模型在单次请求中能够"看到"并处理的最大 Token 总量,它同时覆盖输入与输出。不同模型的上限差距悬殊:GPT-3.5-turbo 的上下文窗口约为 16K Token,GPT-4o 支持 128K Token,而 Claude 3 系列最高可达 200K Token。在 n8n 的多轮对话或 AI Agent 场景中,每一轮对话历史都会被追加到下一次请求的输入中,随着对话轮次增加,累计 Token 会快速逼近窗口上限。一旦超限,常见的处理策略有两种:一是滚动截断(丢弃最早的对话记录),二是摘要压缩(用一段简短摘要替代完整历史)。n8n 的 Memory 节点提供了相关配置项,合理设置窗口大小和记忆策略可以有效避免请求失败。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。