n8n + AI自动化:90天构建智能工作流的分层路径

n8n入门的正确姿势:先掌握确定性数据流,再分阶段引入AI,避免过早构建失控的智能体。
本文基于一则YouTube教程的核心方法论,系统阐述了使用n8n自动化平台的正确学习路径。文章的中心论点是:初学者应抵制"第一天就搭AI Agent"的冲动,因为确定性的规则工作流与非确定性的AI智能体在稳定性上存在本质差异。正确顺序是先理解JSON数据结构和IF逻辑门,掌握对数据流向的完全控制;再通过API和Webhook与外部世界连通,并将系统崩溃当作诊断数据来锻造韧性;最后才在坚实的确定性框架之上,安全部署大语言模型——先做单次决策的"AI辅助工作流",再逐步引入具有记忆和工具调用能力的真正AI Agent。文章配套给出了一条90天三阶段执行路线图,其终极目标是让学习者从"使用软件的人"进化为"设计系统去替自己工作的架构师"。
大多数企业都运行在一个隐形引擎之上——复制、粘贴、点击、重复。每周有数百万小时被消耗在手动搬运数据上。n8n 作为一款 fair-code 自动化平台,正是为了终结这种内耗而生:它扮演桥梁角色,把僵化的业务流程与机器智能连接起来,让任务瞬时执行。
但如果你现在才开始上手 n8n,很可能会撞上一堵墙。这篇文章基于一则 YouTube 教程的核心观点,拆解一个被反复验证的结论:真正的杠杆来自分层架构,而不是急于搭建全自动 AI 智能体。
为什么不该在第一天就搭 AI Agent
几乎所有初学者都想在第一天就构建全自主的 AI 智能体,因为它们看起来太惊艳了。但问题在于底层逻辑的根本差异。
经典的、基于规则的工作流每次都以完全相同的方式运行——它是确定性的(deterministic)。而 AI 智能体是非确定性的(non-deterministic),它们自己做决策。这意味着如果没有被妥善约束,它们有极高的概率会崩溃。
正确的顺序应该反过来:先掌握数据搬运的可预测逻辑,再引入语言模型的不可预测性。 这种先打地基、后盖楼的思路,是整篇方法论的核心。
n8n 的画布自动运转,基于一个简单的指挥链:触发器(Trigger)捕获事件,传递给节点(Node),节点执行特定动作。每一条连接都构成一个可预测的、基于规则的系统。
确定性与非确定性系统的本质区别值得更深入理解。确定性系统(deterministic system)给定相同输入,永远输出相同结果,就像计算器——输入2+2,永远得到4。这使得错误排查极为直接:行为可预测,问题可复现,修复后可验证。
非确定性系统则截然不同。大语言模型(LLM)依赖概率采样生成输出,同样的输入在不同时刻可能产生措辞不同的回答,在极端情况下甚至产生逻辑矛盾的结论。这种特性在创意写作或开放问答中是优势,但在需要严格执行业务规则的自动化流程里,却是潜在的定时炸弹。当AI Agent被赋予调用外部API、修改数据库或发送通知等"真实世界"权限时,一次错误的自主决策可能造成难以回滚的连锁后果。这正是为什么经验丰富的自动化工程师总是先用确定性节点锁死流程的骨架,再在受控的边界内引入模型推理。
JSON 是流动在管道里的血液
在这些连接中流动的,是 JSON。它看起来像代码,但本质上只是一份结构化的信息清单——就像网购购物车的那张收据。
与其面对一整块混乱的文本,JSON 把信息组织成干净的键值对(key-value pairs):比如 color 配 blue,或者 price 配 $99。理解 JSON 不是在写代码,而是在读一份有组织的清单,这个心智模型能帮初学者跨过第一道认知门槛。
用逻辑门控制数据走向
当这些结构化的键值对沿着连接路径流动时,它们最终会撞上逻辑门,比如 IF 节点。在这里你用表达式(expressions)设定条件规则:如果价格超过 $100,就把数据送往路径 A;如果低于 $100,就路由到路径 B。
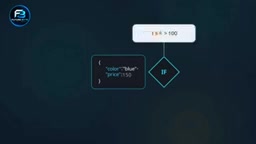
掌握这些刚性的路由规则,你就获得了对数据行为的完全控制。正是这种严格的结构,让复杂的自动化系统能在无需人工持续监督的情况下平稳运行。
与外部世界通信:API 与 Webhook
一旦你能控制 n8n 内部的数据,就需要与外部世界沟通。API 扮演通用翻译器的角色,让你的工作流能向几乎任何外部软件发出指令。通过阅读 API 文档,你构建 HTTP 请求,把数据发送到那些没有原生集成的平台。
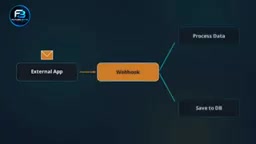
如果说 API 是把指令推出去,那么 Webhook 则反转了这个流向。Webhook 监听真实世界的事件——比如一封新邮件或一次表单提交——并用这个触发器把新鲜数据拉进来。
把失败当作诊断数据
在不同外部工具之间搬运数据,必然会遇到格式不匹配、API 意外更新、执行中断等问题。但这些失败其实是极有价值的诊断数据:它们精确地暴露了系统的薄弱环节,告诉你应该在哪里构建专门的错误处理路径和防护栏(guardrails)。
最具韧性的工作流,是通过刻意的压力测试锻造出来的。你不断把系统推到极限,为每一个发现的边缘情况设计解决方案,真正的稳定性由此而来。
API(应用程序接口)与 Webhook 代表两种根本不同的通信模式,理解这一区别能帮助你在正确场景选用正确工具。API 调用是"主动拉取"(polling)模式:你的工作流主动发起 HTTP 请求,向外部服务询问数据或下达指令,然后等待响应。这适合需要按计划批量同步数据的场景,但如果轮询频率过高,会浪费算力;频率过低,则会错过实时事件。
Webhook 则是"被动推送"(push)模式:你在 n8n 中生成一个独一无二的 URL,把它注册到外部服务(如 GitHub、Stripe、Typeform),此后每当目标事件发生,外部服务会立即向这个 URL 发送 HTTP POST 请求,工作流因此被即时唤醒。这种"事件驱动"架构响应延迟极低,且无需持续轮询,资源利用率更高。两者并非互斥——复杂工作流常常混合使用:Webhook 负责实时捕获事件入口,API 调用负责随后向其他系统写入处理结果。
在确定性框架上安全部署 LLM
当一个可靠、确定性的框架就位后,你才可以安全地部署大语言模型。与标准节点不同,这些模型以流动的方式处理信息,根据你喂给它的上下文生成响应。
这里要区分两个层次:
- AI 辅助的工作流:用模型做一个孤立的单次决策,比如把一张支持工单评定为高优先级或低优先级。
- 真正的 AI Agent:拥有记忆和一整套工具,能够独立采取行动、决定自己的下一步。
正因为 Agent 会自行决定下一步,它们需要持续维护和频繁评估。只有当某个任务确实需要固定规则无法解决的动态推理时,你才引入这种程度的自主性。
举个例子:把一个确定性的网页爬虫与一个 AI 摘要步骤结合,就能得到一个全天候提取并浓缩目标研究资料的系统。模型的智能最终受限于它所依附的结构——当你把流动的推理锚定在刚性的工作流之上,就把原始算力转化为可衡量、高杠杆的业务产出。
"AI 辅助工作流"与"真正的 AI Agent"之间的架构差异远比字面更深刻。 前者本质上是一个普通节点:LLM 接收固定格式的输入,输出结果后立即交还控制权给确定性流程,整个决策链条的分支仍由 IF 节点等规则引擎掌控。这种模式风险极低——即使模型输出异常,下游的硬性规则也能充当安全网。
真正的 AI Agent 则引入了"工具调用循环"(tool-use loop):模型不仅生成文本,还能自主决定调用哪些工具(如搜索网络、查询数据库、发送邮件),并根据工具返回的结果规划下一步行动,直到认为任务完成。这种架构的核心挑战在于"幻觉"(hallucination)和"目标漂移"(goal drift)——Agent 可能自信地执行了错误步骤,且每一步都消耗真实资源。因此工程实践上通常需要为 Agent 设置明确的工具权限白名单、最大步骤数上限,以及人工审核的"断路器"节点,防止失控的自主行为在生产环境中造成不可逆影响。
90天执行路线图
达到这种产出水平需要实际动手。只看视频而不亲自构建、破坏、调试,只会让你卡在"教程地狱"里。原教程给出了一条清晰的三阶段路径:
- 第 1–30 天:专注手动执行。梳理触发器、核心节点,学会阅读 JSON。
- 第 31–60 天:向外扩展,集成 API、Webhook,并建立严格的错误处理。
- 第 61–90 天:搭建认知层,安全部署你的第一个集成 AI Agent。
遵循这个渐进顺序,区分的是两类人:依赖软件的人,和控制软件的人。你要么继续做那个点按钮的工人,要么成为那个设计系统去替你点按钮的架构师。
相关推荐

HF Buckets与Xet:只上传变化的数据,告别带宽浪费
Hugging Face Xet 技术让你只上传数据集中真正变化的部分,告别重复上传带来的带宽浪费。本文解析 HF Buckets 工作原理、Parquet 内容定义分块配置及生产环境注意事项。

Google徽章认证:开发者求职的新凭证
Google与GeeksforGeeks合作推出面向开发者和学生的数字徽章计划,强调技能需要被证明而非仅仅声称。本文解析数字徽章作为求职凭证的价值、信号作用及理性看待的要点。
Lovable Pro Plus 管理面板营销分析:免费积分噱头与风险提示
针对 YouTube 上「Lovable Pro Plus 管理面板、无限免费积分、899 卢比终身访问」的营销素材进行拆解,分析其卖点、Lovable 官方积分机制及潜在的账号与资金风险,并给出理性选择 AI 建站工具的建议。