#LLM部署
共 10 篇相关文章
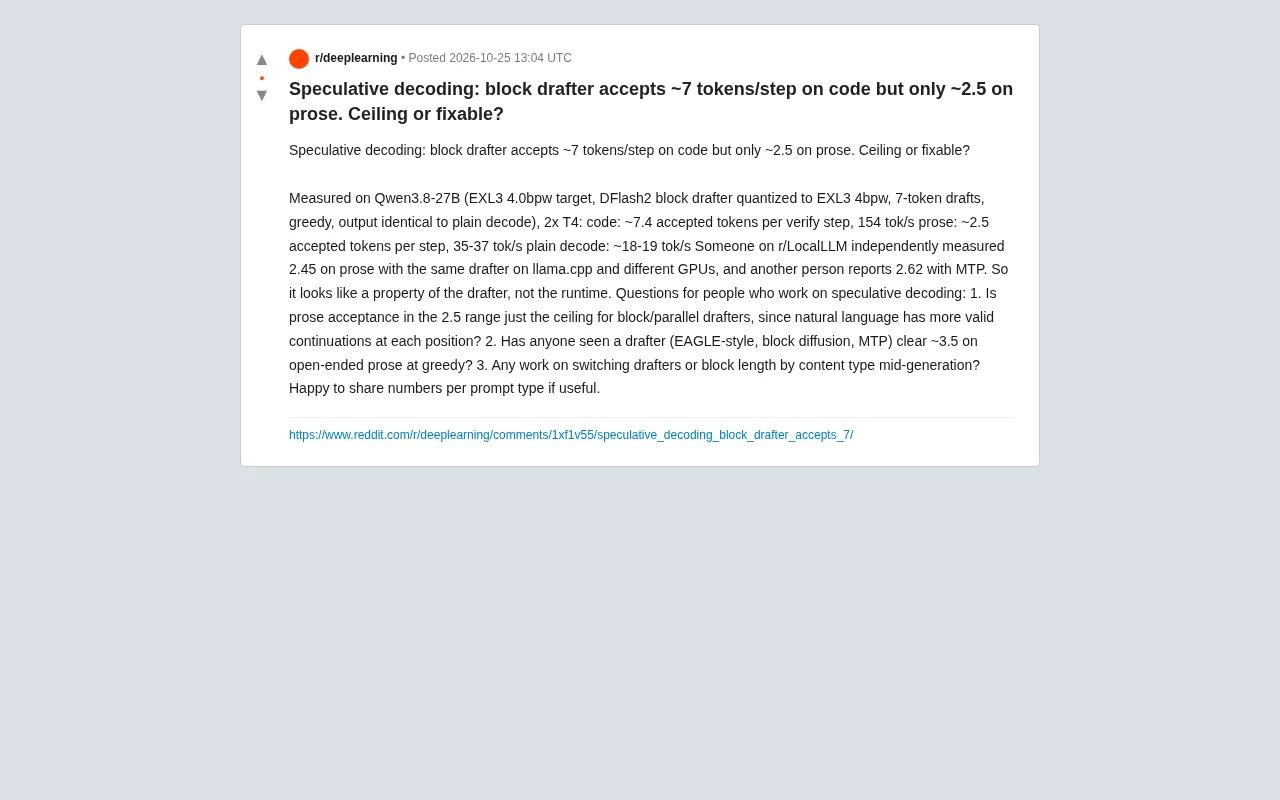
投机解码的“偏科”现象:代码接受率7个/步,通用文本仅2.5个,是上限还是可优化?
Reddit实测显示投机解码块状草稿器在代码上每步接受约7个token,散文仅2.5个,多源验证指向草稿器特性而非运行时问题。本文分析散文接受率是否触及上限、现有方案能否突破3.5,以及对推理部署的实践启示。
实测取代公式:ModelFit 如何终结 LLM 显存估算的混乱
ModelFit 项目通过直接测量 Hugging Face 上 GGUF 量化文件大小,取代传统参数量公式估算,解决 LLM 显存需求答案混乱的问题。文章详解其工作原理、Kimi K3 实测数据、KV 缓存计算方式及项目局限性。
本地部署大模型实战:Ollama、llama.cpp 与 vLLM 深度对比
深度对比 Ollama、llama.cpp 与 vLLM 三大本地大模型部署引擎:易用性、显存要求、量化选择、吞吐性能与成本账,附决策路径与故障排查,帮你选对推理后端。

LLM生产环境落地:10条工程实践与部署要点
资深工程师分享 LLM 生产环境落地的10条工程实践:推理端点选型、prompt 缓存、token 上限控制、数据加密、延迟与成本监控、异步队列、prompt 版本管理、真实数据集成测试、优雅降级与运行手册。

从LLM API转向自托管:这笔账到底划不划算?
从LLM API转向自托管大模型到底值不值?本文基于Reddit工程师社区的真实讨论,拆解API账单临界点、GPU闲置成本、冷启动与运维之痛,并给出自托管决策的全成本框架。
 教程攻略
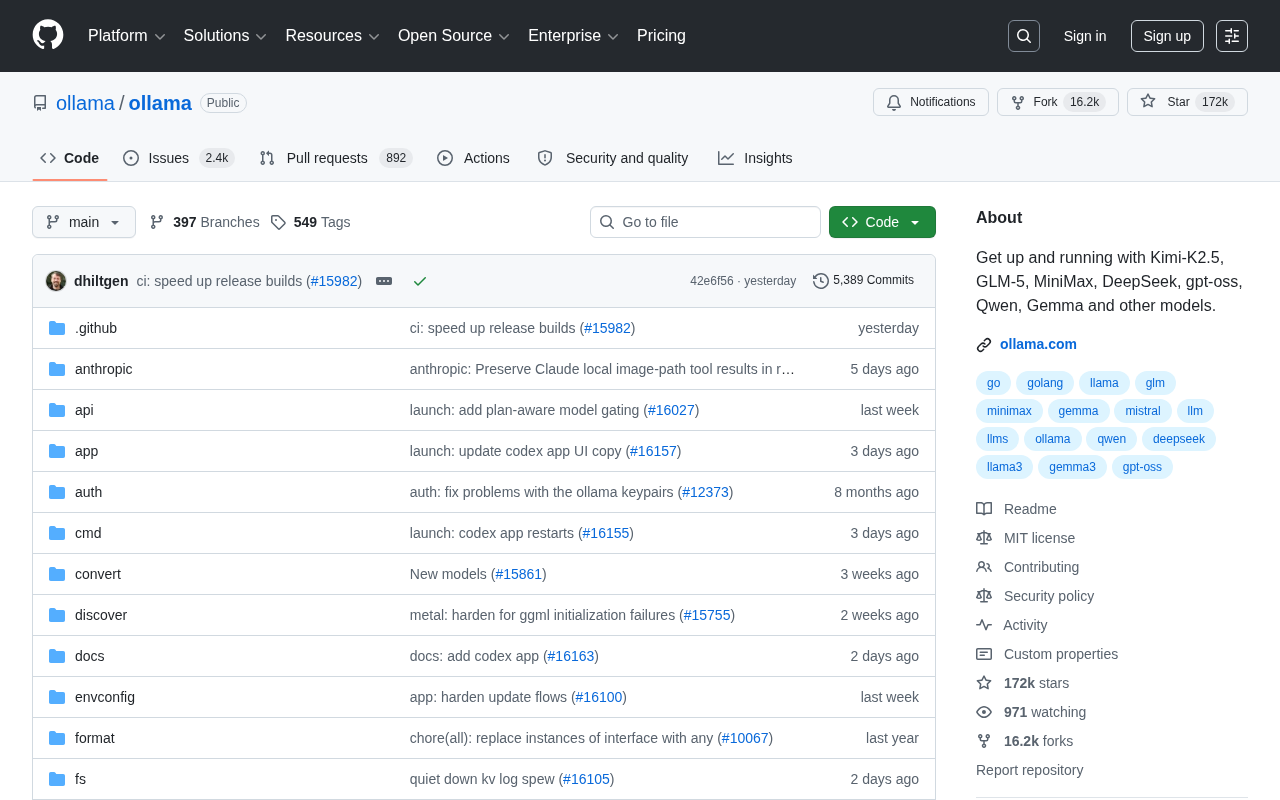
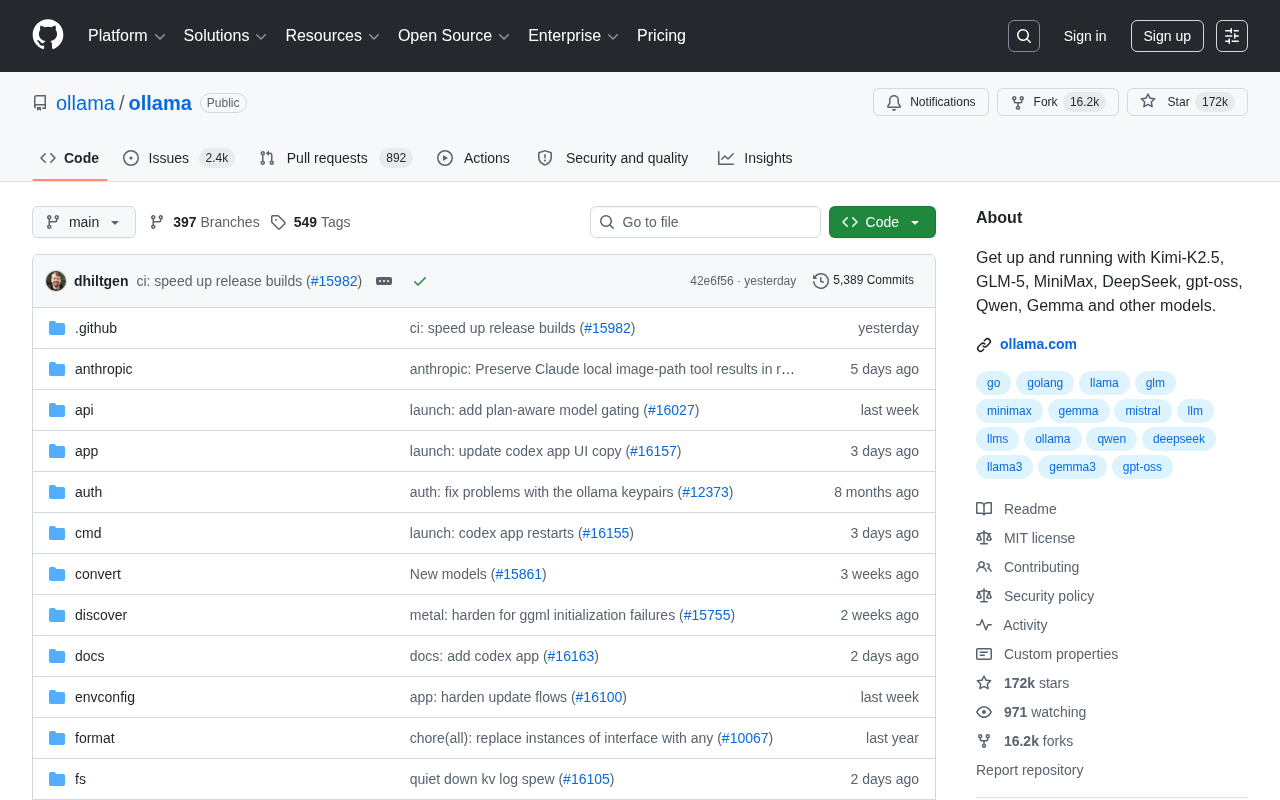
Ollama教程:一键本地部署DeepSeek、Qwen等大模型
详解Ollama本地运行大模型的完整指南,支持DeepSeek、Qwen、Kimi-K2.5等主流开源模型,涵盖安装使用、模型生态、隐私优势及企业私有化部署场景,GitHub 17万Star的热门开源工具。
 教程攻略
Ollama教程:本地运行大模型的完整指南(2025最新)
详解Ollama本地部署大语言模型的完整教程,支持DeepSeek、Qwen、Kimi-K2.5等主流模型。17万Star开源项目,一键安装即可在本地运行LLM,保护数据隐私,零API成本。
 教程攻略
Ollama教程:本地运行DeepSeek等大模型的最简方案
详解Ollama本地部署大模型的完整指南,支持DeepSeek、Qwen、Kimi-K2.5等主流模型。了解这款17万Star开源工具如何实现一键安装、离线推理,以及适用场景与生态集成方案。
 教程攻略
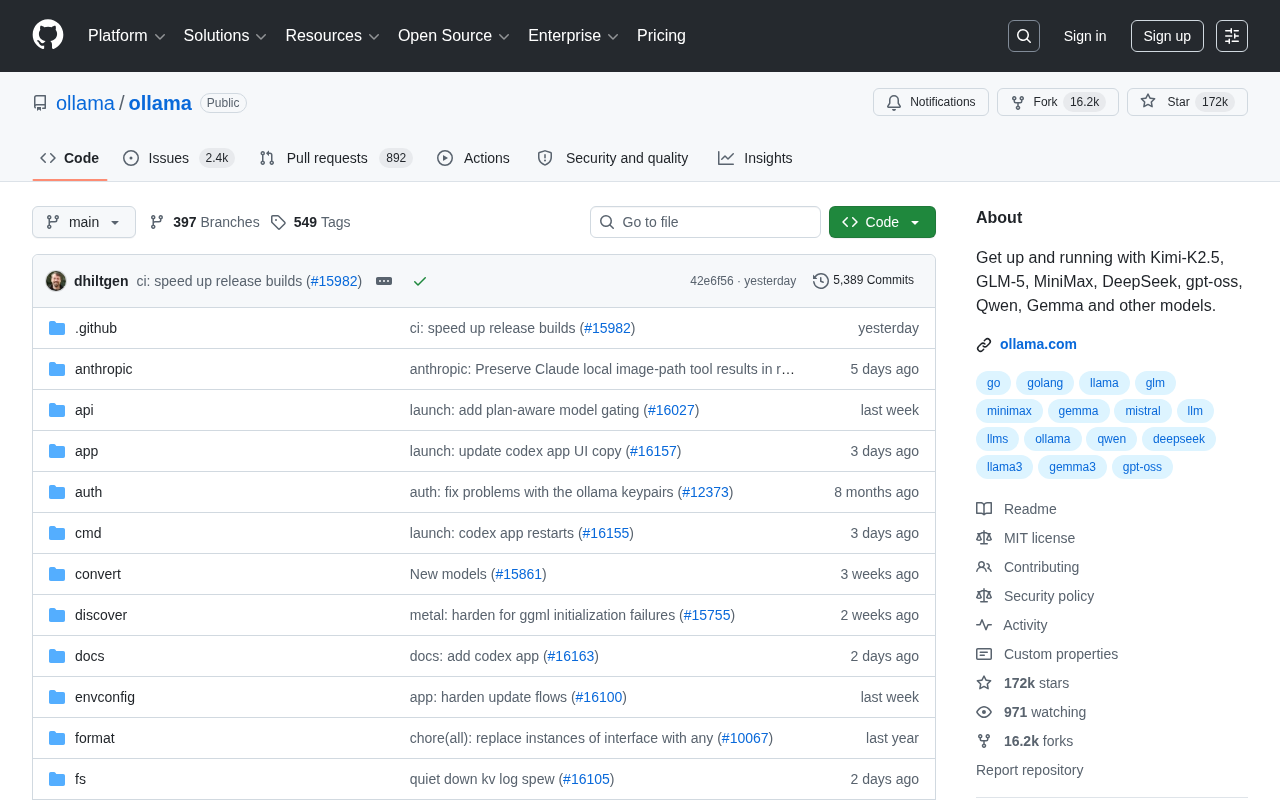
Ollama教程:17万Star的本地大模型运行框架深度解析
深度解析Ollama开源项目,一行命令本地运行DeepSeek、Qwen、Kimi-K2.5等主流大模型。详解安装使用、模型生态、技术架构及适用场景,助你快速上手本地LLM部署。
 教程攻略
Ollama教程:一键本地部署DeepSeek等大模型
Ollama是GitHub上17万Star的开源工具,支持DeepSeek、Qwen、Gemma等主流大模型本地运行。本文详解Ollama的安装使用、支持模型、适用场景及核心优势,助你快速实现大模型本地化部署。