n8n 入门指南:看懂自动化工作流的底层逻辑

用「Node、数据类型、执行路径、AI Agent」四个构件,拆解 n8n 自动化工作流的底层逻辑。
本文以 n8n 为例,系统拆解了自动化工作流的基础构件。工作流不是线性清单,而是一张可分叉、并行、汇合的执行路径图。最小单位 Node 各自负责单一任务,通过 Input/Output 传递数据,数据本质上仅由 String、Number、Boolean、Array、Object 五种类型组成。配置节点时,Fixed 写死静态值,Expression 实现运行时动态取值,后者是构建通用工作流的关键。在执行控制上,IF 与 Switch 节点按预设规则分叉;而 AI Agent 则更进一步,由语言模型在运行时自主选择调用哪些工具,并借助 Context Memory(保持对话上下文)和 RAG(检索外部知识库)两种记忆机制弥补模型的信息盲区。理解这些基础构件后,任何复杂工作流都不过是它们以不同方式的组合与嵌套。
很多人第一次打开 n8n 这类自动化工具时,往往会感到困惑。工具宣称是「No Code」,理应简单易用,但真正打开后看到的却不是一张清晰的步骤清单,而是一堆相互连接的方块、交错分叉的连线——更像一张地铁线路图,而不是「第一步、第二步、第三步」的流程。
这篇文章基于 YouTube 创作者 Mostafa Magdy(拥有十余年云计算、DevOps 与 AI 领域经验)的 n8n 入门讲解,把这张看似混乱的「地铁图」拆解成几个最基础的构件,帮助新手真正理解自动化工作流的运行逻辑。
为什么工作流看起来像地铁图
大多数初学者的误区在于:期待流程像清单一样线性推进,一步接一步。但实际上,工作流不是一串顺序执行的任务,而更接近于你在「绘制一条执行路径」——你需要决定什么先发生、什么后发生、数据什么时候分叉、什么时候重新汇合。
一旦理解了这个基本观念,那张看似随机复杂的地铁图就会显现出它真正的面貌:逻辑清晰、易于理解,甚至相当简单。关键在于先搞懂底层的构件,而不是被整体的复杂外观吓退。
Node:工作流的最小单位
画布上每一个方块都叫做 Node(节点),每个 Node 只负责一件事。比如一个 Node 负责抓取邮件,另一个 Node 判断某个数字是否大于 100,第三个 Node 向 Slack 发消息,第四个 Node 让 AI 帮你总结一段文字。
可以把 Node 想象成生产线上的一个工位。这个工位上的工人不需要知道上一步发生了什么,也不需要知道下一步会怎样,他只负责在收到的东西上完成自己那一项任务,然后把结果传给下一个工位。所谓工作流,本质上就是一组 Node,每个负责特定任务,按你想要的顺序连接起来。
数据如何在节点间流动
生产线要运转,就必须有东西在工位之间移动。在 n8n 里,每个 Node 都会接收数据(Input),对数据做处理后产出新数据(Output),再把 Output 传给下一个 Node。
想象传送带上放着一个托盘在工位间移动——从某个工位出来的东西,正是下一个工位要接收的。抓取邮件的 Node 把邮件放上传送带,下一个 Node 可以从中读取发件人地址,并据此决定下一步动作。没有任何数据会在「暗处」偷偷传递,传送带上有什么,后续 Node 就能看到什么。
三种查看数据的视图
n8n 用三种方式展示传送带上的数据:Schema、Table 和 JSON。要注意,这不是三种不同的数据,而是同一份数据的三种查看方式。
- Schema view:最简单,只是列出数据的字段名(如姓名、邮箱、订单总额),帮你快速了解有哪些字段可用。
- Table view:类似电子表格,数据按行列排布,适合快速浏览大量数据,就像看 Excel 表格。
- JSON view:最重要,它展示数据真实的内部结构——系统实际存储的样子,包含所有细节、顺序和关系。
你不需要背诵 JSON 的写法就能用好 n8n,但要记住一点:当 Table view 看不清楚时,随时可以打开 JSON view 查看完整、无隐藏的真实数据。
数据只有五种基本类型
JSON 是其他所有视图的基础,它里面的信息只由五种基本类型构成:
- String(字符串):文本,如姓名、地址、邮箱、句子。
- Number(数字):价格、数量、年龄等数值。
- Boolean(布尔值):true 或 false,比如订单是否已付款。
- Array(数组):一组东西的列表,比如多个邮箱地址。
- Object(对象):把多条相关信息打包在一起的「盒子」,每条信息都有名字,比如一张客户资料卡包含姓名、邮箱、电话。
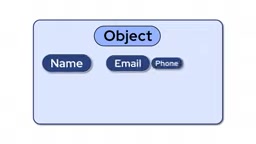
无论你要搭建多复杂的工作流,最终都只是这五种类型以不同方式组合、嵌套而成。比如客户数据是一个 Object,里面姓名、邮箱是 String,年龄是 Number,付款状态是 Boolean;而一组客户就是一个装着多个 Object 的 Array。没有隐藏的第六种类型。
Fixed 与 Expression:静态值还是动态取值
配置 Node 时,你通常面对两个选择:Fixed 或 Expression。
**Fixed(固定值)**意味着你写死一个值,无论流经的数据如何变化,Node 每次都用同一个值。就像你亲手在信封上写下一个名字,这个名字永远不变。
**Expression(表达式)**则让 Node 在运行时自动从流入的数据里取值。比如不写死某个邮箱地址,而是告诉 Node「取现在传进来的数据里的邮箱地址」。相当于在信封上写「填入信封里那个人的名字」——每次运行,Node 都会根据当次数据取到合适的值。
这正是「只能处理单一情况的工作流」与「能应对不同数据的工作流」之间的区别。用同一组 Node,就能正确处理 100 个不同客户、100 封不同邮件。
执行顺序与分支逻辑
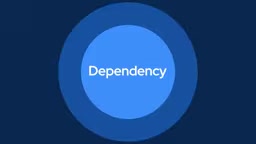
默认情况下,n8n 按节点间连线的顺序执行:从 Trigger(触发整个工作流的起始节点)开始,沿着连线通常从左到右推进。关键在于,一个 Node 通常要等前面的 Node 完成并输出结果后才会启动——这就是所谓的依赖(Dependency):某个 Node 要依赖它前面的 Node 才能工作。
但注意「默认」二字——工作流不一定总是从头到尾的单一路径。
- IF 节点:判断某个条件(比如订单是否超过 100 美元),满足走一条路径,不满足走另一条。
- Switch 节点:同样是分流,但可以有多个分支,每个分支里可以有完全不同的 Node 组合。
分叉后的路径还可以用专门的合并节点重新汇合。想象一条河遇到岛屿分成几股,绕过去后又汇成一条——这比把工作流想象成一条直线要准确得多。有些部分顺序推进,有些部分按条件分叉,有时多条路径还会同时运行后再汇合。
AI Agent:让 AI 决定走哪条路
前面的分支都基于你预先写好的规则。但如果决定走哪条路的,不是固定规则,而需要在当下做判断呢?这就是 AI Agent 登场的地方。
普通 Node 做一件确定的事,路径由你从一开始就用 IF 或 Switch 规划好。而 Agent 彻底改变了这个思路:你不再预先规划每一步,而是给它一个目标、一个可以推理的 AI 模型,以及一组工具(Tools)。这些工具本质上就是其他的工作流,Agent 在需要时自行决定调用。
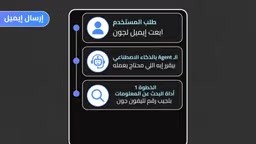
举例:你给 Agent 两个工具,一个查询某人信息,一个发送邮件。你不告诉它「先查信息再发邮件」,只描述每个工具的功能和适用场景。当有人要求 Agent 给某人发邮件时,Agent 自己判断「我是否需要先了解这个人的信息」,然后调用查询工具,再决定调用发邮件工具。如果任务根本不需要发邮件,它就不会用那个工具。
这就是核心区别:普通工作流由你画好所有路径与可能性;而用 Agent,你给工具和目标,由 AI 在当下根据请求自主决定走哪条路。
从技术层面理解,AI Agent 背后依赖的是大语言模型(LLM)的「函数调用」(Function Calling)能力。当 Agent 收到一个请求时,模型不仅生成文字回复,还能输出结构化的「我需要调用哪个工具、传入什么参数」的指令。n8n 捕获这些指令后,实际执行对应的工作流或 API 调用,再把结果喂回给模型,模型据此判断任务是否完成,或是否需要继续调用其他工具。这个「思考→调用→观察→再思考」的循环往往被称为 ReAct(Reasoning + Acting)模式。理解这一点有助于你预判 Agent 的边界:它的决策质量直接取决于你对每个工具的描述是否清晰——工具说明写得越准确,Agent 选对工具的概率就越高。
两种记忆:Context Memory 与 RAG
如果 Agent 在当下做决策,它怎么记住之前的对话?又怎么知道它从未训练过的信息?这里有两种不同的记忆,各自解决不同问题。
**Context Memory(上下文记忆)**是短期记忆,让 Agent 记住同一次对话中前面说过的话。没有它,你告诉 Agent 你的名字后再问相关问题,它会把每条消息都当作陌生人第一次对话来处理。
**RAG(Retrieval Augmented Generation,检索增强生成)**解决的是另一个问题:它不负责记住对话,而是给 Agent 提供它从未训练过的信息——比如你公司最新的价目表、产品目录、内部文档。这些信息存在独立的数据库里,Agent 在被提问时去数据库检索相关内容,再据此生成答案,而不是靠猜或编造。
简言之,Context Memory 让 Agent 记住对话,RAG 让 Agent 知道对话之外的信息。一个 Agent 可以有其中一个、两个都有,或都没有,完全取决于你要它完成的任务。
RAG 的工作原理值得进一步展开。文档被导入系统后,会先被切成小块(Chunk),再由嵌入模型(Embedding Model)将每个文本块转换成一组数字向量,存入向量数据库(Vector Database)。当用户提问时,问题本身同样被转换成向量,系统在数据库中找出与之「方向最接近」的若干文本块,把它们连同原始问题一起交给语言模型生成答案。这个过程完全不修改模型本身的参数,只是在推理阶段临时增加了相关背景。因此 RAG 特别适合需要频繁更新的信息,比如价格表每周更新,只需重新导入文档,不需要重新训练任何模型。在 n8n 中,向量存储节点(Vector Store Node)封装了这一整套流程。
回到那张地铁图
退一步看,最初那张令人困惑的地铁图,本质上就是:一组 Node,每个负责一件确定的任务,有清晰的 Input 和 Output;数据在它们之间以结构化方式流动,而这些数据归根结底由五种基本类型构成。Node 通常按连线顺序执行,但工作流可以分叉、汇合,或多条路径并行——这正符合真实业务逻辑的运作方式。
Agent 建立在同样的基础上,区别只在于:不是你画好所有路径,而是 AI 模型在一组工具间自主选择路径,用 Memory 保持对话上下文,用 RAG 获取训练之外的信息。
这些概念单独看都不复杂。让完整工作流显得复杂的,只是这些简单想法叠加、组合在了一起。而理解基础的价值正在于此:一旦你掌握了这些构件如何协作,每次打开新的工作流,你面对的不再是陌生的难题,而是同一组熟悉的 building blocks,只是以略微不同的方式连接而已。
相关推荐

OpenAI办公室发现录音设备:安全与隐私再引关注
OpenAI在一处办公室发现录音设备,事件细节有限但引发对AI公司物理安全与隐私保护的广泛讨论。本文分析事件背景、行业影响及对AI从业者的安全启示。

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。