n8n 新手教程:用提示词工程优化 AI 邮件总结
通过「角色+上下文+输出格式」的结构化提示词框架,在n8n中稳定获得高质量LLM输出。
本文围绕n8n自动化工作流中的提示词工程展开,以「自动总结客户邮件」为演示案例,系统讲解如何让大语言模型输出可靠、符合预期的结果。核心方法是将提示词拆解为四个板块:角色(定义AI身份)、上下文(提供任务背景)、输出格式(规定呈现方式)和可选工具。文章通过对比实验直观验证了这一框架的价值——模糊的「summarize this email」导致模型胡编乱造,而结构化提示词则稳定输出三个清晰的要点总结。在技术实现层面,教程演示了如何通过Edit Field节点存储邮件文本、用表达式将其引入OpenAI节点,以及如何区分系统消息与用户提示词的职责。最终结论是:应像撰写岗位说明书一样编写提示词,以换取自动化工作流输出的稳定性与一致性。
为什么提示词决定了 AI 的输出质量
在 n8n 自动化工作流中接入大语言模型(LLM)已经不是难事,难的是让 AI 真正输出你想要的结果。这期 LLM 新手系列教程聚焦一个核心话题:提示词工程(Prompt Engineering)如何改变 LLM 的行为,并以一个实用场景——自动总结客户邮件——作为演示案例。
教程的核心观点很直接:同样的模型、同样的输入,一个结构松散的提示词可能让模型胡编乱造(hallucinate),而一个结构清晰的提示词则能稳定产出符合格式要求的高质量回复。换句话说,好的提示词是获得可靠 AI 输出的前提,而不是可有可无的锦上添花。
幻觉(Hallucination) 是大语言模型的一种典型失效模式,指模型生成看似合理但实际上并不存在或与输入不符的内容。其根本原因在于 LLM 的工作机制——模型本质上是在做「下一个 token 的概率预测」,当提示词缺乏足够约束时,模型会根据训练数据中的统计规律「补全」内容,而非严格依据输入事实作答。这就是为什么模糊提示词会让模型凭空捏造「潜在买家」「最新产品目录」等未经提及的信息。结构化提示词通过明确角色、上下文和输出格式,为模型的生成过程设置了更强的条件约束,显著缩小了模型可以「自由发挥」的空间,从而压制幻觉的发生概率。
搭建演示工作流:从手动触发到邮件输入
整个流程从一个 n8n 的手动触发节点(Manual Trigger)开始。为了模拟真实场景,教程先用一个 Edit Field 节点来存放一段邮件文本——这里需要的是一个段落字段,而不是单一数值字段。
示范中,作者先让 ChatGPT 生成了一封「客户询问笔记本电脑产品信息」的邮件(约 7 到 8 行),再把这段文本粘贴到 Edit Field 节点里。随后通过 n8n 的 表达式(Expression) 功能,把上游节点生成的邮件内容引用到下游节点中。执行后,这封邮件就作为数据流入后续的 AI 处理节点。
这一步看似琐碎,却是很多新手容易卡住的地方:如果没有正确连接数据源或配置输入,AI 节点就会显示红色警告,提示输入「undefined(未定义)」。
配置 OpenAI 节点与模型
接下来是接入模型。教程使用了 OpenAI 节点,并通过 OpenRouter 作为模型接入渠道(此前的视频已经用过这一配置)。
配置时需要明确两件事:
- 输入(Input):告诉 AI 要处理的数据是什么,也就是前面准备好的那封邮件。
- 系统消息(System Message):相当于给 AI Agent 下达的「岗位说明」,定义它该如何行事。
作者特别强调,系统消息和提示词的区别在于——系统消息是整体指令,而提示词决定了具体的输出如何被生成。两者配合不当,模型就容易产出偏离预期的内容。
OpenRouter 是一个统一的 LLM API 网关,允许开发者用同一套接口调用 OpenAI、Anthropic、Google、Meta 等多家厂商的模型,而无需分别申请和管理多个 API Key。在 n8n 中,通过将 OpenAI 节点的 Base URL 指向 OpenRouter 端点,即可在不更换节点类型的情况下切换底层模型。这种方式的优势在于:一方面可以按任务特性选择性价比最高的模型(例如用较便宜的模型处理简单摘要任务),另一方面也便于在模型供应商出现服务中断时快速切换备用方案,提升自动化工作流的健壮性。
提示词的四个核心组成部分
这是整期教程最有价值的部分。作者把一个有效的提示词拆解为四个板块:
1. 角色(Role)
定义 AI 「是谁」。例如:「你是一名客户支持专员,负责总结客户邮件。」明确角色能让模型以正确的身份和语气来处理任务。
2. 上下文(Context)
提供背景信息。例如:「这是一封来自客户的、咨询产品信息的邮件,请对其进行总结。」上下文让模型理解任务的来龙去脉,减少凭空猜测。
3. 输出格式(Output)
规定结果的呈现方式。示范中要求「用三个要点(bullet points)来描述邮件内容」。
4. 工具(Tools,可选)
当任务需要调用外部能力时,才需要定义工具板块。是否使用取决于你希望 AI 完成的具体任务。
这一框架与学术界和业界常用的提示词设计方法高度吻合。值得注意的是,「系统消息(System Message)」与「用户消息(User Message / Prompt)」在 LLM 的对话结构中扮演不同角色:系统消息在对话开始前写入,优先级更高,用于设定模型的整体行为边界;而用户消息则是每次请求时动态传入的具体指令或内容。在 n8n 的 OpenAI 节点中,将角色和输出格式要求写入系统消息、将待处理的邮件正文通过表达式动态注入用户消息,是一种更符合模型设计意图的分层做法,也能让提示词在复用时更加灵活——只需替换用户消息中的邮件内容,系统消息的指令无需每次重写。
对比实验:模糊提示 vs 结构化提示
教程用一组对比直观地展示了提示词的威力。
当作者只写一句模糊的「summarize this email(总结这封邮件)」时,模型虽然给出了回复,但格式和内容都不符合预期——它自作主张地提到「潜在买家」「最新产品目录」等信息,没有按照需要的结构输出。
而当使用包含角色、上下文、输出格式的完整提示词后,模型稳定地产出了三个清晰的要点:
- 产品咨询(Product Inquiry):客户对公司工业材料感兴趣,索取最新产品目录及规格、尺寸、材质选项。
- 订单需求(Order Requirement):询问最低起订量等要求。
- 交付与文档(Delivery & Documentation):就交付可行性和相关文档寻求澄清。
两次输出的差距,正是「结构化提示词」价值的直接体现。相同的输入,仅仅因为提示词的组织方式不同,结果的可用性天差地别。
小结:把提示词当成一份工作说明书
这期教程的实操门槛不高,但背后的方法论值得所有在 n8n 里接 LLM 的用户记住:不要指望模型「猜」出你的意图,而要像写岗位说明书一样把要求讲清楚。
按照「角色 + 上下文 + 输出格式 +(可选)工具」的框架来组织提示词,不仅能用在邮件总结上,也适用于绝大多数 AI Agent 场景。对自动化工作流而言,输出的稳定性和一致性往往比偶尔的「惊艳回答」更重要,而这正是结构化提示词能带来的保障。
相关推荐
AI大肥鱼入驻B站:一条全自动内容流水线的诞生
B站AI账号“大肥鱼”发布全自动生成自我介绍视频,从一句话主题到文案、配音、画面、封面、上传全由脚本完成,展示AI内容生产流水线的工程化程度,探讨自动化内容对创作者与平台生态的影响。
AI Agent调用真实SolidWorks:理工科建模助手开源项目解析
介绍一个GitHub 1.3k star的开源项目,其AI Agent可调用真实SolidWorks软件执行建模任务,支持三维模型创建、装配、工程图导出,并具备模型尺寸与重建状态验证机制,适合机械工程学生和SolidWorks用户关注。
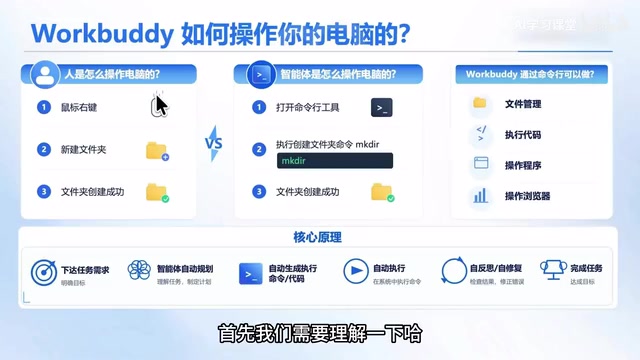
WorkBuddy零基础入门:桌面Agent工作原理与实战搭建
基于B站WorkBuddy教程,系统讲解桌面级Agent的工作原理:命令行驱动本机操作、连接器与MCP外部集成、规划执行反馈修复的闭环流程,以及零基础学习路径与实战方向,帮助新手判断能力边界与适用场景。