N8N低代码智能体实战:从节点搭建到企业级应用

N8N 是支持 500+ 节点的通用低代码自动化平台,本文解析其特性、部署与 AI 集成路径。
文章澄清 N8N 并非纯 AI 工作流工具,而是节点驱动的通用低代码自动化平台,节点数量超过 500 个,可承载数据清洗、视频发布、内容爬取等非 AI 任务。其节点生态以 YouTube、Telegram、Google Sheets 等海外应用为主,微博、微信、飞书等国内平台缺乏原生支持,需借助 HTTP 请求节点自行封装,这是国内普及度低的重要原因。部署方面,文章对比在线云服务、NPM 原生安装和 Docker 三种方式,明确推荐 Docker Compose 私有化部署。AI 集成部分归纳为 AI Agent 节点、Chain 节点和工具节点三要素,构成 RAG 与 AI 应用的基础。最后给出选型建议:需评估业务场景与节点覆盖的匹配度。
N8N 常被误解为纯粹的 AI 工作流工具,但它本质上是通用型低代码自动化平台。在 B 站码士集团的分享中,N8N 被定位为可承载数据清洗、视频发布、内容爬取等常规任务,同时具备与 AI 深度集成的能力。本文将围绕 N8N 的核心特性、部署方式以及 AI 智能体构建路径展开,帮助开发者理解如何将这一工具落地到实际业务中。
N8N 到底是什么:不止于 AI 工作流
N8N 首先是一个工作流自动化平台,其核心是节点(Node)驱动的流程编排。每个节点负责特定功能,例如从网页抓取数据、向视频平台发布内容或获取新闻资讯。这种设计与 Coze、Dify 等工具中的节点概念类似,但 N8N 的节点库规模更为庞大。
据分享者介绍,N8N 支持的节点数量至少在 500 个以上,部分统计甚至超过 1000 个。这一数字远超自研或部分同类平台,构成了 N8N 强大的集成能力基础。用户可以通过组合不同节点,构建出复杂度极高的业务流程,包括分支、循环、错误处理和数据转换等逻辑。
分享者特别强调,不要一开始就把 N8N 的工作流与 AI 工作流划等号。它完全可以用于与 AI 无关的任务,比如数据清洗或视频评论分析。这种通用性使得 N8N 在企业内部具有更广泛的适用场景,而非局限于 AI 应用开发。
节点生态的优势与本土化短板
N8N 的节点丰富度是其核心卖点,但这一优势在国内市场却面临挑战。分享者指出,N8N 作为国外平台,其节点主要覆盖海外应用生态,例如 YouTube、Telegram、Instagram、Google Sheets 以及 Airtable 等在线表格服务。用户配置账户后,即可通过节点直接发布视频、发送消息或将数据写入在线表格。
然而,国内常用平台如微博、微信、飞书表格、达梦数据库等,在 N8N 中缺乏原生节点支持。这意味着国内企业在使用 N8N 时,节点可用范围会大幅收窄,许多本土化场景需要借助 HTTP 请求节点自行封装,增加了实施成本。分享者坦言,这是 N8N 在国内公司中普及度较低的重要原因之一。
这一短板并不否定 N8N 的技术价值,但提醒开发者在选型时需评估业务场景与节点覆盖的匹配度。对于涉及海外业务或通用数据处理的任务,N8N 的节点生态优势明显;而对于强依赖国内应用生态的场景,则需谨慎评估。
HTTP 请求节点是 N8N 中最通用、也最常被用作“兜底方案”的节点类型。它允许用户直接向任意 URL 发起 GET、POST、PUT、DELETE 等请求,自定义请求头、查询参数、认证方式和请求体,并对返回的 JSON 或 XML 进行解析。对于 N8N 没有原生节点的国内平台(如飞书、企业微信、微博),开发者通常需要查阅该平台的开放 API 文档,用 HTTP 请求节点手动完成鉴权(如获取 access_token)、构造请求和处理响应。这意味着额外的开发与维护成本,但也让 N8N 理论上可以对接任何提供 API 的服务。
三种部署方式:为什么推荐 Docker
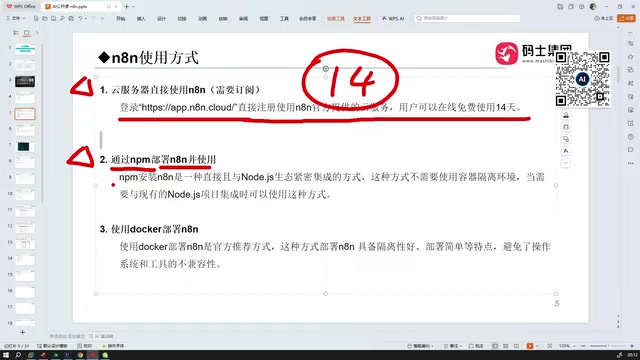
N8N 的使用方式主要有三种:在线云服务、NPM 原生部署和 Docker 部署。分享者对这三种方式给出了明确的倾向性建议。
在线云服务是最快捷的入门方式,用户直接登录 N8N 官网即可使用。但免费版本存在 14 天试用期,之后功能会受到限制,例如无法管理多个空间、缺少工作流执行历史看板等企业级功能。对于个人体验或轻量需求,在线版足够;但对于企业应用,付费或私有化部署更为合适。
NPM 原生部署需要用户自行安装 Node.js 环境并下载 N8N 源码,配置过程涉及依赖包管理,可能与现有系统环境产生兼容性问题,导致安装失败。分享者明确表示不推荐这种方式。
Docker 部署被分享者视为最优解。Docker 的隔离性良好,命令简单,且跨系统兼容性强,只要环境中有 Docker 即可运行。分享者建议 Docker 版本不低于 24.0.0,并推荐使用 Docker Compose 配合 YAML 文件来管理配置项,避免手动指定大量启动参数。
对于企业用户,私有化部署是更稳妥的选择。分享者提到,即使在企业内部,私有化部署 N8N 也没有问题,既能保障数据安全,又能获得完整的平台能力。
Docker Compose 是 Docker 官方提供的容器编排工具,通过一个 YAML 文件(通常命名为 docker-compose.yml)集中声明服务、镜像、端口映射、环境变量、数据卷和网络等配置。相比在命令行手动输入一长串 docker run 参数,Compose 文件可版本化、可复用、便于团队共享,一条 docker compose up -d 命令即可拉起整套服务。对 N8N 而言,Compose 还能方便地挂载持久化数据卷(避免容器重启后工作流丢失)、配置数据库连接和加密密钥等环境变量,是单机私有化部署的常见实践。
AI 智能体构建:N8N 与 AI 结合的三个重点
N8N 与 AI 的结合是本次分享的核心。分享者将重点归纳为三部分:AI Agent 节点、Chain 节点和工具节点。
AI Agent 节点用于构建智能体,使工作流具备自主决策和任务执行能力。Chain 节点则分为三类,分别处理不同的任务逻辑,并与 AI 集成以完成复杂流程。工具节点是 Agent 调用外部能力的桥梁,决定了智能体可以执行哪些具体操作。
这三部分构成了 N8N 构建 RAG(检索增强生成)系统和 AI 应用的基础。分享者提到,后续会通过案例演示如何利用这些节点搭建实际的 AI 系统,但由于分享内容以概述为主,具体案例细节并未展开。
从技术角度看,N8N 的 AI 集成路径与主流低代码 AI 平台类似,优势在于其底层工作流引擎的灵活性和节点生态的广度。开发者可以在同一个平台上完成数据处理、AI 推理和业务动作的编排,减少系统间的切换成本。
RAG(检索增强生成) 是一种将外部知识库检索与大语言模型生成相结合的技术架构。其基本流程是:先将文档切分并向量化存入向量数据库,当用户提问时,系统先检索出与问题最相关的若干文本片段,再将这些片段作为上下文一并送入大模型,由模型基于这些事实性材料生成回答。相比直接让模型凭参数记忆作答,RAG 能显著降低幻觉、支持私有知识、并便于更新知识而不必重新训练模型。在 N8N 中构建 RAG 系统,通常需要向量数据库节点(如 Pinecone、Qdrant)、嵌入模型节点、文档加载与切分节点,以及 AI Agent 节点来编排检索与生成的调用顺序。
选型建议与落地思考
N8N 适合需要高度定制化工作流、且业务场景与海外应用生态有交集的企业。对于国内企业,若核心业务依赖本土平台,则需评估自行封装节点的开发成本。部署方面,Docker Compose 是平衡易用性与可控性的推荐方案,私有化部署则更适合对数据安全有要求的企业环境。
分享者的内容偏重概念梳理和方向指引,AI 智能体的具体搭建案例着墨较少,读者若希望深入实战,还需结合官方文档和实际项目进行练习。N8N 的价值在于将通用自动化与 AI 能力融合在一个平台内,但能否发挥效用,取决于节点覆盖与业务需求的匹配程度。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。