n8n零基础入门:从核心概念到第一个自动化工作流

n8n入门:用三个心智模型和32个术语,把工作流自动化讲清楚、搭明白、面试答得出来
本文是基于n8n官方文档的入门系列第一集,目标不是带你点几下按钮,而是让你真正理解n8n的运行逻辑。文章围绕三个核心心智模型展开:工作流是节点链条(数据从左到右流经一系列单一职责的节点)、数据是条目列表(每个节点对每条数据各跑一次,循环是内置的)、IF节点按条目分流(不同条目走不同路径)。在此基础上,文章梳理了云端与自托管的选型逻辑、测试URL与生产URL的本质区别、fair-code许可的标准解释,并通过「线索分拣器」工作流串联了从手动触发到表单触发、从固定数据到调试执行记录的完整操作链路。最后以32个AI与平台术语词汇表收尾,用开卷考试比喻让RAG概念即时可讲。
你有没有想过,一个每周一早上重复的手工任务——把212份注册表格复制进电子表格、挨个回复客户——能不能让机器在你喝完咖啡之前就自动跑完?这正是n8n这类工作流自动化工具存在的意义。这篇基于n8n官方文档的入门课第一集,不只是教你拖几个方框按运行,而是让你能在面试和实际工作中讲清楚:为什么这么搭、什么会让它崩、怎么修。
n8n到底是什么
官方文档用三个短语定义n8n:工作流自动化工具、fair-code许可、内置AI能力。每个短语在面试里都值得拆开讲。
工作流自动化:一个工作流就是把「事件」变成「结果」的一系列步骤。表单提交了,客户收到回复;发票到期了,提醒自动发出;每周一早九点,报告自动出现在正确的文件夹里。自动化的意思是机器替人完成这些步骤——不是更聪明,而是不知疲倦、始终一致、速度够快。n8n让你把这些步骤画成由线连接的方框,画一次,之后每次事件触发都自动运行。
一个贴切的比喻是接力赛:发令枪是触发器(trigger),每个选手跑一棒再把接力棒交给下一个。在n8n里,选手是节点(node),接力棒是你的数据,没人独自跑完全程,也没人在棒子到达前抢跑。
fair-code:这和开源不是一回事,面试官特别爱考这个区别。源代码公开,你可以阅读、在自己机器上运行、在企业内部免费使用;但你不能把n8n本身当作托管服务卖给别人。
内置AI:n8n有语言模型、Agent、记忆、工具、向量存储的节点,一个AI步骤只是画布上又一个方框,紧挨着你的邮件节点。这也是n8n如今频繁出现在招聘需求里的原因。
记住一个三角形:n8n只做三件事——把数据拿进来(触发器)、改造数据(数据与逻辑节点)、把数据发出去(应用节点)。你遇到的每个节点都会落进这三个角之一。
三个必须刻进脑子里的心智模型
n8n里每一个让人困惑的瞬间,几乎都源于漏掉了下面三个概念之一。
概念一:工作流是节点的链条
每个节点只做一件事——读取表单、查找信息、做决定、发消息。数据从节点右侧离开,从下一个节点左侧进入,永远从左到右。第一个节点很特殊,它是触发器,在外部世界发生某事之前什么都不做。触发器就像门铃:房子整夜漆黑,直到有人按下按钮,灯才亮、门才开。一个触发器,一次运行。
概念二:数据是「条目」组成的列表
这是最容易绊倒新手的一点。沿着连线流动的数据不是一整块,而是一个条目(item)列表。三个人填了表单,就是三个条目,每个节点会对每个条目各运行一次——查找跑三次,判断跑三次。你永远不用写循环,循环是内置的。
想象超市收银台:收银员不会把整个购物袋当一件东西扫描,每件商品单独过扫描枪,三件商品三声「嘀」。三个条目,三次运行。底层上,n8n在节点间传递的是一个数组,每个元素是带有json键的对象,字段就住在里面,文件则走单独的binary键。
理解条目列表还需要知道一个常见陷阱:当某个节点只返回单个结果时(比如查询数据库找到一条记录),数据仍然是一个只含一个元素的列表,而非「一个对象」。这意味着你在表达式里永远要通过 $json 访问当前条目的字段,而非直接访问「那个对象」。多个条目并行处理也带来了副作用:如果第3个条目在某个节点报错,默认情况下整条运行会中断,第4、5个条目不再处理。n8n提供了「Continue On Error」和「Error Workflow」机制来应对这种情况——前者让节点跳过出错条目继续往下走,后者在整个工作流失败时触发一个专门的补救流程。这是生产环境部署时必须提前规划的问题,而不是上线后再补的功能。
概念三:不是每个条目都走同一条路
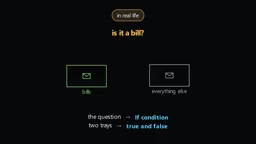
IF节点对每个条目问一个问题,然后把它送出两扇门之一——真或假。比如plan等于pro:是pro的走团队群通知,不是的走欢迎邮件。同一个工作流,不同路径,一次只对一个条目做决定。

节点怎么知道某个条目的邮箱地址?靠表达式(expression)——两个花括号加上你想要的字段。表达式就像婚礼请柬上的空白:你设计一张写着「宾客姓名」的卡片,每个信封填上各自的名字。
每次运行都被保存为一次执行记录(execution)。打开它,你能看到每个节点收到了什么、产出了什么。出错时——比如一条没有邮箱的提交——运行会在那里停下,节点变红,你能看到正是哪个条目把它弄崩了。执行记录就是工作流的黑匣子,出事不用猜,回放每一秒即可。
触发器 vs Webhook:触发器是任何能启动工作流的节点;webhook是触发器的一种——一个n8n监听的URL,外部系统发请求就能启动你的工作流。每个webhook都是触发器,但不是每个触发器都是webhook(定时和手动点击就不是)。
云端还是自托管
「Cloud vs Self-hosted」是面试必考题。
n8n Cloud:无需安装,注册即用,14天包含Pro功能的免费试用,之后选择starter、pro或enterprise套餐。托管、更新、备份、扩容都由n8n负责,代价是花钱和对机器少一点控制权。
自托管:你自己安装。免费的社区版几乎拥有完整功能,注册邮箱还能解锁文件夹、调试模式、自定义执行数据等额外功能。付费的business和enterprise版增加团队功能、单点登录、环境、项目、外部密钥等。
对现在正在学习的人,建议在自己机器上自托管:免费、是大多数公司实际使用的形态,而且亲手折腾一次安装能学到云端替你藏起来的东西。记法很简单——云端是租房,水管爆了打给房东但每月交租;自托管是买房,住着不花钱,但水管爆了你就是水管工。
安装前两个前置:NPX路径需要Node.js的近期LTS版本,Docker路径需要Docker Desktop或Docker引擎。三种安装方式——NPX一行命令最快、Docker在真实团队中最常见、Docker Compose适合长期运行。无论哪种,n8n都在浏览器localhost:5678打开,第一个界面让你创建管理员账户。
自托管除了成本优势,还有一个生产环境中更重要的理由:数据主权。当工作流处理客户的个人信息、财务数据或内部商业机密时,数据流经n8n Cloud意味着数据离开了你的网络边界,需要符合GDPR、HIPAA或行业合规要求。自托管可以把n8n部署在企业内网或私有云,数据全程不出边界。Docker Compose方式在团队中最为常见,原因正是它能与企业已有的容器编排基础设施(如Kubernetes)对接,并且通过环境变量文件(.env)统一管理数据库连接、加密密钥、执行数据保留天数等配置,方便运维审计和版本控制。
编辑器与你的第一个工作流
编辑器中间是画布(canvas),侧边是节点面板,顶部两个控制最关键:一个「测试」按钮当场运行一次,一个「激活」开关让工作流在生产环境中自动运行。测试是你按运行,激活是世界按运行。

打开任意节点都有三栏:左边输入(到达的条目)、中间参数(你告诉节点做什么)、右边输出(离开的条目)。你在n8n里的大部分时间都花在盯着这三栏。
动手搭建一个「线索分拣器」:
- 手动触发:新建工作流,搜索manual trigger加入,学习阶段最合适。
- 编辑字段(Edit Fields/Set):造点数据,加三个字段name、email、plan=pro,执行后在输出栏切换表格视图和JSON视图,注意包裹数据的json键。
- IF节点:条件
{{ $json.plan }}等于pro,执行后IF显示两个输出,true有一条,false零条。 - 两个结局:true分支设message为「welcome to pro」,false分支设为「thanks for joining」,真实项目里换成聊天和邮件节点即可。
- 测试并保存:点测试按钮看条目流动,每个节点显示通过的条目计数,保存并命名。
真正让它变真实的一步:把手动触发换成表单触发器(n8n自带表单,无需账户凭证),给它name、email和plan下拉(free/pro),直接连到IF。每个监听外部世界的触发器都有两个URL——测试URL只在你编辑器里按测试时有效,生产URL只在工作流激活时有效。测试URL是彩排,只有导演(你按测试)在场才运行;生产URL是正式演出,门一开就运行,不管你看不看。
专业技巧——数据固定(Pin Data):固定表单节点的输出,就能反复测试下游节点而不用每次重新提交表单,像游戏里的存档点。生产环境会忽略pin data,但上线前记得取消固定,免得过期测试数据造成混乱。
32个术语:面试题的来源
文档维护了32个术语的词汇表,面试官的问题常常直接从这类列表里抽取。分四组记忆,关键是记住每个术语旁边的「画面」而非措辞:
- 核心词:workflow、node、trigger node、canvas、editor、credential、expression、template、project、data pinning、evaluation。
- 集群节点:cluster node(根节点+子节点,如一个AI Agent加上模型、记忆、工具子节点)。
- 商业词:edition(自托管变体)、plan(云端套餐层级)、license、entitlement。
- AI词汇:LLM、AI completion、AI agent、AI chain、AI tool、AI memory、embedding、vector store、RAG、reranking、groundedness、hallucination、LangChain、API。

一个让RAG瞬间清晰的画面:模型独自作答就像闭卷考试的学生,连不会的题也自信满满地答——这就是幻觉(hallucination)。RAG把它变成开卷考试,同一个学生,但答题前能先查资料。RAG和groundedness的存在正是为了对抗幻觉。
fair-code的标准面试答案:源码可见、可自托管用于内部用途、免费,但不可作为托管服务转售。企业功能在单独的付费许可下。记住licenses会变,真要基于某工具创业,先读当前条款。
术语表中「RAG」(Retrieval-Augmented Generation,检索增强生成)值得单独展开。RAG的工作原理分三步:首先把你的私有文档切割成小块(chunk),通过embedding模型把每块文本转化为高维数字向量并存入向量数据库(vector store);当用户提问时,同样把问题转成向量,在向量数据库里做相似度搜索,找出最相关的几段原文;最后把这些原文片段连同用户问题一起塞进LLM的提示词,让模型「对着资料回答」。这就是开卷考试的具体机制。Reranking是RAG流程中的可选优化步骤——向量相似度搜索召回20个片段后,用一个专门的重排序模型对这20个片段重新打分,只取最相关的3个送给LLM,降低无关内容干扰模型推理的风险。
学习路径与下一步
文档推荐n8n Academy的互动课程(含练习、测验、结业考和证书),还提供练习用API,不需要注册其他服务的账户。这个系列不是替代品,而是陪在旁边的深度讲解。遇到问题先搜社区论坛,提问时附上导出为JSON的工作流,说清楚「期望什么 vs 实际发生了什么」——这个习惯本身就会让你显得像专业人士。
接下来的路线:build章节的工作流与节点深入、数据与条目、表达式、流程逻辑(IF/switch/merge/loop)、错误与调试、HTTP节点与API、凭证与安全、AI节点与Agent,最后是每集一个真实业务场景。
今日作业:凭记忆重建这个工作流,然后做三个变体——加第三个plan「team」和第三条分支;加第二个条件(plan是pro且邮箱以公司域名结尾);让false分支用wait节点等待10秒再继续。每个变体都会引出下一集要讲的内容。
这就是地基。你现在知道了n8n是什么、它怎么思考、怎么运行、怎么搭建和调试工作流,以及它词汇表里的每个词。真正让你被录用、并留住工作的,从来不是「搭出来」,而是能说清「为什么这么搭、什么会弄崩、怎么修」。
相关推荐

NFL为何重金押注旗帜橄榄球?安全与商业的双重博弈
NFL为何重金投资没有擒抱对抗的旗帜橄榄球?本文解析CTE脑病争议、女子体育数十亿美元市场与奥运机遇如何共同驱动联盟布局橄榄球的未来。

Asana浏览器智能体成本降76倍:GPT-6模型优化实测
Asana借助OpenAI的GPT-6 Astra模型与Codex工具,在浏览器智能体测试中将模型成本降低76倍、速度提升5倍。本文解读这一工程优化案例对企业AI落地的成本与性能启示。

@ai-sdk/vue 3.0.303 发布:依赖更新的补丁版本
@ai-sdk/vue 3.0.303 补丁版本发布,核心为依赖项同步升级,核心包 ai 升级至 6.0.303。本文解析该 Vue AI SDK 更新内容及对开发者的意义。