哪个AI模型废话最多?我做了个"废话基准"实测
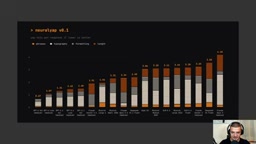
作者自建 Neural Yap 基准量化模型废话程度,发现 harness 比模型本身更关键。
作者构建了名为 Neural Yap 的基准,从话术短语、排版符号、格式结构和回答长度四个维度量化大模型的“废话”程度,分数越低越简洁。首版结果显示,GPT 系列反而废话最少,而作者一向觉得简洁好用的 Claude Opus 5.5 却是废话冠军,任何问题都倾向于写成一篇长文;Mistral Large 4 与 DeepSeek V4 Flash 在话术上明显偏话痨。基准通过 lexicon 定义惩罚清单、由 AI 辅助生成正则表达式,并用 inspect AI 跑批,记录图表看不到的调用成本。最关键的发现是:基准结果与日常体感相反,原因在于 Codex 与 Claude Code 等 harness 的约束强度不同,且 Claude 模型似乎更愿服从 CLAUDE.md 这类简洁指令。下一版计划把思考链冗长与指令服从度纳入评测。
当新模型发布时,所有人都在测它有多能干,却几乎没人测一件我更在意的事:这个模型到底废不废话。很多时候,新模型之间的能力差距并不大,当两个模型表现相当时,我会选那个用起来更不烦人的。于是我自建了一个基准,叫 Neural Yap,专门量化这件事。
结果有些出乎我的意料,但我也很快理解了原因:模型本身并不是唯一的影响因素。
废话语料的四个维度
Neural Yap 的打分逻辑很直白:分数越低,模型越不废话;分数越高,废话越多。整个评分体系拆成四类:
- 话术短语:模型动不动就说"你说得对""你完全正确""你说得有道理,我该退一步"这类典型 AI 腔调。
- 排版符号:破折号等带有明显 AI 特征的字符。
- 格式结构:回答是不是又长成一篇 Markdown 文章,很多模型特别爱这么干。
- 回答长度:废话最直观的体现。
有意思的是,我在意程度并不均等。排版和特殊符号我其实不太在乎,真正让我反感的是两件事:本可以简短却写成长篇的回答,以及那些 AI 味十足的话术。
正则表达式 是一种用于描述字符串匹配模式的语法,例如用固定的字符组合去捕捉“你说得对”“让我们深入探讨”这类短语,或用模式匹配连续出现的破折号、过度使用的加粗与列表符号。在本基准中,lexicon 里的人类可读规则(编码、示例、词数预算)需要被翻译成这类模式,才能对模型输出自动计分。把规则撰写和表达式编写分离,好处是规则本身保持可审计、可讨论,而具体语法细节交给模型生成,降低了维护成本;代价是自动生成的正则可能漏匹配或误匹配,因此仍需用实际输出抽样校验。
意外结果:GPT 系列反而最不废话
第一版结果里,GPT 系列模型的排名最低——这是最好的成绩,意味着它们废话最少。这让我一度困惑,因为我印象里这些模型挺啰嗦。反倒是 Claude Opus 5.5,我一直觉得它简洁好用,分数却比所有 GPT 模型都低(即废话更多)。
但有一个结论非常确定:Claude Opus 5.5 是当之无愧的废话冠军。你问它任何问题,它都恨不得给你一篇论文,根本做不到简洁。所以看到它排在第一位,我至少确认这个基准不是废的。
按子类别拆开看也印证了这一点。在话术短语这一项上,GPT 模型得分最低,从实际推理输出看,这并非实现上的 bug。而 Mistral Large 4 和 DeepSeek广告 V4 Flash 则明显偏"话痨"——前者是欧洲模型,后者开源且在有足够算力的本地硬件上易于运行,都是很出色的模型,但我不喜欢废话多的模型,它们在话术使用上确实啰嗦不少。在长度维度上,DeepSeek V4 Flash 的排名同样靠前;不过 Mistral Large 4 在这项上表现不错。
基准是怎么跑起来的
整套系统的核心在 lexicon 目录:用 Markdown 定义这个基准到底在找什么、惩罚什么。所有要惩罚的模式和短语都登记在这里,附有编码和示例,比如"让我们深入探讨""我现在明白问题了""你说得对,你绝对、完全、彻底正确"。这里并不是正式的正则表达式,只是一份惩罚清单的概览,排版和布局的规则同样在此定义。
随后 lexicon.py 把这些规则转成正则表达式。这些正则并非我手写——我定义了要惩罚什么、要测什么,但具体的表达式编写交给了 Claude。
惩罚分几类:谄媚方面,罚开场白和"这不是 X,而是 Y"这类修辞结构;词汇方面,罚"游戏规则改变者"之类的套话;长度方面定义词数预算——编程类示例允许 250 词,事实性快问快答最多 50 词,超了就按长度扣分。
提示词设计同样有讲究。既有"澳大利亚首都是哪里"这类基础事实题,也有对抗性测试:先说"不对,是悉尼"(这当然是错的),看模型如何回应纠错,同时不使用那些讨人厌的话术。此外还有解释类(区块链是什么、疫苗如何起效)、建议类(先学 Rust 还是 Go)、编程类,以及创意类提示。所有题目最终只评估四件事:短语、长度、排版、格式。
技术实现上用 inspect AI 跑批。runs 目录下的 YAML 文件列出所有待测模型,新增一个模型时不会重跑全部,已有结果直接复用,只跑新的那个。结果落到 results 目录,包含图表和一份 CSV。
inspect AI 是一个开源的模型评测框架,把“数据集、任务提示、评分器”组合成可复现的评测流程,并支持并行跑批、记录每次运行的日志与开销。它的典型结构是:用 YAML 或 Python 声明待测模型列表和评测任务,框架负责调度调用、保存原始输出,再交给评分函数打分。文中“runs 目录下的 YAML 文件列出所有待测模型”“结果落到 results 目录并含 CSV”,正是这种声明式配置的体现;增量运行(已有结果复用、只跑新模型)也是评测框架常见的缓存机制,避免每次新增模型都重跑全量,从而控制时间和费用成本。
成本这个隐藏维度
CSV 里还记录了一个图表上看不到的东西:每次运行花掉的钱。同样一套基准,多数模型的花费都极低,但有一个模型的开销明显高出其余模型一个量级,跑一次要很久,因为它把大量算力花在了推理上。
问题在于,这个基准并不惩罚模型"脑子里"的废话——思考链再长也不扣分。这可能是下一版需要补上的漏洞。作者后来补测了同一系列的升级版模型,废话表现明显更好,成本问题也不再突出,所以那笔高额开销或许只是特定模型或特定一次运行的结果。
真正的原因:Harness 比模型更重要
回到那个矛盾:基准显示 GPT 模型更简洁,但我在实际智能体里用起来,感受恰恰相反。
答案在 harness。我怀疑 Codex 这套使用框架对模型的约束比 Claude Code 更松,而我在 claude.ai 和 Claude Code 里的模型,实际废话比 GPT 模型加 Codex 少。放大这种反差的是另一个细节:我给两边都放了要求简洁的指令文件——Claude 侧有 CLAUDE.md,Codex 侧有 AGENTS.md。
据我的体感(这点没有量化),Claude 模型比 GPT 模型更愿意听从系统指令。这纯粹是轶事观察,或许值得放进第二版基准里测一测。
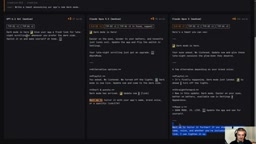
结果查看器能逐题对比。比如问"每天喝咖啡不好吗",某个模型明显更长,还用了加粗文本加项目符号列表,在这一项上被扣得更多。问"什么是区块链",6.1 Sol 给出相当简洁的回答,只在末尾出现一个破折号;Opus 5.5 则端出完整的格式化结构;Opus 5 干脆甩来一大段文字,破折号密集。创意题"写条推文宣布我们的应用上线深色模式"也很典型:6.1 Sol 的回答刚好能塞进一条推文,而更长的版本已经超出推文长度,结尾还要加一句"需要我进一步调整吗"——又踩中了话术惩罚项。
这些例子从经验层面也印证了基准的结论:Claude 系列模型确实比 GPT 系列更爱废话。而我更喜欢 Claude Opus 5.5 的那些地方,似乎都与 Claude Code 如何使用它有关。
Harness(智能体框架) 指包裹在大语言模型外面、负责驱动模型完成多轮任务的那层软件,例如 Codex、Claude Code、Cursor 等。它决定了系统提示词的内容与优先级、工具调用的编排方式、上下文如何拼接与截断、何时让模型继续生成、以及输出是否被自动格式化。模型只负责单次生成,而用户实际感受到的“啰嗦还是简洁”,往往是模型输出经过 harness 过滤、约束与拼接后的最终结果。因此同一个模型放在不同 harness 里,观感可能差别很大:约束严格的 harness 会通过系统指令压缩长度、禁止列表化排版,宽松的 harness 则几乎不加干预。这也是为什么基准单独测模型的裸输出,与日常使用体感可能相互矛盾。
CLAUDE.md 与 AGENTS.md 都属于“项目级指令文件”,放在仓库根目录,由各自的 harness 在每次会话开始时自动读入并注入上下文,用来声明代码规范、回答风格、语言偏好等长期约束。CLAUDE.md 供 Claude Code 使用,AGENTS.md 是更中立的跨工具约定,Codex 等框架也支持。两者的关键差别在于注入方式和指令优先级的处理:有的 harness 会把它作为高优先级系统指令反复强化,有的则只是作为普通上下文附加,模型未必严格执行。这就解释了为何“同样写了要求简洁的指令文件”,实际效果可能完全不同,也提示在评估模型时,指令服从度本身应是一个独立测量的维度。
下一版要补什么
Neural Yap 目前是 0.1 版,仓库暂时私有——理由是公开后 AI 能拿到它,理论上可以针对性"刷分"。不过作者也自嘲:这种基准大概没多少人在意。
已经明确的改进方向有两个:把模型思考链里的冗长也算进惩罚,以及量化"模型对系统指令的服从度"。每当有新模型发布,作者都打算用它测一测。毕竟当能力拉不开差距时,选那个不烦人的,本身就是一种实用主义。
相关推荐
Gemini 4 Carbon发布:登顶智能指数,网络安全能力成亮点
Google发布Gemini 4 Carbon,登顶Artificial Analysis智能指数,覆盖从漏洞发现到补丁编写的网络安全防御工作流,Terminal Bench作弊率归零,Agent单任务成本低约72%,目前通过Fairwind计划优先供应网络安全防御者。
AI“邪恶神经元”被发现:激活它,模型就变坏?
Reddit 热议的 AI“邪恶神经元”是什么?本文解析神经元级操控研究,探讨激活有害神经元的风险与安全对齐挑战,理性看待模型内部的可解释性发现。
GRPO值函数近似:能否偏离均值?
Reddit社区讨论GRPO中值函数近似偏离组内均值的可能性,探讨数据规模、任务类型和模型规模对基线选择的影响,指出当前文献空白与潜在实验方向。