Naive RAG 正在骗你:7 种能活到生产环境的 RAG 架构

不存在单一的高级 RAG,七种架构各修复一种检索失败模式,诊断失败再选工具才是生产级关键。
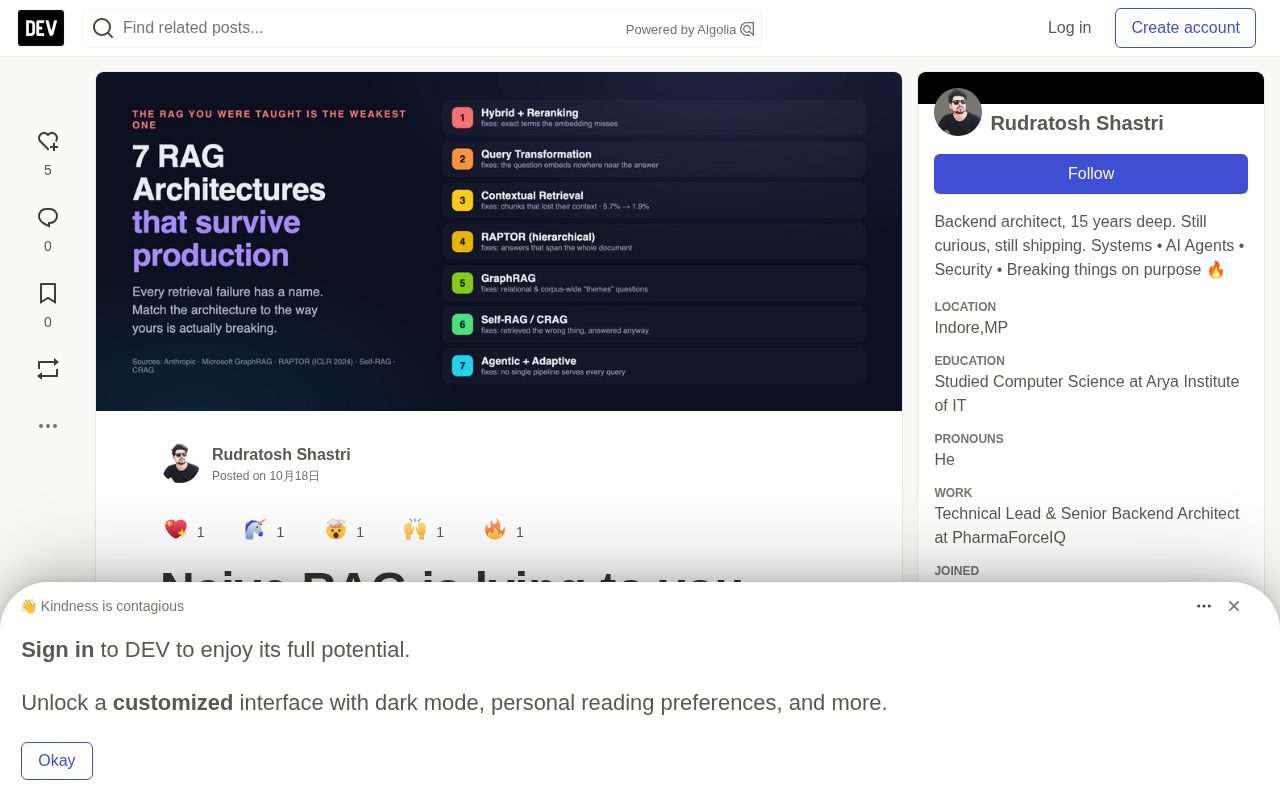
文章指出 Naive RAG 的失败并非流水线故障,而是它精确执行了错误的假设——把文档塞进向量库只是简单的一半。生产级 RAG 的核心工作是让正确的信息进入上下文窗口。文章首先归纳五种检索失败模式:词汇不匹配、上下文丢失、问题与答案嵌入距离远、答案跨整篇文档、检索到却依然是错的。随后逐一介绍七种针对性架构:混合搜索加重排序(基本盘)、查询变换(多查询、RAG-Fusion、HyDE、退步提示)、上下文检索(Anthropic 报告失败率从 5.7% 降至 1.9%)、RAPTOR 分层检索、GraphRAG、Self-RAG 与 Corrective RAG、智能体 RAG 与自适应路由。最后给出按顺序的落地决策规则,并警告所有数字来自各自论文而非统一基准,强调应用真实用户问题做自测。
为什么你精心搭建的 RAG 演示一上生产就垮?
每个团队的第一条 RAG 流水线几乎一模一样:切文档、做嵌入、按余弦相似度取 top-k、塞进提示词、让模型作答。演示效果惊艳,答案听起来也对,于是你上线了。
然后有人问了一个真正重要的问题,它取回了错误的文本块;或者找到了正确的文档,却漏掉了你真正需要的那一段;又或者答案明明躺在数据库里,模型却从未看到。
没有任何东西坏掉——流水线正在精确执行你设定它要做的事,这正是问题所在。你构建的是 Naive RAG,它不是没用,而是起点。把文档塞进向量库只是简单的一半,把正确的信息放进模型的上下文窗口才是真正的工作,而 Naive RAG 几乎没有尝试去做这件事。
本文的核心重构是:不存在单一的“高级 RAG”。存在七种截然不同的架构,每一种都因为检索以特定方式失败而存在。选错了,你只会白白增加成本和延迟。因此,在列架构之前,先学会命名失败。
检索失败的五种方式
原文列出了五种核心失败模式:
- 词汇不匹配:用户搜“如何取消”,文档里写的是“终止订阅”。语义搜索有助缓解,但精确术语、产品代号和名称仍会被漏掉。
- 上下文丢失:一个文本块写着“营收增长 3%”,但谁的?哪个季度?文本块被从文档中撕出来,嵌入向量对此一无所知。
- 问题不是答案:一个短问题与那段冗长、技术性的答案文本在向量空间里相距甚远,向量根本对不上。
- 答案就是整篇文档:“总结这 400 份报告的主题”无法靠任意 5 个文本块回答,再大的 top-k 也够不着。
- 检索到了,但依然是错的:系统取回了看似合理但不含答案的文本块,模型却自信地据此作答。
下面的每种架构针对其中一到两种失败模式。匹配好它们,你就能停止盲目堆砌你不需要的复杂度。
1. 混合搜索 + 重排序
修复:词汇不匹配
这是所有人在追求更花哨的东西之前都应该做的升级,而大多数人为追逐 agent 跳过了它。
纯向量搜索是语义的:擅长把“取消”匹配到“终止”,却对错误码或罕见姓氏这类精确匹配无能为力。混合搜索同时运行稠密向量搜索和经典关键词搜索(BM25),并融合结果,通常使用倒数排名融合(Reciprocal Rank Fusion),其做法是对每个文档出现在各列表中的排名求和 1 / (k + rank)。稠密检索捕捉含义,BM25 捕捉被嵌入平滑掉的字面 token。
然后做重排序。检索为速度而调优,因此会过量取回(比如 150 个候选),再由更慢的交叉编码器针对查询重新打分,保留最好的 20 个。交叉编码器同时读取查询和文档,因此能捕捉到双编码器嵌入遗漏的相关性。
何时使用:永远。这是基本盘,不是高级技巧。如果你的 RAG 没有重排序器,先修这个再往下读。
BM25 是一种基于词频的经典检索算法,属于稀疏检索家族。它通过三个因素给文档打分:查询词在文档中出现的频率(TF)、该词在整个语料库中的稀有程度(IDF),以及文档长度归一化。与稠密向量不同,BM25 不做任何语义泛化,因此对精确的 token 匹配——错误码、产品型号、罕见姓氏——极为敏感。它的局限在于无法处理同义词和改写,这正是需要与向量搜索融合的原因。
交叉编码器(Cross-Encoder) 与双编码器(Bi-Encoder)的核心区别在于输入方式。双编码器分别将查询和文档编码为向量,再计算余弦相似度,速度快但丢失了细粒度的交互信息。交叉编码器则将查询和文档拼接后一起送入 Transformer,让注意力机制在两者之间充分交互,从而捕捉更深层的相关性信号。代价是无法预计算文档表示,每个查询-文档对都需要一次前向传播,因此只适合对少量候选做精排。
2. 查询变换
修复:问题不是答案
用户写下一个简短、混乱的问题,它的嵌入与答案相距甚远。那就在搜索之前改写问题。四种变体:
- 多查询:让 LLM 用 3-4 种方式重述问题,分别检索后合并,捕捉原始查询遗漏的角度。
- RAG-Fusion:多查询加上对合并结果的倒数排名融合。在多次重述中反复出现的文档会浮上来。原始工作提醒:如果生成的查询跑偏,答案也会跑偏。
- HyDE(假设性文档嵌入):不去嵌入问题,而是让 LLM 写一个假的答案,再用它嵌入搜索。假设性答案看起来比问题更像真实文档。它可能幻觉出糟糕的假设,因此要搭配重排序。
- 退步提示:对一个窄问题,先问一个更一般的问题(“X 背后的原则是什么?”),检索背景,再回答具体问题。
何时使用:当正确的文档存在,但查询找不到它们时。成本低,只多一次 LLM 调用。
3. 上下文检索
修复:上下文丢失
切分文档时,每个文本块都丢失了周围的故事。“营收增长 3%”若没有“ACME 公司,Q2 2026”,毫无用处。Anthropic 的上下文检索在每个文本块前加上一段 LLM 生成的简短说明,在嵌入之前将它放回文档语境,使向量索引和关键词索引都携带上下文。
这是本文中唯一有干净公开数字的架构。衡量“正确文本块不在 top 20 中”的查询比例:
| 配置 | 失败率 | 降低幅度 |
|---|---|---|
| 基线(Naive RAG) | 5.7% | — |
| + 上下文嵌入 | 3.7% | 35% |
| + 上下文 BM25 | 2.9% | 49% |
| + 重排序 | 1.9% | 67% |
使用提示缓存时,成本大约为每百万文档 token 1.02 美元,一次性。一个诚实的提醒:这些数字来自 Anthropic 测试中表现最好的嵌入模型,而非平均水平。尽管如此,一个预处理步骤带来 5.7% → 1.9% 的提升,是整个列表中回报最高的之一。
提示缓存(Prompt Caching) 是上下文检索成本可控的关键机制。在为标准文本块生成上下文说明时,需要将整篇文档作为提示词的一部分反复送入 LLM。如果每次调用都重新处理全文,成本会随文档数量线性膨胀。提示缓存允许将文档内容在服务端缓存,后续调用只需为新增的文本块付费,从而将上下文生成的一次性成本压到约每百万文档 token 1.02 美元。这一机制由 Anthropic 等厂商提供,也是该架构在经济上可行的前提。
4. 分层检索(RAPTOR)
修复:答案就是整篇文档
扁平切分假设答案存在于一个段落中。对于“这份 80 页报告的总体论点是什么”,没有单个文本块能承载。RAPTOR 构建一棵树:聚类相关文本块,为每个簇生成摘要,再聚类摘要并摘要,一路向上。查询时跨层级检索,既能抓取细粒度细节,也能获取高层综合。
论文报告称,在 QuALITY 基准(长文档问答)上搭配 GPT-4 时,绝对准确率提升约 20 点,当时达到最先进水平。请将其视为论文在其数据集上的结果,而非对你语料的承诺。
何时使用:问题跨章节的长结构化文档——合同、研究论文、财报、技术手册。对 FAQ 来说是大炮打蚊子。
5. GraphRAG
修复:关系型和语料库级问题
向量 RAG 对关系视而不见。“这两个人如何关联”、“所有事件报告中贯穿哪些主题”——这些不是相似性问题,top-k 找不到它们。微软的 GraphRAG 用 LLM 提取实体和关系构建知识图谱,然后运行社区检测(Leiden 算法)聚类图结构,并自底向上预摘要每个簇。
两种模式:局部搜索从问题附近的实体出发在图上游走(便宜,通常一次 LLM 调用)。全局搜索通过对所有社区摘要做 map-reduce 来回答“主题是什么”,强大且昂贵——一个追踪记录显示,单次全局查询需要 10+ 次 LLM 调用和约 20 万 token,而局部查询约 11,500 token。
代价:索引。构建图需要对语料库进行数百次 LLM 调用,且是前置的。微软后来推出了 LazyGraphRAG 来削减这一成本。当关系与全局综合是真正的工作、且语料库足够稳定可以摊销索引成本时使用它。别把它放在客服台前面。
Leiden 算法 是一种用于社区检测的图聚类算法,是 Louvain 算法的改进版本。它通过迭代优化模块度(modularity)将图中的节点划分为若干社区,使得社区内部连接紧密、社区之间连接稀疏。在 GraphRAG 中,Leiden 算法被用来将知识图谱中的实体和关系聚类成语义社区,每个社区对应一个主题簇,再由 LLM 自底向上生成摘要。相比 Louvain,Leiden 能保证社区内部连通性,避免出现碎片化的不合理分组,这使得生成的社区摘要质量更高、更适合作为全局搜索的检索单元。
6. Self-RAG 与 Corrective RAG
修复:检索到了,但依然是错的
有时检索返回自信的垃圾,模型却照单全收。这两种架构增加了一道检查。
Self-RAG 训练模型发出“反思 token”:它决定是否检索,判断每个段落是否相关,并批判自己的答案是否真的被支持。判断内嵌于模型之中。
Corrective RAG (CRAG) 把判断放在外面:一个轻量评估器将检索到的文档评分为正确、模糊或错误。分数差时它不会硬着头皮往前,而是触发后备方案(通常是网络搜索)先找更好的来源。它比需要训练 token 的 Self-RAG 更容易嫁接在现有流水线上。
何时使用:高风险答案,自信的错误比“我无法验证”更糟的场景——客服、合规、医疗、法律。每次查询额外延迟,因此留给值得的问题。
7. 智能体 RAG(与自适应路由)
修复:没有单一流水线服务所有查询
上面六种是工具,智能体 RAG 是挑选并串联它们的流程。代替一次性检索后作答,agent 做规划:决定查什么、检索、检查是否足够、用更好的查询再检索、也许调用第二个索引、在回答前验证。多步问题成为可能。
危险在于:对每个查询都运行 agent 循环又慢又贵,而大多数问题并不需要。这就是为什么新兴的 2026 默认是自适应 RAG:一个廉价的分类器坐在前面,把每个查询路由到能回答它的最轻量流水线。简单查找 → 混合搜索;关系型 → 图;多步 → agent。只有当问题要求时才为复杂度付费。
自适应 RAG(Adaptive RAG) 的核心是一个轻量级查询分类器,通常在 LLM 调用之前运行。它根据查询的复杂度、类型和所需信息结构,将请求路由到最合适的检索流水线——简单事实查找走混合搜索,关系型问题走图检索,多跳推理走智能体循环。分类器本身可以是小型模型或规则系统,成本远低于让所有查询都走最重的路径。这一模式的意义在于将“按需付费”从口号落地为架构决策:复杂度只在问题真正需要时才被引入,而非默认开启。
全景图与落地决策
| # | 架构 | 修复的失败 | 成本 |
|---|---|---|---|
| 1 | 混合 + 重排序 | 嵌入遗漏的精确术语 | 低 · 永远做 |
| 2 | 查询变换 | 问题嵌入远离答案 | 低 · 多 1 次调用 |
| 3 | 上下文检索 | 丢失上下文的文本块(5.7%→1.9%) | 约 1 美元/百万 token,一次性 |
| 4 | RAPTOR(分层) | 答案跨整篇文档 | 中 · 索引 |
| 5 | GraphRAG | 关系型与语料库级“主题”问题 | 高 · 索引需数百次调用 |
| 6 | Self-RAG / CRAG | 检索错了还硬答 | 中 · 每查询额外调用 |
| 7 | 智能体 + 自适应 | 没有单一流水线服务所有查询 | 不定 · 按需付费 |
诚实的选择规则,按顺序:
- 所有人:混合搜索 + 重排序。跳过这个,其他都不重要。
- 召回仍有斑块? 加查询变换,多一次调用。
- 文本块丢失含义? 加上下文检索,列表中性价比最高。
- 问题跨整篇文档? RAPTOR。
- 问题关系型或语料库级? GraphRAG,前提是负担得起索引。
- 自信的错误答案伤害大? CRAG 或 Self-RAG。
- 一个产品有多种查询类型? 在前面放自适应路由,让它分发。
关于数字的一个警告:上下文检索的下降、RAPTOR 的 QuALITY 增益、GraphRAG 的 token 成本,都来自各自的论文和厂商文章,并非一次受控的面对面基准测试。没有一项干净的 2026 研究在同一语料库上运行全部七种。将它们视为方向性指引,并运行唯一能决定一切的基准:从你自己的用户那里取十个真实问题,定义什么算正确答案,然后针对那个测试各种架构。
区分玩具演示和生产级 RAG 的技能,不是知道最花哨的架构,而是诊断五种失败中哪一种是你面临的,然后伸手去拿修复它的那件工具。Naive RAG 曾无声地让你失败,修复从命名失败方式开始。
参考来源:Anthropic《Introducing Contextual Retrieval》;Sarthi 等 RAPTOR(ICLR 2024);微软 GraphRAG;Asai 等 Self-RAG(arXiv:2310.11511);Yan 等 Corrective RAG(arXiv:2401.15884);Rackauckas RAG-Fusion(arXiv:2402.03367);Gao 等 HyDE(2022)。数据均为各自来源报告的结果,并非统一基准。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。