Nari推出Qwen3-TTS与Qwen3-ASR:高精度低延迟语音方案
Nari推出基于Qwen3的TTS与ASR配套语音模型,主打高准确率、低延迟、低成本三大指标。
Nari在Hacker News发布了一套基于阿里云开源大模型Qwen3的语音技术组合,包含文本转语音(TTS)和自动语音识别(ASR)两个配套模型,目标是同时优化准确率、延迟和成本这三项语音产品的核心工程指标。将Qwen3的强大语言理解能力引入语音领域,有助于在上下文层面提升合成与识别质量,区别于Whisper等纯音频架构路线。两款模型作为完整闭环推出,让开发者无需跨多个供应商拼凑技术栈。不过,当前性能指标主要来自项目方自述,尚缺乏与Whisper、主流云厂商API的横向基准对比,仍处于早期社区验证阶段。
Nari带来新的语音模型组合
在Hacker News的Show HN板块,一款名为Nari的语音技术产品引起了关注。该项目主打两个核心模型:基于Qwen3的文本转语音(TTS)和自动语音识别(ASR)方案,宣称在准确率、延迟和成本三方面均有出色表现。
对于开发者而言,语音相关的应用长期面临一个难以绕开的三角权衡:想要高准确率往往意味着更大的模型和更高的推理成本,而追求低延迟又可能牺牲识别质量。Nari将Qwen3-TTS与Qwen3-ASR打包推出,试图在这三个维度之间找到更好的平衡点。
Qwen3底座的语音应用
这两款模型都建立在Qwen3系列之上。Qwen3作为通义千问的开源大模型家族,近年来在文本理解与生成能力上积累了不错的口碑。将其能力延伸到语音领域,是一个自然的演进方向。
TTS(文本转语音) 负责将文字内容合成为自然流畅的语音输出,这类技术广泛应用于语音助手、有声读物、无障碍工具等场景。ASR(自动语音识别) 则是反向过程,把音频转写为文本,是语音输入、会议记录、字幕生成等应用的基础组件。
Nari将两者作为配套方案提供,意味着开发者可以构建完整的语音交互闭环——从用户说话(ASR识别)到系统回应(TTS合成),无需在多个供应商之间拼凑技术栈。
准确率、延迟与成本的三重诉求
项目标题中直接点明了三个卖点:high accuracy(高准确率)、low latency(低延迟)和 low cost(低成本)。这恰好对应了语音产品落地时最受关注的三项工程指标。
低延迟对实时交互场景尤为关键。在语音对话、实时字幕等应用中,哪怕几百毫秒的延迟也会明显影响体验。而成本控制则直接决定了产品能否规模化——对于需要处理海量音频的企业应用来说,单位成本的降低往往意味着商业模式的可行性。
提一嘴,这些指标目前主要来自项目方的自述,具体的基准测试数据、与主流方案(如Whisper、各大云厂商语音API)的横向对比,仍有待社区进一步验证。Show HN帖子目前获得的关注度有限(8分、1条评论),说明它还处于早期曝光阶段。
对开发者意味着什么
对于正在寻找语音技术方案的团队,Nari的Qwen3语音组合提供了一个值得留意的选项,尤其是那些希望基于开源生态、避免被单一云服务锁定的开发者。
如果你正在评估语音技术选型,建议关注几个实际问题:模型是否开源可自部署、多语言支持情况、并发处理能力,以及在你的具体音频质量条件下的真实识别准确率。这些细节往往比宣传口径中的通用指标更能反映实际可用性。
随着Qwen3生态的持续扩展,围绕它构建的垂直应用会越来越多。语音作为人机交互的重要入口,这类基于强大文本底座的语音方案,未来的空间值得期待。
相关推荐
Krea 2 图像生成工作流入门:新手如何理清 LoRA 与 Checkpoint
针对 Krea 2 图像生成新手的入门指南,解析如何从免费开源工作流起步,理清 Civitai 上 LoRA 与 Checkpoint 的分工,并掌握写实图像一致性生成的关键技术要点。
Agent评估框架深度解析:自建还是采用现成工具?
深入解析Agent评估框架(eval harness)的四大核心组件——测试用例、执行器、捕获层与评分器,并探讨自建与采用现成框架的决策标准,助力AI工程团队构建可靠的智能体评估体系。
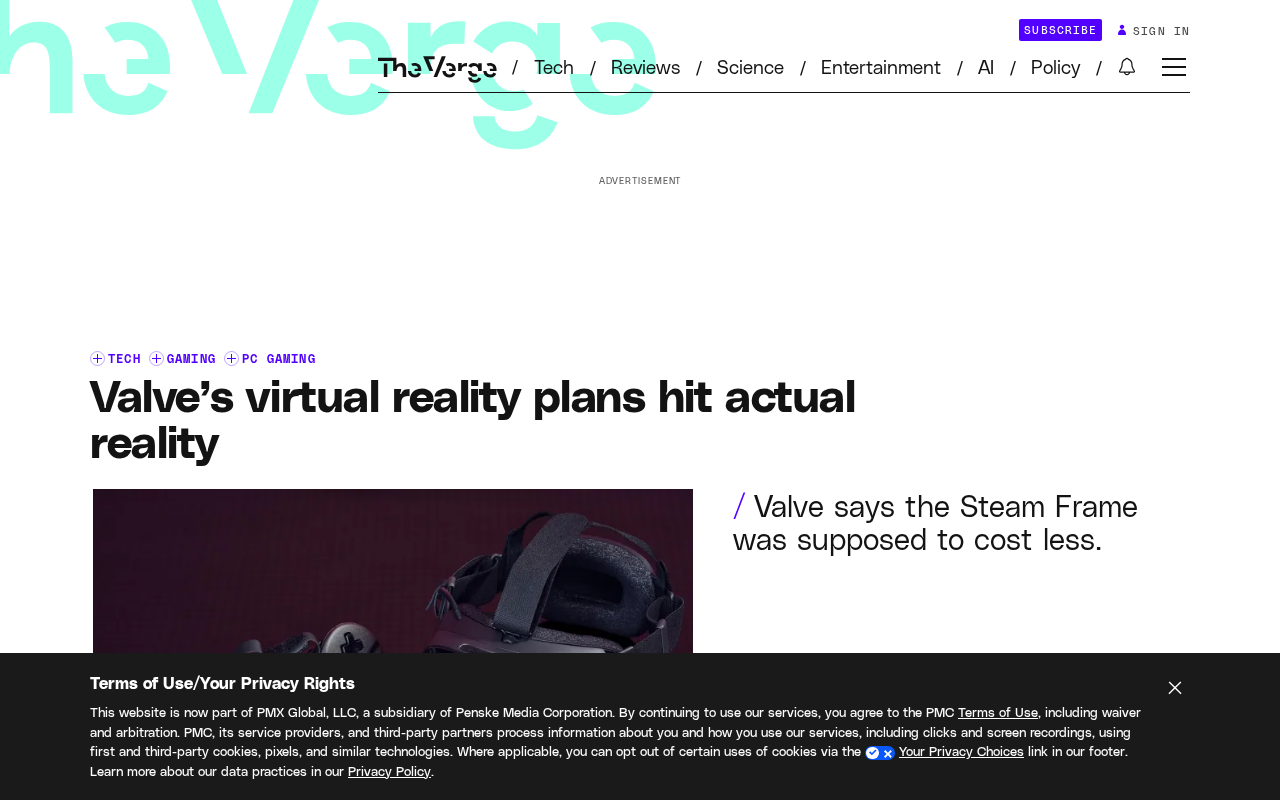
Valve Steam Frame头显:内存涨价打乱定价计划
Valve Steam Frame头显正式发布,但因全球内存和存储市场涨价,定价被迫超出原计划的1059美元。本文解析供应链成本压力如何影响VR硬件定价及行业趋势。