#语音识别
共 59 篇相关文章
AI为何走向本地?Moonshine Voice作者Pete Warden深…
AI为何走向本地?Moonshine Voice作者Pete Warden深度解析
Moonshine Voice创造者Pete Warden探讨AI本地化趋势,分析延迟、隐私、成本与可靠性四重驱动力,以及本地优先设计对开发者和产品团队的意义。
SLAM-ASR语音识别背后的归纳头机制
研究发现SLAM-ASR语音识别模型依赖冻结语言模型中的归纳头机制,将语音嵌入映射到转录token,并发现差分注意力对可抑制噪声。这解释了小型映射层为何足以实现竞争性识别性能。
Sada-ASR:面向阿拉伯语多方言的生产级语音识别系统
Sada-ASR 是 EchoNova 的生产级阿拉伯语多方言语音识别系统,在 120 小时测试集上以 11.69% 词错误率领先 Microsoft、Google、OpenAI 等十二套系统,并开源 20 小时测试子集与评分代码。
B站直播翻车实录:当AI语音识别遇上真实闲聊
从B站一场三小时闲聊直播的语音转写文本出发,分析ASR在口语化、跨话题、多人互动场景下的识别瓶颈,探讨语音AI落地的真实水位与改进方向。

Siri联合创始人押注Helix语音ID技术
Siri联合创始人投资Helix语音ID技术,该技术可在iPhone 13上本地运行,为语音生物识别在存量设备上的普及扫清硬件障碍。本文分析其技术信号、落地场景与安全挑战。
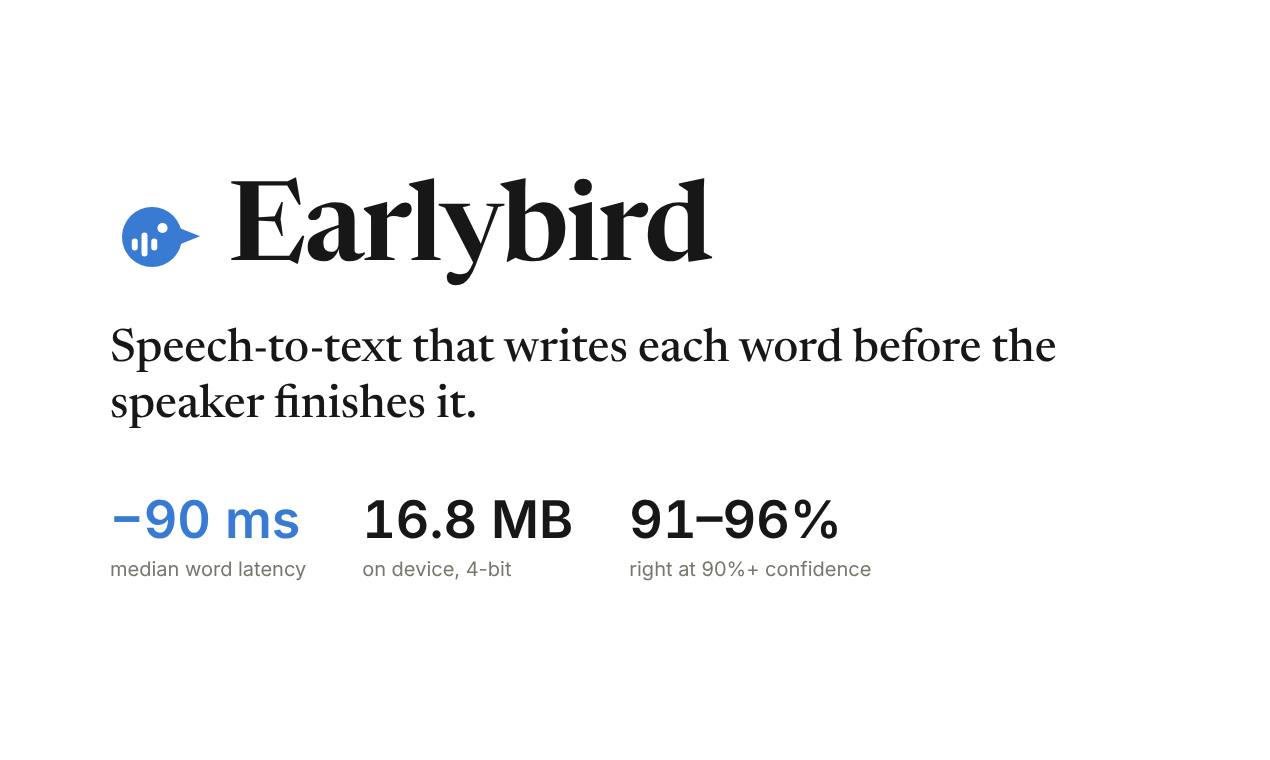
Earlybird:提前90ms预测单词的语音识别模型
Earlybird 是一款 29M 参数、17MB 的端侧语音转文字模型,能在单词结束前约 90 毫秒预测输出,并附带逐词置信度,专为需要更快响应的语音代理设计,开放权重与代码。

OTPM:微调语音分离模型的无训练诊断指标
研究提出无训练诊断指标OTPM,基于语言识别后验概率预测口语语言分离模型微调后的性能增益,在合成双语数据上相关系数0.56,真实语料0.23。
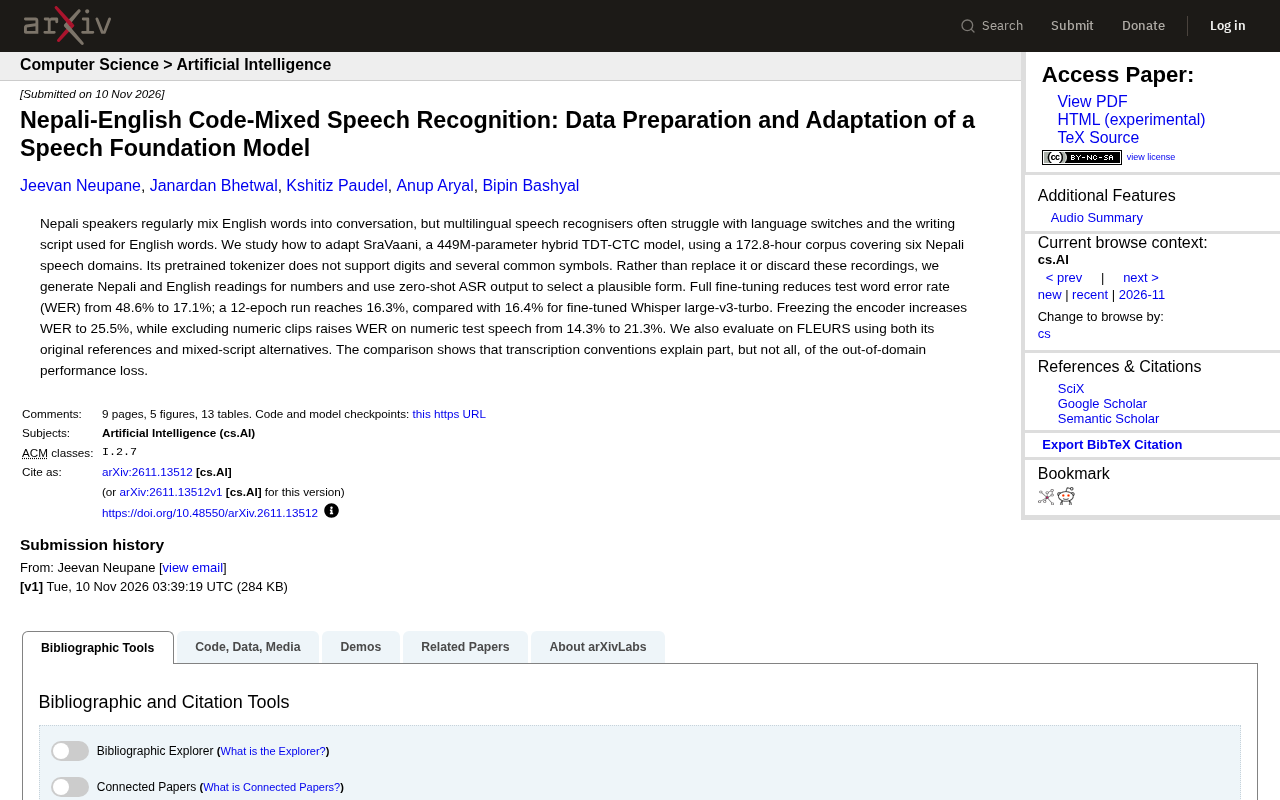
尼泊尔语英语混码语音识别:数据准备与模型适配实战
本文解析尼泊尔语-英语混码语音识别研究:基于172.8小时语料适配SraVaani模型,全量微调将WER从48.6%降至17.1%,并探讨数字处理与转写约定对性能的影响。
微软Paza研究:非洲语言语音识别如何突破架构与数据瓶颈
微软Paza研究系统评估53个语音模型在39种非洲语言上的表现,揭示架构选择比预训练覆盖更关键、200-300小时为实用数据门槛,以及语言类型学对识别性能的深层影响。

Otter AI 支持30+语言,跨语言对话追踪即将上线
Otter AI 新增27种语言支持,总覆盖超过30种语言,并预告跨语言对话追踪功能:说话者切换语言时仍可持续转写。本文分析该更新的实际价值、适用场景与多语言转写赛道的竞争逻辑。

KeyASRBench:ASR关键词保留率的新衡量标尺
KeyASRBench提出基于整短语标注的关键词错误率KER,在中英双语10小时、1501条片段上评测ASR关键词保留能力,揭示低WER系统KER高达33.81%的结构性差距。

Sage2:实时语音转结构化数据,开发者API新选择
Levanto Labs 推出 Sage2 API,可将实时语音转化为结构化数据,支持流式决策跟踪用户意图,适用于客服、语音助手等场景。Product Hunt 获 99 票。

Soniox STT v6发布:为语音Agent加入文本输入与回声过滤
Soniox发布STT v6语音识别模型,支持将语音Agent的文本作为输入上下文,用于提升短回复识别准确率并过滤Agent自身语音回声。提供stt-rt-v6流式与stt-async-v6异步两种接口。

31.6M参数土耳其语音识别模型:ufakzeka-kulak开源发布
ufakzeka-kulak 是一个 31.6M 参数的开源土耳其语语音识别模型,基于 FastConformer 和 TDT,Apache-2.0 许可。在 FLEURS 和 Common Voice 上 WER 优于 Whisper base/small,本文解读其训练数据筛选、评估设计与应用场景。
英伟达开源Nemotron 3.5 Transcribe:30B MoE语音模型
英伟达发布 Nemotron 3.5 Transcribe 开源语音大模型:30B MoE 架构、约 4B 激活参数,支持 40 种语言转写,英文 Open ASR Leaderboard 平均 WER 4.71%,并原生集成说话人标签与词级时间戳。
NVIDIA Nemotron 3.5 Transcribe发布:40语言、1小时录音、开源权重
NVIDIA发布Nemotron 3.5 Transcribe语音转写模型,支持40种语言、最长1小时录音、提示词引导转写、说话人标签和音频问答,权重以BF16/FP8/NVFP4开放,发布首日即通过vLLM和NeMo Speech提供推理服务。
让机器学会倾听:Paris Smaragdis的超人听觉研究
伊利诺伊大学教授Paris Smaragdis研发具有超人听觉的计算机系统,应用于语音识别、音乐理解和环境监测。本文解析机器听觉的技术内涵、研究路径与应用前景。

ExecuTorch 如何优化 Arm 边缘设备流式语音识别
PyTorch 官方博客分享如何用 ExecuTorch 在 Arm 边缘设备上优化流式语音识别,分析流式 ASR 与批量转写在延迟、状态管理上的差异,以及端侧部署的优化思路。