内存有限的家用服务器该用ZFS吗?RAM需求真相解析
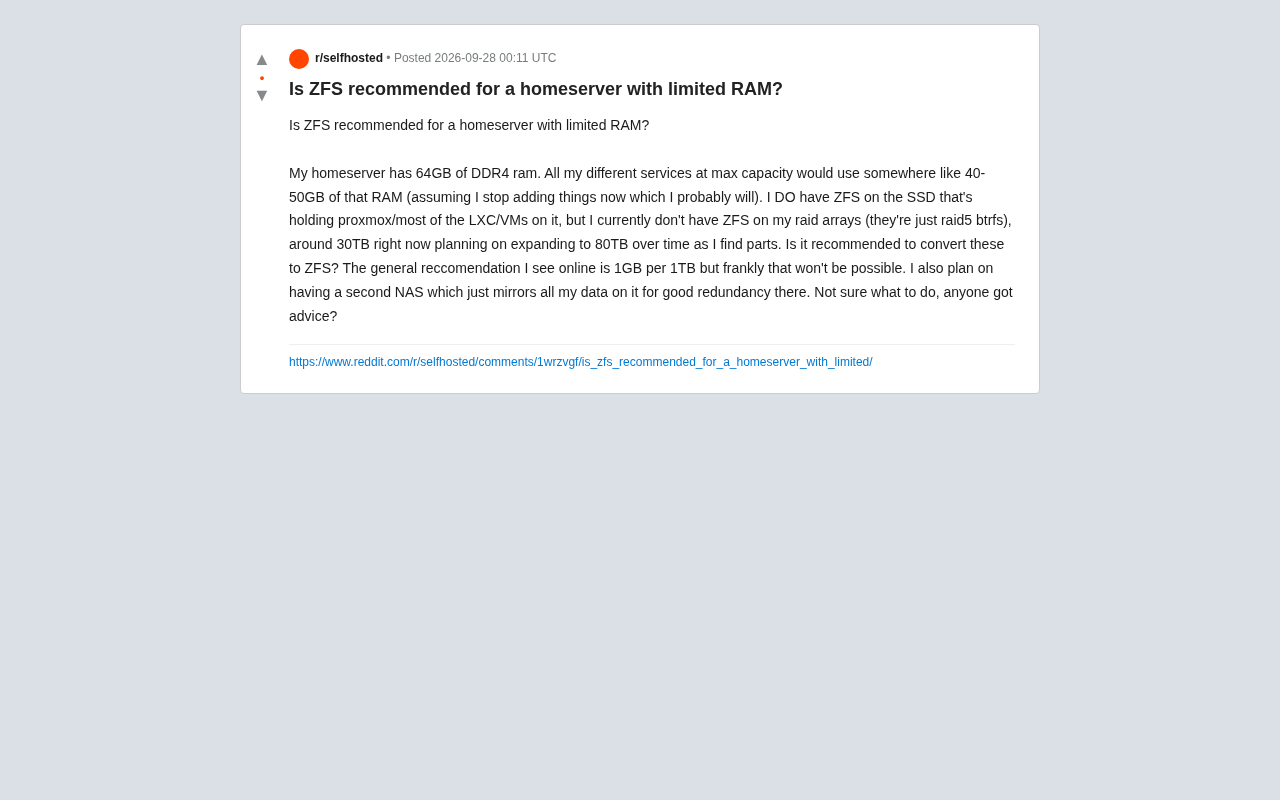
64GB内存跑80TB的ZFS完全可行,「1GB/1TB」只是去重场景的误传,迁移的真正价值在于摆脱btrfs RAID5的写洞风险。
一位拥有64GB内存、计划将存储扩展至80TB的家用服务器用户,因担心「1GB内存/1TB存储」的经验法则而犹豫是否迁移至ZFS。文章指出这条法则仅适用于开启了去重(dedup)功能的场景,普通家用NAS无需去重,ZFS的ARC缓存机制是弹性的,可通过`zfs_arc_max`手动限制以保留足够内存给应用服务。更关键的迁移理由在于数据可靠性:btrfs RAID5存在长期未修复的写洞(write hole)问题,官方已不推荐用于生产环境,而ZFS RAIDZ在校验与防写洞方面成熟可靠。文章同时提醒需提前规划vdev扩容路径,并强调RAID不等于备份,第二台镜像NAS才是数据安全的最终保障。
一个真实的家用服务器困境
在 Reddit 的家庭实验室(homelab)社区里,一位用户抛出了让许多自建服务器玩家纠结的问题:他的家用服务器配备了 64GB DDR4 内存,各类服务满载时会占用 40-50GB,剩余空间并不宽裕。系统盘(承载 Proxmox 及大部分 LXC/VM)已经使用了 ZFS,但存储阵列目前是 30TB 的 btrfs RAID5,未来计划扩展到 80TB。
他的核心疑问是:网上普遍流传「1TB 存储需要 1GB 内存」的说法,按这个标准,80TB 存储就要吃掉 80GB 内存——这对他的机器来说根本不现实。那么,内存有限的情况下,到底该不该把阵列转成 ZFS?
「1GB per 1TB」这条规则被误解了多久
这条广为流传的经验法则其实是家用服务器领域最大的误区之一。它的真正来源是启用了去重(deduplication)功能的 ZFS 场景。去重需要维护一张庞大的 DDT(去重数据表),这张表必须常驻内存才能保证性能,而它的体积确实与数据量线性相关,因此才有了「每 TB 需要数 GB 内存」的高要求。
关键在于:绝大多数家用场景根本不需要开启去重。 一旦关闭去重,ZFS 对内存的硬性需求就大幅下降。ZFS 会尽可能多地使用空闲内存作为 ARC(自适应替换缓存)来加速读取,但这是「能用则用、需要就让」的弹性机制,而非「必须占满」的刚性门槛。
换句话说,帖主担心的「80TB 要 80GB 内存」是把去重场景的极端要求错套到了普通存储场景上。对于不开去重的家用 NAS,ZFS 完全可以在有限内存下稳定运行。
DDT(去重数据表,Deduplication Table)是 ZFS 去重功能的核心索引结构,它为每一个去重块存储一条哈希记录及引用计数。由于 ZFS 在写入时必须实时查询 DDT 来判断数据是否已存在,这张表若不能完整驻留在内存中,每次写入都会触发磁盘 I/O,性能会急剧劣化到不可用的程度。实际测量中,DDT 的内存占用大约为每 TB 唯一数据 2-5GB,这正是「1GB/1TB」说法的来源——部分早期文档甚至给出更高的保守估计。值得注意的是,去重在家用媒体存储(视频、照片等)场景中收益几乎为零,因为这类文件本身重复率极低,开启去重只会白白消耗内存而不能节省任何空间。
ZFS 在内存受限环境下如何工作
ARC 缓存是弹性的,不是刚需
ZFS 的 ARC 默认会占用约一半的系统内存,但这个上限是可以手动调整的。在内存吃紧的机器上,可以通过设置 zfs_arc_max 参数把 ARC 限制在一个较小的范围,避免它和你的服务(那 40-50GB 的应用负载)抢内存。缓存变小的代价只是读取命中率下降、性能略有损失,并不会导致数据丢失或功能异常。
什么时候内存才真正紧张
对帖主这台机器而言,64GB 内存扣掉 40-50GB 服务占用,还剩十几 GB 可供 ZFS 使用。对于以大文件、媒体存储为主的 NAS 用途,十几 GB 的 ARC 已经能带来不错的缓存效果。真正会让内存捉襟见肘的,是同时满足以下条件:开启去重、大量小文件随机读写、且要求极高的持续性能——这显然不是普通家用存储的画像。
从 btrfs RAID5 转 ZFS,值不值得
这里有一个比内存更值得关注的技术点:帖主目前用的是 btrfs RAID5。btrfs 的 RAID5/RAID6 长期以来存在著名的「write hole」(写洞)问题,官方文档也标注其为不稳定、不建议用于生产数据。相比之下,ZFS 的 RAIDZ 在这方面成熟可靠得多,具备完善的校验、自愈和防写洞机制。
从数据完整性角度看,从 btrfs RAID5 迁移到 ZFS RAIDZ 是一次实质性的可靠性升级,这个理由比「要不要用 ZFS」的内存讨论更有分量。
不过迁移并非无痛:ZFS 的 vdev(虚拟设备)扩展一直不如 btrfs 灵活。虽然 ZFS 近年加入了 RAIDZ 扩展能力,但规划池结构时仍需比 btrfs 更谨慎。帖主计划从 30TB 逐步扩展到 80TB,建议在迁移前就把 vdev 布局、未来扩容路径想清楚。
「写洞」(write hole)问题指的是在 RAID5/RAID6 条带写入过程中,若系统在数据块与奇偶校验块尚未全部落盘时意外掉电,重启后数据块与校验块将处于不一致状态,导致静默数据损坏——即文件系统认为数据完好,实际读取时却拿到错误内容。btrfs 的 RAID5/RAID6 实现由于写时复制(CoW)架构与条带写入的协调机制尚不完善,这一问题在其官方 Wiki 中被明确标注为「已知缺陷」。ZFS 的 RAIDZ 则通过将整个条带作为原子事务写入,并借助 ZIL(ZFS Intent Log)记录写入意图,从架构上规避了这一问题。对于存放不可替代数据(家庭照片、重要文件)的 NAS,这一差异的实际风险不容忽视。
别忽视 ECC 内存与备份策略
ZFS 与 ECC 的关系
关于 ZFS 是否「必须」使用 ECC(纠错)内存,社区争论已久。共识是:ECC 并非 ZFS 独有需求,任何认真对待数据的系统都能从 ECC 受益。ZFS 强大的校验机制无法防范内存位翻转带来的静默损坏,但没有 ECC 也不意味着 ZFS 不可用——只是数据完整性的保障链条上少了一环。帖主没有提及是否使用 ECC,如果未来对数据可靠性有更高要求,这是值得投资的方向。
内存位翻转(bit flip)是指 DRAM 中的存储单元因宇宙射线、热噪声等原因自发发生比特反转的现象。ECC(Error-Correcting Code)内存通过额外的校验位,能够自动检测并纠正单比特错误、检测双比特错误,从而防止损坏的数据被写入磁盘。ZFS 在磁盘层面具备端到端校验和,可以检测存储介质上的静默损坏,但它无法区分「从内存写入时数据已经出错」和「磁盘本身写坏了」这两种情况。如果内存发生位翻转而系统未崩溃,ZFS 可能会将损坏的数据连同正确的校验和一起写盘,之后反而无法发现这条记录已经出错。因此,ECC 与 ZFS 校验机制是互补而非替代的关系,共同构成完整的数据完整性保障链。
第二台镜像 NAS 才是真正的定心丸
帖主提到计划再搭一台 NAS 完整镜像所有数据,这是整个方案里最正确的决定。无论用 ZFS 还是 btrfs,RAID 都不等于备份。RAIDZ 能扛住硬盘物理故障,但挡不住误删除、勒索软件或文件系统灾难性损坏。一份独立的异地/离线镜像,才是数据安全的最后防线。
给同类用户的实用建议
综合来看,针对内存有限的家用服务器,可以这样决策:
- 不要开启去重,「1GB/1TB」的传言随之作废,普通存储用 ZFS 内存压力可控。
- 手动限制 ARC 上限(
zfs_arc_max),给应用服务留足内存,牺牲的只是缓存性能。 - 优先出于可靠性理由迁移:btrfs RAID5 的写洞风险远比内存问题更值得担心,ZFS RAIDZ 是更稳妥的选择。
- 迁移前规划好 vdev 结构,充分考虑从 30TB 到 80TB 的扩容路径。
- 坚持做第二台镜像 NAS,RAID 永远替代不了真正的备份。
对帖主这台 64GB 内存的机器来说,用 ZFS 完全可行,真正需要权衡的是迁移成本与池结构规划,而不是那条被误传多年的内存法则。
相关推荐
Linux 发行版该停止纠结桌面了:底层才是真正价值
一位资深 Linux 创作者认为,多数发行版把精力浪费在桌面美化和品牌差异化上,而内核、驱动、软件仓库等底层才是真正价值所在。本文梳理其核心论点与内在矛盾。
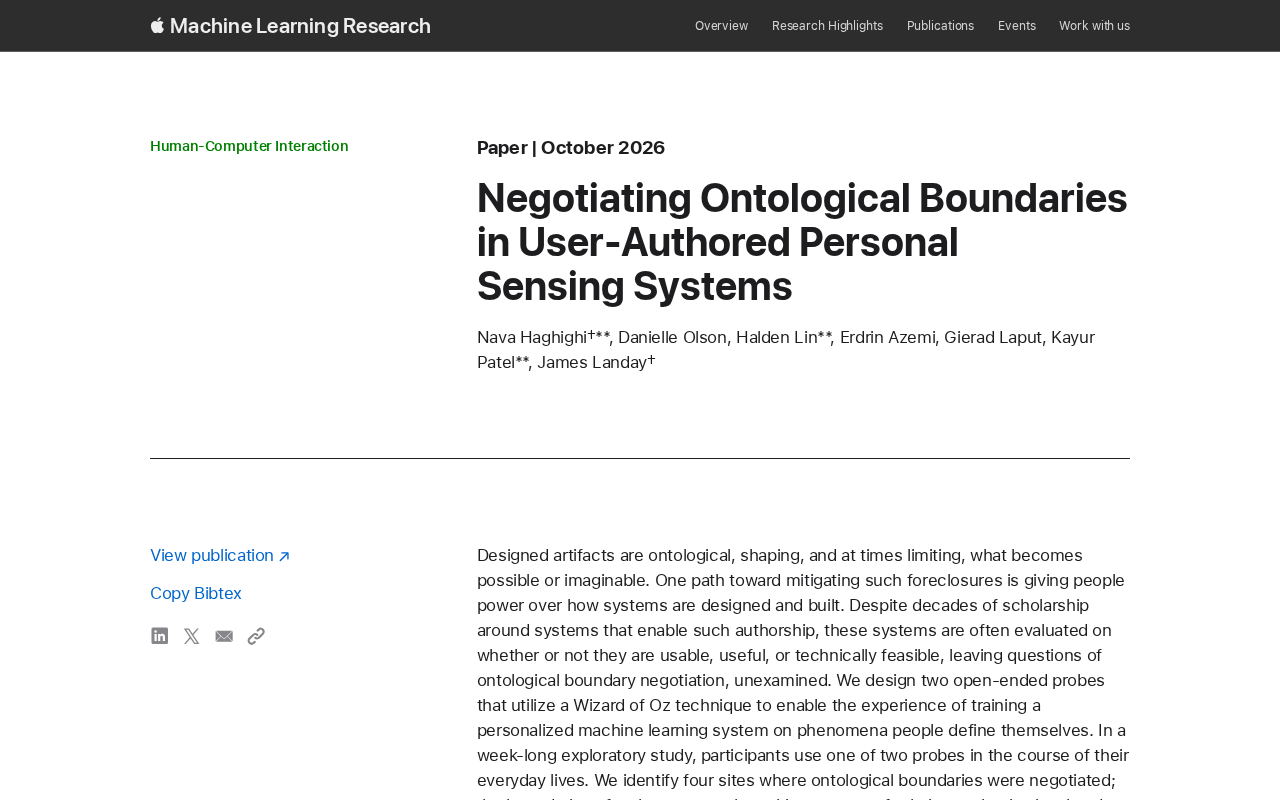
用户自建个人感知系统:谁在定义技术的边界?
一项HCI研究通过绿野仙踪探针,探讨用户自建个人感知系统时如何与技术预设的本体论边界协商,揭示了超越可用性的设计评估新维度。
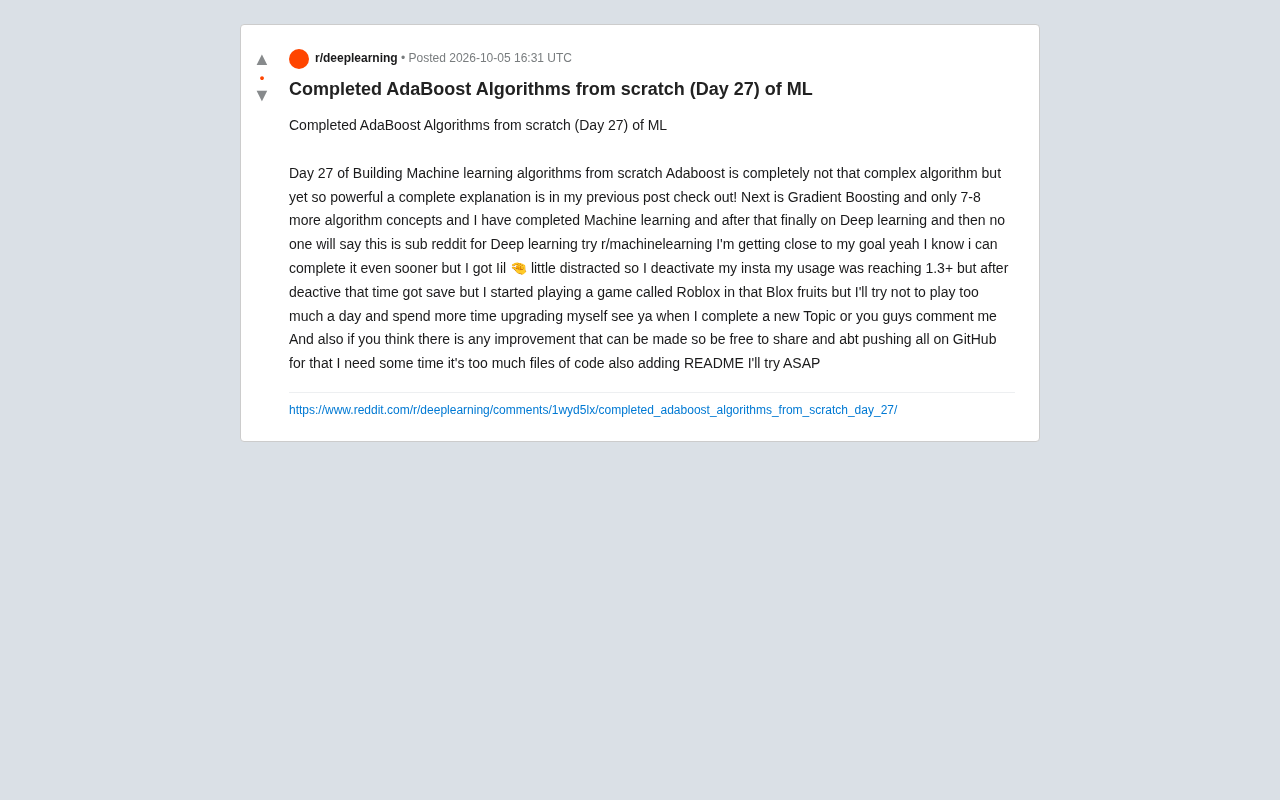
从零实现AdaBoost:机器学习手写算法第27天实录
一位Reddit学习者从零手写实现AdaBoost算法,分享机器学习第27天进度。本文解析AdaBoost核心原理、从零实现的价值,以及从集成学习到深度学习的自学路线规划。