Neo-Classic基准:大模型能真正读懂古典诗词吗?

Neo-Classic基准用当代格律诗揭示:主流大模型在古典诗词上的高分很大程度上源于模式记忆,而非真正的推理能力。
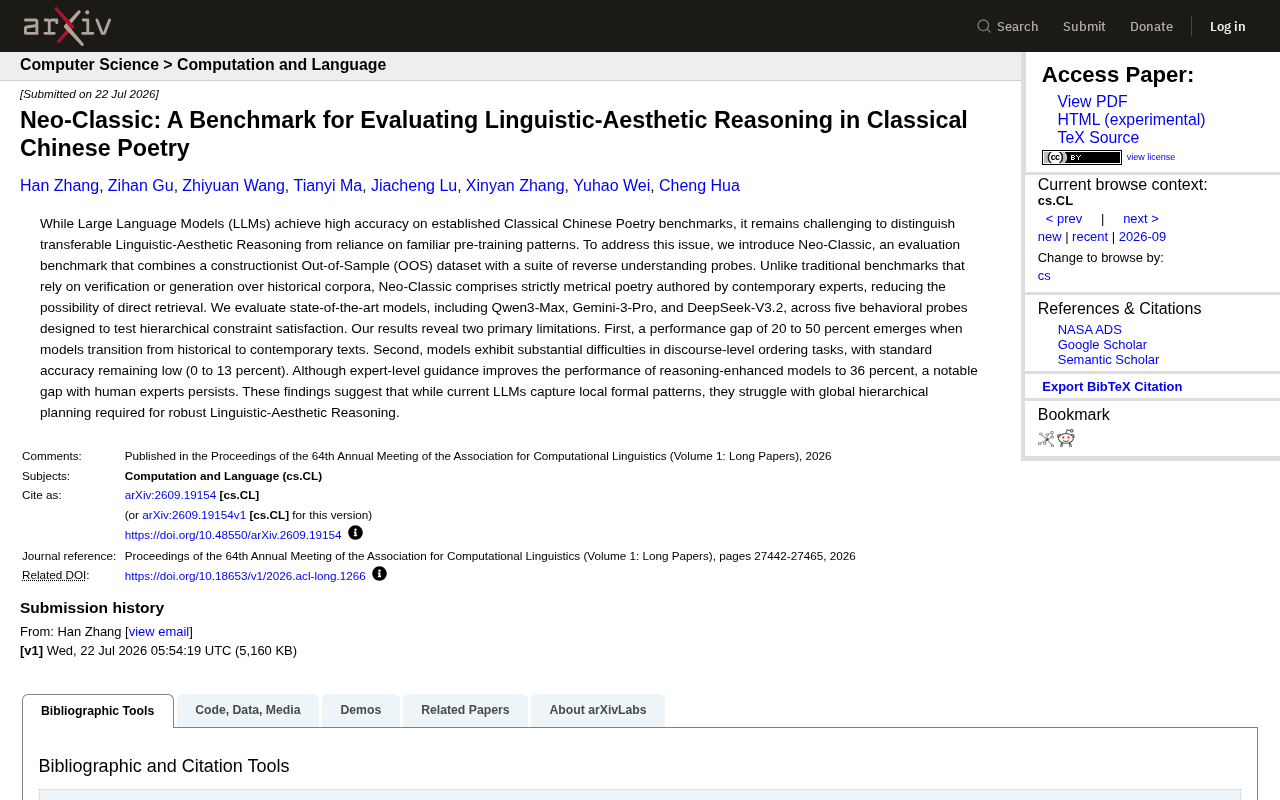
研究提出Neo-Classic评测基准,通过收录当代专家创作的严格格律诗词(样本外数据)和五种逆向理解探针,将模型的"背题记忆"与"真实推理"剥离开来。对Qwen3-Max、Gemini-3-Pro、DeepSeek-V3.2等顶尖模型的测试揭示两大核心缺陷:从历史文本切换到当代文本时,性能下滑20%–50%,说明既有高分掺杂大量模式记忆成分;在需要把握全局结构的篇章级排序任务中,准确率仅0%–13%,即便引入专家引导提示,推理增强模型也只达36%。结论指向一道尚未逾越的鸿沟:现有LLM能捕捉局部形式模式,但缺乏全局层级规划所必需的语言-美学推理能力。这一发现对所有存在丰富历史语料的AI评测领域均有参考价值。
当高分不再等于真懂
大语言模型(LLM)在既有的古典中文诗词评测中往往能拿到相当高的准确率,但一个关键问题始终难以厘清:模型究竟是掌握了可迁移的"语言-美学推理"能力,还是仅仅依赖预训练阶段见过的熟悉语料在"背题"?这个疑问指向了当前评测方法的根本性局限——用历史语料出题,很难判断模型是在推理,还是在检索记忆。
针对这一痛点,一项新研究提出了名为 Neo-Classic 的评测基准。它的核心思路是把测试内容从模型可能"背过"的历史文本,转向模型几乎不可能提前见过的当代作品,从而更纯粹地检验模型的推理能力。
Neo-Classic 的设计巧思
Neo-Classic 由两部分组成:一个建构主义式的样本外(Out-of-Sample, OOS)数据集,以及一套逆向理解探针(reverse understanding probes)。
与传统基准依赖对历史语料库进行验证或生成不同,Neo-Classic 收录的是当代专家创作的、严格符合格律的诗词。这样做的最大好处,是极大降低了模型直接从训练数据中"检索"答案的可能性。换句话说,模型面对的是全新的、但同样遵循严谨格律规则的文本,只能靠真正理解规则来作答。
研究团队设计了五种行为探针,专门用来测试模型对层级化约束(hierarchical constraint satisfaction)的满足能力。古典诗词的规则并非扁平的——从字词、平仄、对仗到篇章结构,存在多层次的约束关系,这正是检验"局部模式识别"与"全局规划能力"差异的理想场景。
**层级化约束(hierarchical constraint satisfaction)**是古典诗词格律的核心特征,也是这套评测框架的理论基础。以律诗为例,约束从微观到宏观层层嵌套:最底层是单字的声调(平声/仄声),往上是每句内部的平仄格式(如"仄仄平平仄仄平"),再往上是相邻两联之间的"粘对"规则(粘:相邻两联的出句与上联对句平仄相同;对:同一联出句与对句平仄相反),最顶层则是全篇的起承转合、意境统一与情感递进。这种多层约束相互依存的结构,意味着生成或评判一首诗时,不能只看局部是否合乎平仄,还必须在全局层面协调所有约束——正是这一属性使诗词成为测试大模型"全局规划能力"的理想场景。
三大顶尖模型的真实表现
研究对多个当前最先进的模型进行了评测,包括 Qwen3-Max、Gemini-3-Pro 和 DeepSeek-V3.2。结果揭示了两个主要局限。
局限一:从历史到当代的性能鸿沟
当模型从历史文本转向当代文本时,出现了 20% 到 50% 的性能下滑。这一显著落差是有力的证据:模型在历史语料上的高分,相当程度上来自对熟悉模式的依赖,而非真正可迁移的推理能力。一旦换成没见过的当代格律诗,模型的"底牌"就暴露了。
这种现象在机器学习中通常被称为数据污染(data contamination)或基准泄漏(benchmark leakage):预训练语料库中已经包含了测试题目或与之高度重叠的内容,导致模型在评测中的得分虚高,无法反映真实的泛化能力。对于古典诗词任务,互联网上存在大量对历代经典作品的注释、赏析和题库,模型极有可能在预训练阶段已经"见过"相关答案。样本外(Out-of-Sample)设计的价值正在于此——通过使用模型训练截止日期之后或来源受控的当代作品,研究者可以在相当程度上排除记忆检索对评测结果的干扰,使性能数字更接近模型真实的语言-美学推理能力。
局限二:篇章级排序任务的全面失守
更严峻的问题出现在篇章级排序任务上。模型在这类任务中的标准准确率极低,仅为 0% 到 13%。这意味着,当需要理解和组织诗词的全局结构、把握句子之间的逻辑与美学次序时,现有模型几乎无能为力。
即便引入专家级的引导提示,让具备推理增强能力的模型表现提升到 36%,与人类专家之间仍存在明显差距。
局部模式 vs 全局规划
这些发现共同勾勒出当前 LLM 在古典诗词理解上的能力边界:模型能够捕捉局部的形式模式,却难以完成稳健的语言-美学推理所必需的全局层级规划。
换个角度看,模型像是一个熟记了平仄口诀、对仗套路的应试者,能应付零散的规则考核,却无法真正"谋篇布局"。诗词创作与鉴赏中那种对整体意境、结构呼应、情感递进的把握,恰恰是层级化推理能力的集中体现,也是当前模型最薄弱的环节。
Neo-Classic 的价值不只在于给出一组分数,更在于它提供了一种更诚实的评测范式——通过样本外数据和逆向探针,把"记忆"和"推理"尽可能剥离开来。对于关心大模型真实认知能力的研究者而言,这类基准的出现有助于避免被虚高的历史语料成绩所迷惑。
对 AI 能力评估的启示
这项研究的意义超出了古典诗词本身。它提醒我们,在任何存在丰富历史语料的领域,模型的高分都可能掺杂"数据泄漏"或模式记忆的成分。要真正衡量模型的迁移与推理能力,就需要构造样本外、抗检索的评测任务。
古典中文诗词由于其严格的层级化格律,成为检验全局规划能力的天然试金石。而 0% 到 13% 的篇章排序准确率,则清晰地说明:当下的语言模型在"局部正确"与"整体连贯"之间,仍横亘着一道尚未跨越的鸿沟。
相关推荐
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。
Vercel首席软件官复盘:智能体构建从多智能体到文件系统的进化
Vercel首席软件官Andrew在AI Engineer大会复盘智能体构建历程:从巨型提示词到多智能体链、单体记忆管理,再到受Cloud Code启发的文件系统智能体,最终催生开源框架EVE。深度解析智能体架构演进与垂直智能体的核心壁垒。
腾讯开源 BSK 实测:让 AI 接管你已登录的浏览器
腾讯开源 BSK(Browser Skill Kit)实测:让 AI 直接接管已登录的真实 Chrome 浏览器,通过 WebSocket 实现远程指挥。本文解析其架构原理、安装方式,以及插件版本、新窗口复用、验证码人机接管三大实操要点。