Nginx 413错误修复后,agent记忆该存什么?
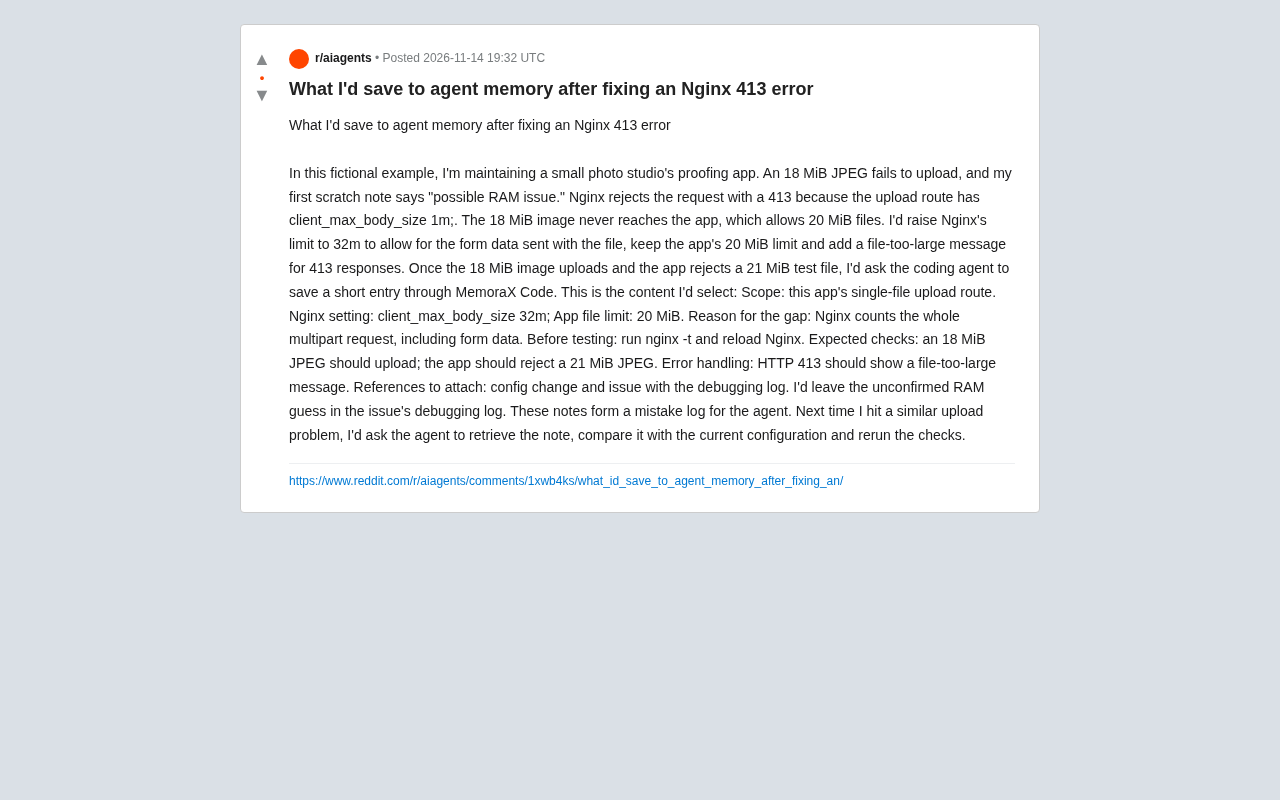
一次 Nginx 413 上传失败案例,说明 agent 记忆该写什么、不该写什么。
文章从一个 18 MiB JPEG 上传失败的真实案例出发,指出元凶是 Nginx 的 client_max_body_size 默认 1m 限制,请求在到达应用前就被 413 拒绝。修复方案是把 Nginx 限额调到 32m,同时保留应用层 20 MiB 限制,因为 Nginx 统计整个 multipart 请求体而应用只看文件本身。作者随后讨论了修复后应写入编码 agent 记忆的七项内容:作用域、Nginx 配置值、应用限额、限额差异原因、验证命令、预期检查项和错误处理方式,并强调不应把“可能是内存问题”这类未验证猜测写入记忆。文章最后提炼出三点原则:记忆要带作用域、要可执行、要区分事实与假设。
从一次上传失败说起
一个虚构但典型的场景:你维护着一个摄影工作室的样片应用,用户上传一张 18 MiB 的 JPEG 时失败了。你最初的手写笔记可能写着“可能是内存问题”,但真正的元凶是 Nginx——上传路由上配置了 client_max_body_size 1m;,请求在到达应用之前就被 413 拒绝,而应用本身允许 20 MiB 的文件。
这个案例来自 Reddit 上的一则分享,作者用它来讨论一个更普遍的问题:当编码 agent 帮你解决了一个 bug,事后应该把什么写入它的记忆,才能让下一次遇到类似问题时真正省力?
Nginx 的 client_max_body_size 指令定义在 http、server 或 location 块中,用于限制客户端请求体的最大字节数,单位可用 k、m 等后缀。当请求体超过该值时,Nginx 会直接返回 413 Request Entity Too Large,并且不会把请求转发给后端应用,因此应用层的日志和错误处理逻辑完全看不到这次请求。这解释了为什么案例中应用本身允许 20 MiB,用户上传 18 MiB 却仍然失败:请求在 Nginx 这一层就被拦下了。默认情况下该指令的值为 1m,很多框架或部署模板不会主动调高,所以在大文件上传场景中它是最常见的“隐形天花板”。排查时可以先检查 Nginx 错误日志中的 413 记录,再确认请求是否到达了应用。
修复动作:两边限额的“数字游戏”
作者给出的修复方案并不复杂:把 Nginx 的 client_max_body_size 调到 32m,但应用层的 20 MiB 限制保持不变,同时为 413 响应增加一条“文件过大”的提示。
为什么 Nginx 的限额要高于应用限额?原因在于两者计算的对象不同:Nginx 统计的是整个 multipart 请求体,包含随文件一起发送的表单数据;而应用只关心文件本身的大小。留出余量,才能让 18 MiB 的图片顺利通过,又让应用在收到 21 MiB 测试文件时按预期拒绝。
验证步骤同样明确:修改后先运行 nginx -t 检查配置,再 reload Nginx;然后上传 18 MiB JPEG 应成功,上传 21 MiB JPEG 应被应用拒绝,413 响应应显示友好提示。
multipart/form-data 是 HTML 表单上传文件时使用的编码格式,它把请求体切分成多个 part,每个 part 带有自己的 Content-Disposition 头。除了文件二进制数据,请求体里还包含 boundary 分隔符、表单字段名、文件名、Content-Type 等元数据;如果表单还有其他文本字段,它们也会一并计入请求体大小。这正是 Nginx 与应用层限额需要留出差距的根本原因:Nginx 按整个请求体的字节数计算,而应用通常只对解析后的文件对象做大小校验。文件越大、表单字段越多,两者之间的差值就越明显。实践中常见的做法是让 Nginx 限额比应用限额高几 MiB 或按比例留出 10%–20% 的余量,而不是把两者设成相同数值。
该写入 agent 记忆的七条内容
修复完成后,作者通过 MemoraX Code 让编码 agent 保存了一条简短记录。这条记录的内容经过精心挑选,包含七个部分:
- Scope:限定为“此应用的单文件上传路由”,避免记忆泛化到无关场景。
- Nginx setting:
client_max_body_size 32m; - App file limit:20 MiB
- Reason for the gap:Nginx 统计整个 multipart 请求(含表单数据),所以两边限额有意不同。
- Before testing:先跑
nginx -t并 reload。 - Expected checks:18 MiB JPEG 应上传成功;21 MiB JPEG 应被应用拒绝。
- Error handling:HTTP 413 应显示“文件过大”提示。
此外还要附上引用:配置变更和带有调试日志的 issue。这份记录本质上是一份“错误日志”,供 agent 下次检索。
为什么不把“内存猜测”写进记忆
有意思的是,作者特意没有把最初那条“可能是内存问题”的猜测写入 agent 记忆,而是把它留在 issue 的调试日志里。
这个取舍很关键:agent 记忆应当保存经过验证的结论和可复现的检查步骤,而不是中途的错误假设。如果把未确认的猜测写进去,下一次 agent 检索时可能被误导,浪费一轮排查。调试日志则保留了完整的探索过程,适合人类回看,但不适合作为 agent 的行动依据。
编码 agent 的记忆通常以可检索的条目形式存储,检索时依赖语义相似度或关键词匹配。如果记忆库中混入了未经验证的假设,比如“上传失败可能是内存问题”,那么下次遇到上传相关问题时,这条记录很可能被召回并进入 agent 的上下文,导致它沿着错误方向推理。更麻烦的是,agent 往往缺乏区分“已验证结论”和“历史猜测”的元信息,除非记忆条目本身带有置信度或状态标记。因此业界逐渐形成的做法是:记忆只收录经过测试验证、可复现的事实与操作步骤;探索过程中的假设、死胡同和临时推理留在 issue、调试日志或对话历史中,供人类回溯,但不进入 agent 的长期记忆。这种分层本质上是在管理记忆的信噪比。
对 agent 记忆设计的三点启示
这个案例虽小,却折射出 agent 记忆管理的几个原则。
第一,记忆要带作用域。 明确“仅适用于这个应用的单文件上传路由”,可以防止 agent 把特定配置当成通用规律套用到其他地方。
第二,记忆要可执行。 除了结论,还要记录验证命令(nginx -t)、预期结果(18 MiB 通过、21 MiB 被拒)和错误处理方式,这样 agent 下次能直接重跑检查,而不是从头推理。
第三,记忆要区分“事实”与“假设”。 确认的配置写进记忆,未证实的猜测留在日志。这种分层让 agent 的记忆保持高信噪比。
下次遇到类似问题怎么用
按照作者的设想,下次再碰到上传相关的问题,流程是:让 agent 检索这条笔记,与当前配置做对比,然后重跑检查项。如果配置已经变化(比如限额被调整过),agent 能立即发现差异;如果检查项不通过,说明问题可能不在同一个地方。
这种“检索—对比—重跑”的循环,把一次性的调试经验转化成了可复用的资产。对经常和 agent 协作的开发者来说,花几分钟整理记忆条目,可能比下次重新排查省下更多时间。
相关推荐
保护民主与自由选举:科技视角下的长期进步
从科技与AI视角探讨民主与自由选举的保护,分析技术对选举公正性的影响及如何守护长期社会进步,强调科技伦理与责任。
洛奇与米奇:银幕师徒的AI时代启示录
从洛奇与米奇的经典对白中,提炼AI时代的师徒智慧:经验传承、训练方法革新与长期主义。银幕故事折射技术行业的核心命题。
突触生成:神经元如何建立连接与重塑大脑
突触生成(Synaptogenesis)是神经元建立连接的核心过程。本文解析生长锥如何引导轴突寻找目标、突触前後の分化机制、突触修剪如何精炼神经环路,以及成年大脑中突触重塑与发育期的差异,帮助理解学习记忆与神经可塑性的细胞基础。