N卡算力封印被开源破解:4090跑AI翻倍,Qwen4.0本周登场

算力破解与极限量化降低本地门槛,头部厂商则向基座与基准纵深推进。
文章梳理了同日出现的四条 AI 动态:开源项目通过 Linux 内核模块改写寄存器,绕过 NVIDIA 对消费级显卡的算力限制,使 4090 半精度算力突破 330 TFLOPS;欧洲团队用非均匀量化把 7630 亿参数的 DeepSeek 压缩到 1.75 位,单张 12G 显存配系统内存即可本地推理;阿里预告阿姆斯特丹峰会疑似发布 Qwen 4.0,并开源三维创作智能体基准 Blender World;推特系团队发布不依赖文本预训练的语音模型 DESA,支持全双工打断并可在苹果电脑本地运行。此外 Manus 在完成 5 亿美元融资后启动自研基座。文章认为行业呈两条主线:本地部署门槛持续下探,以及头部玩家向基座能力与评测标准纵深推进。
消费级显卡的"第二春":一次内核级破解让4090算力翻倍
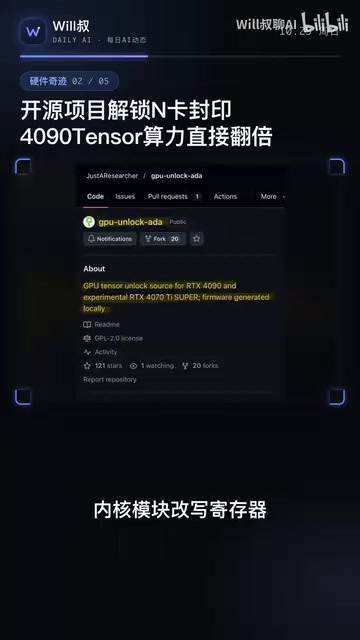
NVIDIA 消费级显卡的算力封印,被一个开源项目撕开了口子。据 B 站 UP 主 Will 叔的每日 AI 动态梳理,一个开源项目仅通过 Linux 内核模块改写寄存器,就绕过了英伟达对消费级显卡的长期限制,让 4090 的半精度算力直接突破 330 TFLOPS,实现接近翻倍的表现。
更关键的是这项操作的"轻量":不改驱动、不刷 BIOS、不动 vBIOS,从系统底层直接与硬件对话。这意味着破解路径避开了英伟达固件与驱动层的多重校验,也让"消费卡当专业卡用"从圈内传闻变成了可复现的技术方案。对于长期受限于显存和算力配额的个人开发者与小型团队,这无疑是一次成本结构上的松动。
不过需要冷静看待:内核模块改写寄存器属于系统级操作,稳定性、散热与保修风险都需要自行承担,英伟达后续通过驱动或固件策略收紧的可能性也不能排除。它更适合有 Linux 系统能力的实验型用户,而非开箱即用的生产环境方案。
算力封印与寄存器改写
NVIDIA 长期在消费级(GeForce)与专业级(Quadro/数据中心)产品线之间做人为区分:同一代 GPU 芯片在消费卡上往往被锁定较低的 FP16/BF16 吞吐、受限的显存带宽或 ECC 功能,以维护专业卡的价格体系。这类限制通常写在 GPU 的硬件寄存器与 vBIOS 配置中,由驱动在初始化阶段读取并生效。
内核模块改写寄存器的思路,是在 Linux 内核态直接映射 GPU 的 PCI 配置空间与显存映射区域,在驱动完成初始化前后修改特定寄存器值,从而改变频率、功耗墙或计算单元调度策略。由于不修改驱动二进制、不刷写 vBIOS,它绕开了签名校验与固件完整性检查,这也是该方法被称为"轻量"的原因;但代价是失去了厂商层面的稳定性保证,内核版本或驱动更新都可能导致失效甚至系统崩溃。
DeepSeek 极限量化:7630 亿参数压到 1.75 位,12G 显存可跑
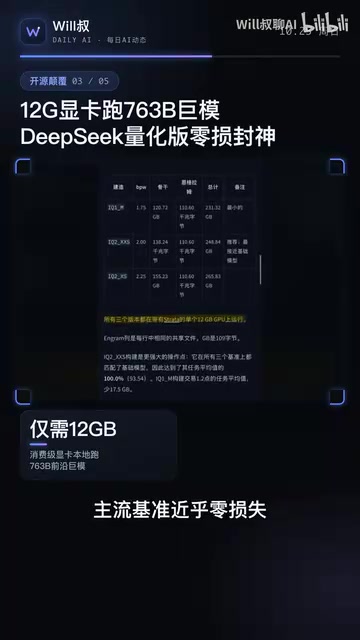
如果说算力破解是"开源硬件",那么欧洲团队发布的 DeepSeek广告 极限量化版就是"开源模型"侧的对冲。该方案基于非均匀量化算法,把 7630 亿参数的巨型模型压缩到 1.75 位,在主流基准上近乎零损失。
真正改变游戏规则的是部署门槛:单张 12G 显存显卡配合系统内存,就能在本地跑起来。过去这个量级的模型需要多卡集群,如今一台消费级主机即可承载,本地推理的边界被显著推后。非均匀量化的思路也值得关注——它并非简单粗暴地截断精度,而是根据权重分布动态分配比特,这也是"压缩率高但损失小"的技术前提。
当然,1.75 位量化的实际推理速度、长上下文表现和不同任务下的鲁棒性,仍需更多社区实测来验证。量化到极低比特后,模型在数学推理、代码生成等敏感任务上的退化往往比通用基准更明显,这是读者上手时应当重点关注的维度。
非均匀量化与低位宽的代价
常规量化(如 INT8、4-bit GPTQ)对所有权重使用统一的比特宽度和线性缩放,实现简单但对权重分布中的离群值不友好。非均匀量化则根据权重的实际分布动态分配比特:高频、重要的权重保留更多精度,长尾权重被压到极低比特,从而在平均位宽极低时仍维持较小的误差。1.75 位是一个平均意义上的指标,意味着部分权重实际上以 1 位甚至二值形式存储。
极低比特量化的主要风险不在通用基准,而在对数值精度敏感的任务:数学推理依赖精确的中间计算,代码生成对 token 级别的准确性要求高,长上下文则放大了误差累积。此外,低位宽权重通常需要配套的反量化 kernel 才能在 GPU 上高效执行,实际推理速度取决于是否有针对该位宽优化的算子实现,而非参数量本身。
Qwen 4.0 预告:阿姆斯特丹峰会与三维创作基准
阿里通义千问广告放出信号。官方预告本月 29 号在阿姆斯特丹峰会有重大发布,外界普遍猜测 Qwen 4.0 将即刻上线。
与版本号同样值得注意的,是通义同步开源了首个三维创作智能体基准 Blender World,并且直接交付可编辑工程文件。这一动作的意味很明确:把智能体的评测从文本问答推进到三维创作这类高复杂度、强工具依赖的场景。可编辑工程的交付方式,也让基准不只是"打分器",而成为可复用、可复现的创作基础设施。
对大模型厂商而言,基准即话语权。谁定义了评测维度,谁就在一定程度上定义了能力叙事。Qwen 在三维创作智能体这一相对空白的赛道上抢先落子,指向的是多模态与工具调用能力的下一个竞争焦点。
语音模型 DESA:不靠文本预训练,从真实对话学说话
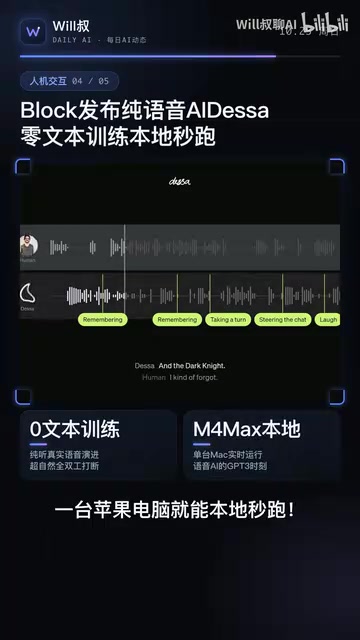
推特系团队发布的语音模型 DESA 走了一条不一样的路:完全不借助任何文本预训练,从聆听人类真实对话中学习说话,具备超自然的全双工打断、呼吸和笑声表现。
这与主流"语音转文本再转语音"的级联路线形成对照。跳过文本中间层,意味着模型可以直接建模对话中的韵律、停顿与非语言信息,这些恰恰是级联方案最容易丢失的部分。一台苹果电脑即可本地运行,也说明其参数量与工程优化面向端侧场景。
其局限同样明显:缺乏文本预训练的语义 grounding,在知识密集型任务上的可靠性有待检验。它是"像人一样说话"的路线,不等于"像人一样思考"的路线。
全双工语音与语义 grounding
传统语音交互采用级联架构:ASR 把语音转成文本,LLM 处理文本,TTS 再合成语音。这一链路天然存在延迟叠加,且会丢弃语调、停顿、呼吸、笑声等副语言信息。全双工(full-duplex)语音模型则在同一模型中同时处理输入与输出流,能够边听边说、支持即时打断,更接近人类对话的节奏。
跳过文本预训练的直接后果是缺乏语义 grounding:模型学到的是声学与对话模式,而非文本所承载的世界知识与逻辑关系。这使得它在闲聊、陪聊类场景表现自然,但在需要事实准确性或复杂推理的任务上可靠性不足。要弥补这一点,通常需要引入文本预训练、多模态对齐或检索增强,而这又会部分抵消其架构简洁性的优势。
Manus 战略转向:从调度外部模型到自研基座
中国智能体独角兽 Manus 出现重大战略转向。刚完成超 5 亿美元融资、估值 40 亿美元的它,已正式启动自研底层大模型,从单纯调度外部模型转向掌控核心基座。
这一转向折射出智能体赛道的集体焦虑:仅做编排层,护城河太浅,随时可能被基座模型厂商的原生 Agent 能力覆盖。向上游走、掌握基座,是把"调度优势"转化为"能力资产"的必然选择。但自研基座意味着资本开支、人才密度与数据飞轮的全面竞赛,40 亿美元估值能否支撑这条重资产路线,将是接下来最值得观察的变量。
一天之内的四条信号线
把这四条动态并置来看,AI 行业的两条主线相当清晰:一端是算力与模型效率的持续下探,让本地部署的门槛不断降低;另一端是头部玩家向基座能力与评测标准的纵深推进。前者惠及个体开发者,后者决定竞争格局。开源破解与极限量化让"个人算力自由"更近一步,而 Qwen 的基准布局与 Manus 的基座自研,则提醒我们:真正稀缺的从来不是算力,而是定义能力边界的资格。
相关推荐
MCP协议解析:让AI智能体拥有工具与记忆
MCP协议让AI智能体安全接入Gmail、Slack等工具并拥有持久记忆。本文解析MCP的连接工具、添加记忆、定义目标三步循环,说明它如何消除重复劳动,让AI从聊天工具变成可落地的生产力系统。
AI代理安装不可信?RepoGates五道关卡实测
RepoGates用五道关卡守护AI代理的仓库克隆、包安装与MCP服务器添加,覆盖浏览器、Clawed Code、MCP客户端、体检和深度扫描,每层各有盲区。
用Claude+MCP打造Jarvis:零硬件改造接入智能家居
一位创作者用Claude Code生成MCP Server,通过涂鸦Smart Life平台API直连智能灯泡,绕开Alexa和Google Home,实现语音控制灯的Jarvis式体验。本文拆解四步搭建流程、技术原理与方案局限。