NVIDIA Cosmos:两条提示词构建物理AI训练数据集

NVIDIA Cosmos 用两条提示词按需生成训练就绪的物理AI长尾数据集。
文章围绕 NVIDIA 官方开发者博客介绍的 Cosmos 世界模型方案展开,指出物理AI数据集的真正瓶颈在于稀有缺陷、夜间事故、极端天气等长尾场景难以采集与复现。Cosmos 将数据生产压缩为两个提示词环节:第一条定义场景的物理条件与环境脚本,第二条约束生成数据的质量与多样性,从而在同一场景模板下批量产出多角度、多条件的变体。提示词由此成为数据工程的新接口,降低了场景构造门槛,使世界模型与训练数据形成正向循环,可针对模型薄弱环节定向补数据。文章同时提醒,生成数据需满足"训练就绪"要求,与真实数据的配比及物理一致性校验仍是落地关键,开发者的核心门槛将从"能否采到数据"转向"能否设计好的场景提示词"。
NVIDIA Cosmos:两条提示词构建物理AI训练数据集
物理AI的世界模型精度,很大程度上取决于训练数据集的质量与多样性。但真实世界里的稀有缺陷、夜间事故、极端天气等场景,采集成本高、复现难度大,往往成为数据闭环中最薄弱的一环。NVIDIA 官方开发者博客介绍了一种思路:借助 Cosmos 世界模型,仅用两条提示词就能生成可直接用于训练的物理AI数据集。
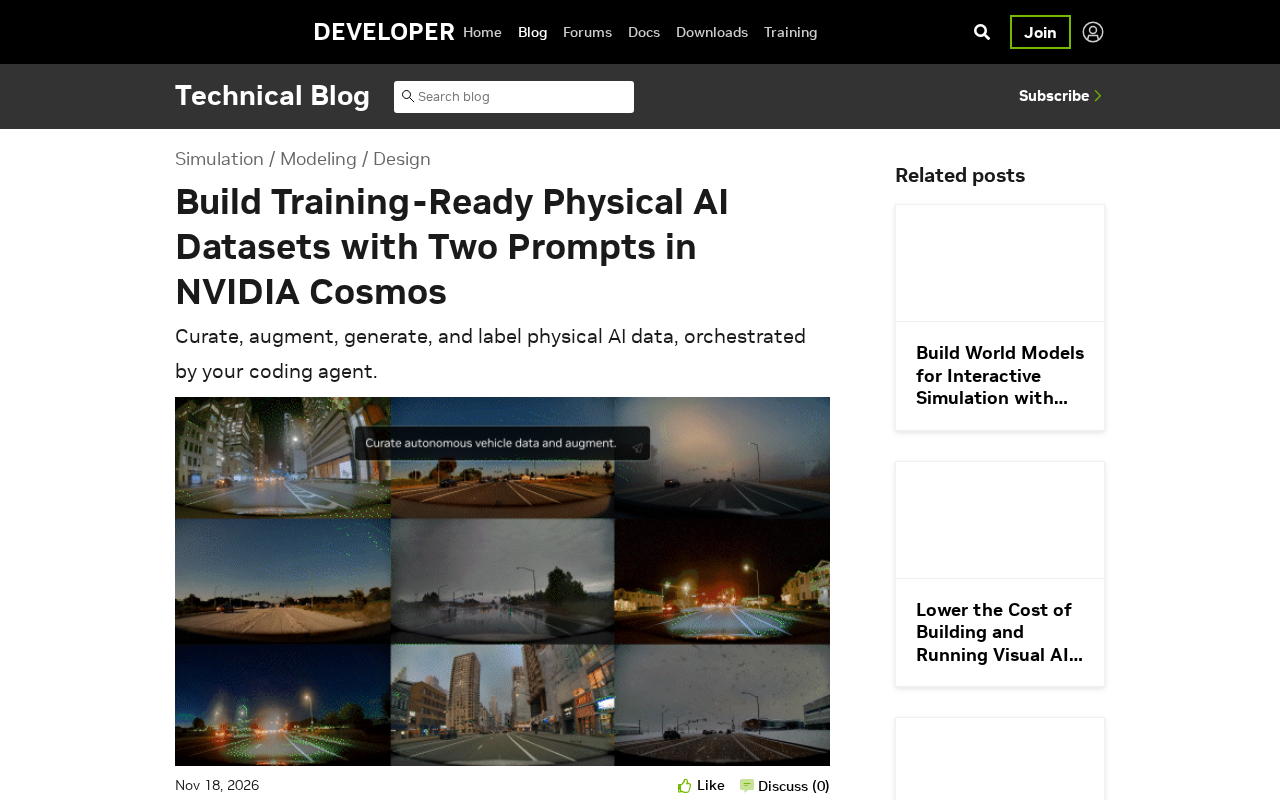
为什么物理AI数据集如此难做
物理AI要理解的是真实世界的运动、光照、材质与交互,模型必须在大量贴近现实的视频序列上学习。问题在于,真正有价值的训练样本往往藏在长尾场景里:罕见的产品缺陷、低光照下的道路事故、雨雪雾等恶劣天气。这些场景在自然采集中出现频率低,靠实车、实景拍摄堆量既不经济也难以控制变量。
NVIDIA 在博客中明确指出,世界模型的精度始于高质量、多样化的训练数据集,而捕获稀有缺陷、夜间事件等挑战性场景正是当前的瓶颈。这解释了为什么生成式世界模型会被引入数据生产流程——它把"等待场景发生"变成"按需构造场景"。
世界模型(World Model) 是一类学习环境动态规律的生成式模型,它试图在内部表征物理世界的状态转移与因果关系,从而能够预测"接下来会发生什么"或"给定动作后场景如何变化"。与单纯拟合像素分布的图像生成模型不同,世界模型强调时空一致性与物理合理性,例如物体不会凭空消失、光照随光源变化、碰撞遵循守恒规律。NVIDIA Cosmos 正是面向物理AI(自动驾驶、机器人等)设计的世界基础模型系列,其训练语料覆盖驾驶、机器人操作、自然场景等多领域视频,因而具备按条件合成符合物理直觉视频序列的能力。理解这一点,才能明白为何它可以被当作"数据生成器"使用。
两条提示词背后的数据生产逻辑
标题里的"两条提示词"并非营销修辞,而是把数据生成流程压缩成两个可复用的输入环节。
第一条提示词:定义场景与条件
第一条提示词用于描述目标场景的物理条件,包括环境、光照、物体状态与事件类型。它相当于给世界模型一份"拍摄脚本",让模型在受控条件下生成符合训练需求的视频片段。相比在真实世界中等待罕见事件,这种方式可以直接命中数据集中缺失的样本类型。
长尾场景(Long-tail Scenarios) 指在真实数据分布中出现频率极低、但对模型安全性至关重要的样本类型,如罕见交通参与者组合、极端天气、特殊工业缺陷等。它们在采集数据中占比可能不足千分之一,却往往是模型失效的高发区。传统做法依赖大规模路测或实景拍摄来"碰运气"命中这些场景,成本高且周期长。生成式世界模型的价值在于把长尾场景从"被动等待"转为"主动构造":开发者可以显式指定降雪、逆光、遮挡等条件,按需合成这些稀缺样本,从而有针对性地补齐训练分布中的空洞。补充长尾样本时,应注意其与真实分布的比例平衡,避免合成样本过度主导训练。
第二条提示词:约束数据质量与多样性
第二条提示词负责对生成结果施加质量与多样性约束。数据集的价值不只在于"有",更在于"足够多样且标注可靠"。通过提示词层面的控制,可以在同一场景模板下批量产出不同角度、不同条件、不同参数的变体,从而让训练集覆盖更广的分布。
这两步组合的意义在于降低了数据生产的门槛:不需要搭建复杂的仿真管线,也不需要编写大量场景脚本,提示词本身成为数据工程的接口。
训练就绪(Training-ready) 在文中是一个有明确工程含义的表述,指生成数据不仅在视觉上逼真,还需满足下游训练流程对格式、标注、时序长度、分辨率与物理一致性的要求。它通常包含几个层面:数据格式与现有训练管线兼容(如帧率、编码、元数据);场景中关键对象的标注或掩码可用;生成的物理交互(如车辆运动轨迹、机械臂抓取)在运动学上合理,不出现穿模、漂移或违反守恒的伪影。若缺少这些校验,合成样本即使"看起来像",也可能给模型引入错误监督信号。因此在实践中,生成后往往需要自动化的物理一致性检查与人工抽检相结合。
对物理AI开发流程的实际影响
世界模型与数据生成之间的关系是双向的。高质量数据训练出更准确的世界模型,而更准确的世界模型又能生成更逼真的训练数据,形成正向循环。Cosmos 的定位正是这个循环中的"数据放大器"。
从工程角度看,这种方案改变的是数据准备阶段的成本结构。传统流程中,数据采集、清洗、标注占据了项目早期的大量时间;而提示词驱动的生成方式把一部分工作前移到场景设计环节,让团队可以更快地验证模型在特定长尾场景下的表现。对于自动驾驶、机器人、工业质检等依赖物理世界感知的领域,这意味着可以针对已知薄弱环节定向补数据,而不是盲目扩大采集规模。
需要注意的是,生成数据并不能完全替代真实数据。博客强调的仍是"训练就绪"(training-ready),即生成结果需要满足训练所需的格式与质量要求,而非简单堆砌合成样本。合成数据与真实数据的配比、生成样本的物理一致性校验,仍是落地时必须回答的问题。
开发者可以期待什么
对于已经使用 NVIDIA 生态的团队,这一能力的吸引力在于接入成本低:以提示词为入口,把世界模型当作数据生成服务来调用。它适合在项目早期快速构建原型数据集,也适合在模型上线前针对失败案例做定向增强。
真正的门槛会从"能不能采到数据"转移到"能不能设计出好的场景提示词"。这要求团队对自身任务的长尾分布有清晰认知——知道模型在哪里容易失效,才写得出有价值的提示词。从这个角度看,Cosmos 把数据工程的一部分工作变成了对问题本身的理解。
物理AI的数据瓶颈不会因为一个工具而消失,但把稀有场景的构造权交到开发者手里,确实是朝着正确方向的一步。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。