NVIDIA cuML 加速谱聚类:Scikit-Learn 提速100倍实测
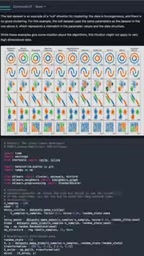
cuML 让 Scikit-Learn 谱聚类无需改代码即可在 GPU 上提速逾 200 倍
谱聚类因能捕捉 k-means 无法识别的复杂非凸数据结构而在机器学习中备受重视,但其 O(n³) 级别的特征分解计算使其在大规模数据上速度极慢。NVIDIA 的开源库 cuML 通过「透明加速」机制解决了这一痛点:只需在 Scikit-Learn 导入前加载 GPU 加速器,无需改写任何现有代码,即可让计算自动转移至 GPU 执行。该加速器已预装于 Google Colab 和 Kaggle,降低了使用门槛。实测显示,在股票期权等超大规模数据集上,GPU 版谱聚类比 CPU 版快 200 倍以上,运行时间从分钟级压缩至秒级,配合公开的基准测试 Notebook,结果可供任何人独立复现验证。
谱聚类(Spectral Clustering)是机器学习中一种能够捕捉复杂数据结构的聚类方法,但它长期受限于 CPU 上缓慢的运算速度。NVIDIA 的 cuML 库为这一痛点提供了解法:无需重写代码,只需在导入 Scikit-Learn 之前加载 GPU 加速器,就能让原本需要数分钟的计算在几秒内完成,在大规模数据上甚至能实现超过 100 倍乃至 200 倍的加速。
谱聚类为何值得关注
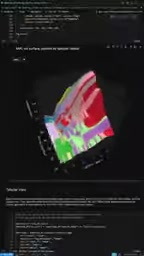
谱聚类的优势在于它能够发现 k-means 等传统方法容易遗漏的数据结构。在原始演示中,作者用 Scikit-Learn 的谱聚类将 5 万个期权合约的波动率曲面(volatility surface)切分成了不同的风险区间(risk regimes),形成了清晰的分组结果。
这类非凸、非球形分布的数据正是谱聚类的用武之地。相比之下,k-means 假设簇是球状且大小相近,面对复杂形态的数据往往表现不佳。Scikit-Learn 官方的聚类算法对比页面也直观地展示了不同方法在各类数据集上的差异。
谱聚类的核心思路是将数据点之间的相似关系表示为一个图(Graph),其中节点是数据点,边的权重反映两点之间的相似程度。通过计算该图对应的拉普拉斯矩阵(Laplacian Matrix)的特征向量,将原始高维数据映射到一个低维「谱空间」,再在该空间中用 k-means 完成最终聚类。这一过程的关键在于:谱变换能够「拉直」原本弯曲或环形的数据流形,使得在原始空间中无法线性分割的簇,在谱空间中变得可分。正因如此,谱聚类能够识别同心圆、螺旋线、月牙形等各类非球状结构,而这些恰恰是金融数据中波动率曲面、相关性网络等场景下常见的数据形态。
GPU 加速的最大障碍是速度
谱聚类强大,但代价是计算成本高。它涉及构建相似度矩阵并进行特征分解,随着数据规模增长,运算量急剧上升。在 CPU 上处理大规模数据集时,单次运行可能需要数分钟,这在需要反复调参或迭代实验的场景中几乎不可接受。
对于金融领域的股票期权数据这类超大规模数据集,速度瓶颈尤为明显。这也是为什么 GPU 加速成为让谱聚类真正走向实用的关键一步。
谱聚类的计算瓶颈主要集中在两个步骤:一是构建 n×n 的相似度矩阵(也称亲和矩阵),其空间复杂度为 O(n²),当数据点数量达到数万时,矩阵本身就会占用数 GB 内存;二是对拉普拉斯矩阵进行特征分解(Eigendecomposition),其时间复杂度通常为 O(n³),这是整个流程中最耗时的环节。以 5 万条数据为例,特征分解涉及对一个 50000×50000 矩阵的运算,CPU 单核串行处理此类密集线性代数计算时力不从心。GPU 拥有数千个并行计算核心,天然擅长这类大规模矩阵运算,因此加速效果在数据规模越大时越显著。
cuML 加速器:零重写的接入方式
cuML 提供 GPU 加速的最大亮点是不需要改写现有代码。开发者只需在 Scikit-Learn 的导入语句之前加载 cuML 的 GPU 加速器,Scikit-Learn 便会自动在 GPU 上运行。这种「透明加速」的设计意味着现有项目几乎可以零成本迁移。
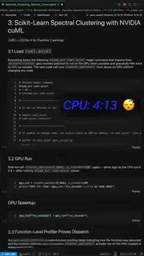
更方便的是,该加速器已经预装在 Google Colab 和 Kaggle 这两个主流的免费云端 Notebook 平台上。这意味着即便没有本地 GPU,用户也可以直接在云端体验加速效果,降低了尝试门槛。
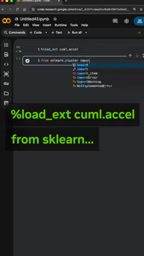
cuML(CUDA Machine Learning Library)是 NVIDIA RAPIDS 生态系统的组成部分,基于 CUDA 实现了大量常见机器学习算法的 GPU 版本。其「透明加速」机制的实现原理是通过 Python 的模块替换(monkey-patching)机制,在运行时将 Scikit-Learn 中的对应类替换为 GPU 优化版本,因此调用方式、参数接口与返回值格式均与原版保持一致,开发者无需感知底层的切换过程。需要注意的是,这种透明替换要求本地或云端环境中已安装兼容的 NVIDIA GPU 及 CUDA 驱动;在纯 CPU 环境中,cuML 的加速器加载步骤会被自动跳过或报错,不会影响代码逻辑的正确性,但也无法获得加速效果。
实测:大规模数据下超 200 倍提速
根据演示中的说法,在股票期权数据等超大规模场景下,谱聚类在 GPU 上的运行速度比 CPU 快出 200 倍以上。原本以分钟计的等待被压缩到秒级,这对需要频繁试验和实时分析的工作流是质的改变。
这种加速幅度并非偶然。谱聚类中大量的矩阵运算天然适合 GPU 的并行架构,数据规模越大,GPU 相对 CPU 的优势越明显。作者也提供了包含基准测试代码的 Notebook 供读者复现验证。
开源与可复现性
值得一提的是,cuML 是一个开源项目,代码托管在 GitHub 上,任何人都可以查看、使用和贡献。配合公开的基准测试 Notebook,用户不仅能看到宣称的加速数字,还能自行验证在自己数据上的实际表现。
对于数据科学从业者来说,这种「保留熟悉的 Scikit-Learn API + 免费云端环境 + 开源可复现」的组合,让 GPU 加速从一个需要专门学习的技术,变成了几行代码就能享受的便利。如果你正在处理大规模聚类任务并被 CPU 速度困扰,cuML 的透明加速方案值得一试。
相关推荐
OpenAI披露模型异常、DeepMind建AGI机构、英伟达联手管电力
9月17日AI行业三大动态:OpenAI公开模型异常披露框架并放出六份报告,Google DeepMind成立AGI公共讨论平台,英伟达联合Google等发起AI电力管理联盟。深度解析AI安全、治理与基础设施三大瓶颈。
Prompt→MCP→Agent→Skill:5分钟搞懂AI术语进化链
一篇科普梳理Prompt、MCP、Agent、Skill、Cowork五大AI核心概念的递进关系。用职场类比讲透AI如何从简单指令进化到多智能体团队协作,帮你彻底告别AI术语焦虑。
10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
一篇基于B站教程的实操指南,教你用Python、Ollama和PydanticAI在10分钟内搭建完全本地运行的AI代理。涵盖模型选择、连接推理服务器、挂载工具函数和构建对话循环全流程。