NVIDIA RTX Spark:用本地AI算力重构游戏神经渲染
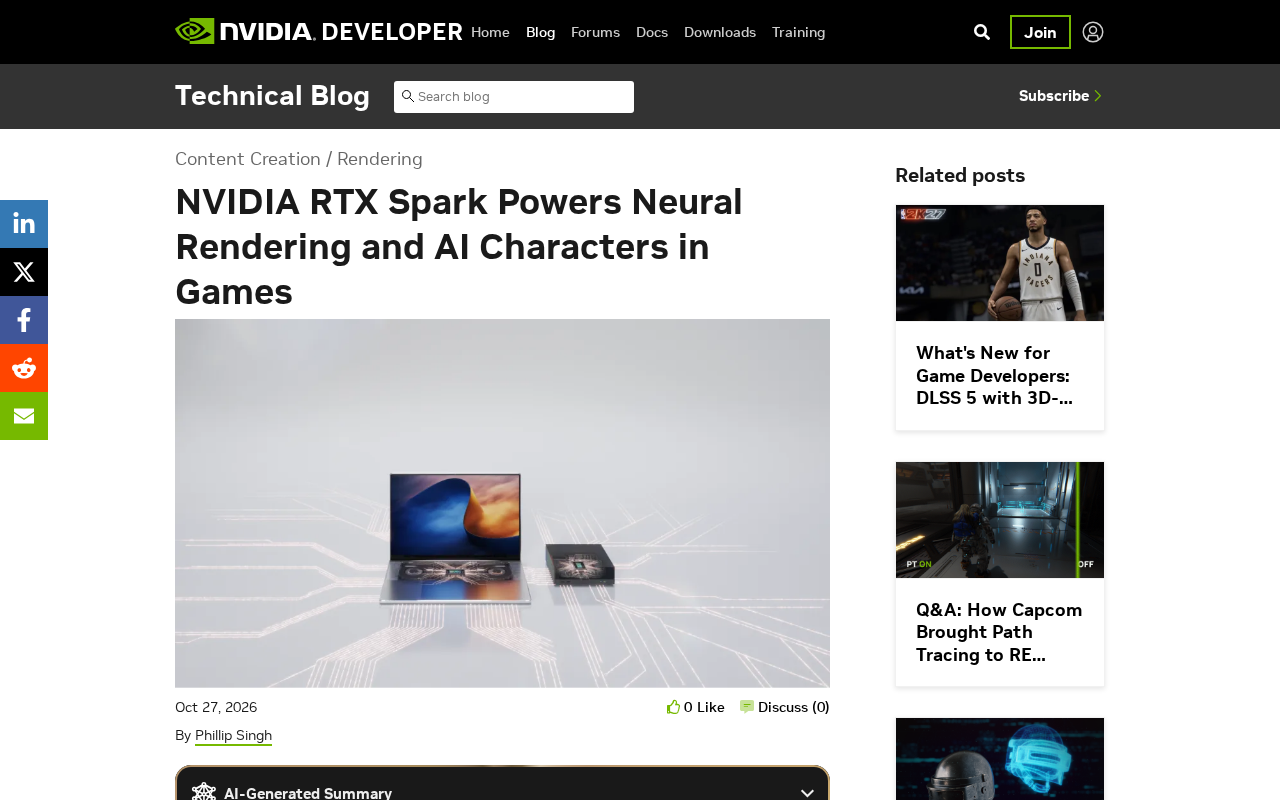
NVIDIA 推出 RTX Spark Windows PC 平台,把 Blackwell RTX 算力下放到轻薄设备,推动神经渲染与 AI 角色进入游戏运行时。
NVIDIA 在开发者博客中介绍了 RTX Spark,一个覆盖 AI 开发、内容创作与游戏的 Windows PC 平台。它基于 Blackwell RTX 架构,形态为轻薄笔记本与紧凑台式机,目标不是提升帧率,而是让神经渲染和 AI 角色成为游戏运行时的常规组件。神经渲染此前受限于算力与延迟,只能停留在预渲染演示;AI 角色则依靠本地模型实时生成行为与反应,避免云端推理的延迟与成本。平台强调同一套 RTX 软件栈跨场景复用,缩短开发者从模型调试到实机运行的迭代路径。NVIDIA 尚未公布性能、功耗与价格数据,实际落地效果有待实测。
NVIDIA 在开发者博客中正式介绍了 RTX Spark——一个面向 AI 开发、内容创作与游戏场景的新 Windows PC 平台。它把 Blackwell 架构的 RTX 能力装进轻薄笔记本和紧凑型台式机,目标不只是跑更高的帧率,而是让神经渲染与 AI 角色真正成为游戏运行时的常规组成部分。
RTX Spark 究竟改变了什么
从定位上看,RTX Spark 不是一块单独的显卡,而是一套完整的硬件与软件平台方案。NVIDIA 强调它覆盖三类负载:AI 开发、内容创作和游戏。三者共用同一套本地算力底座,这意味着开发者可以在同一台轻薄设备上完成模型调试、素材生成和游戏内实时推理,而不必依赖云端来回传输。
这一思路的关键在于把 AI 能力从「离线工具」推进到「运行时组件」。过去游戏里的 AI 大多停留在 NPC 行为树或脚本层面,神经渲染也更多出现在演示视频里。RTX Spark 试图让这些能力在消费级形态的设备上稳定跑起来。
神经渲染:从演示走向运行时
NVIDIA 在博文中明确把神经渲染列为 RTX Spark 的核心应用方向之一。所谓神经渲染,是用神经网络参与图像生成与重建的渲染方式,例如用模型替代部分传统光栅化或后处理环节,以更低的算力代价换取更接近真实的画面表现。
这类技术此前的主要障碍是算力与延迟。轻薄设备的功耗预算有限,神经网络推理又对显存带宽和矩阵算力敏感。RTX Spark 基于 Blackwell RTX 架构,正是要把这部分能力下放到更小的机身里。对开发者而言,价值在于神经渲染不再只能做成预渲染的过场效果,而可以在实时管线中按帧调用。
光栅化是传统 GPU 渲染管线的核心环节,其流程是把三维场景中的几何图元(三角形)投影到二维屏幕空间,再逐像素判断覆盖关系并着色。它依赖固定的硬件流水线,效率高、确定性好,但对全局光照、多次反弹等复杂效果需要大量近似与后处理。神经渲染并非完全取代光栅化,而是用神经网络在管线中的特定阶段(如降噪、超分、材质重建、光照缓存)替代或增强传统算法。二者结合的关键在于推理延迟必须落在一帧的预算内(通常 16 毫秒甚至更低),这也是为何神经渲染长期停留在离线渲染和演示阶段,直到具备足够矩阵算力与显存带宽的硬件出现。
AI 角色带来的设计空间
博文同时提到 AI Characters(AI 角色)是 RTX Spark 在游戏侧的重点场景。和传统 NPC 相比,AI 角色的差别不只是更自然的对话,而是行为与反应可以由本地模型实时生成,减少对固定脚本的依赖。
本地推理在这里有两点实际意义。其一是延迟:对话与反应如果依赖云端往返,交互体验会被网络抖动打断。其二是隐私与成本:角色交互数据留在本地,开发者也不必为每一次推理支付云端费用。对独立开发团队来说,后者往往比前者更能决定方案是否可行。
需要注意的是,NVIDIA 目前披露的是平台定位与能力方向,并未给出具体游戏作品的落地清单。AI 角色能否从技术演示变成玩家真正愿意长期互动的设计元素,仍取决于内容团队如何控制生成结果的稳定性。
行为树是游戏 AI 中广泛使用的决策结构,它用层次化的节点(选择、序列、条件、动作)描述 NPC 的行为逻辑。行为树的可预测性和可调试性是其主要优势,但状态空间由设计师手工编写,难以覆盖开放式的对话与情境反应。本地大模型驱动的 AI 角色则相反:它能生成未预设的响应,但输出具有随机性,需要额外的约束层(如角色设定提示、输出过滤、状态记忆管理)来保证一致性。两者并非替代关系,实践中常见做法是用行为树管理角色的目标与状态机,用本地模型负责对话与即时反应生成,从而在可控性与表现力之间取得平衡。
对开发者意味着什么
RTX Spark 的窗口形态——轻薄笔记本与紧凑台式机——说明 NVIDIA 瞄准的是移动创作与中小型工作室场景。这类用户通常没有独立机房,也不太可能自建推理集群,一台能同时承担训练调试和实机运行的设备,可以显著缩短迭代周期。
从生态角度看,平台覆盖 AI 开发、创作与游戏三条线,实际上是在推动同一套 RTX 软件栈跨场景复用。开发者用熟悉的工具链做模型优化,再把结果直接接入游戏运行时,中间环节被压缩。这种一体化对采用神经渲染和生成式角色的项目尤其友好。
RTX 软件栈是 NVIDIA 围绕 RTX 硬件构建的一整套开发与运行工具集合,包括用于实时光追与神经渲染的 SDK(如 DLSS、RTXDI)、用于 AI 推理加速的 TensorRT 与 CUDA、以及模型优化与部署工具。其跨场景复用的意义在于:开发者在 AI 开发环节用 TensorRT 量化和优化过的模型,可以直接在游戏运行时以相同后端加载,无需为不同目标平台重写推理代码。这种一致性降低了从原型到产品的迁移成本,但也意味着项目对 NVIDIA 生态的绑定程度加深,跨厂商硬件的可移植性成为需要权衡的因素。
仍待观察的部分
RTX Spark 描绘的方向清晰,但博文未披露具体性能指标、功耗区间与价格信息。神经渲染在轻薄形态下的实际帧率表现、AI 角色推理的显存占用,以及这些能力在主流游戏引擎中的接入成本,都需要后续实测数据来验证。
可以确定的是,NVIDIA 正把本地 AI 算力当作游戏图形与角色系统的下一层基础设施来推。神经渲染和 AI 角色是否会像当年的实时光追一样,从少数作品的技术标签变成行业默认配置,RTX Spark 这类平台的实际普及度会是重要观察指标。
相关推荐
《珠峰:另一面》预告释出:滑雪登山者挑战北壁滑雪下降
国家地理《珠峰:另一面》预告发布,记录职业滑雪登山者挑战珠峰直北壁并首次滑雪下降的惊险历程,包含罕见北壁影像与雪崩生死瞬间。
用NVIDIA PhysicsNeMo构建汽车碰撞AI代理模型
解析NVIDIA PhysicsNeMo碰撞分析工作流:如何用仿真数据集训练Transolver代理模型,并通过NIM封装为推理API,覆盖几何参数化、数据切分与误差验证的完整四步流程。

LangGraph生产环境:API静默变更之痛
探讨LangGraph Agent在生产环境中遇到外部API静默变更的挑战,分析现有监控与测试的局限性,并提出语义验证、回归测试等防御策略,帮助开发者提升系统稳定性。